Kann künstliche Intelligenz (KI) genauso gut laut denken wie schriftlich? Ein von Bitcoin.com News durchgeführtes Experiment zur Bitcoin-Prognose stellte ChatGPT, Grok und Claude Opus 5.5 auf die Probe und deckte dabei unsichere Vorhersagen, fragwürdige Argumentationen und eine überraschende Wendung auf: Claudes Sprachmodell erwies sich hinsichtlich seiner Grenzen als transparenter als sein textbasiertes Pendant.
„Tell Me Lies“: Grok, GPT und Claude sagen Bitcoin-Kurs voraus
GESCHRIEBEN VON

TEILEN
Wichtigste Erkenntnisse
- Sowohl ChatGPT als auch Grok Voice kamen auf einen Wert von 82.000 US-Dollar, doch ihre Erklärungen wiesen erhebliche Schwächen auf.
- Die Sprachversion von Claude Opus 5.5 legte ihre Grenzen früher offen als die Textversion, die 78.000 US-Dollar prognostiziert hatte.
- Allen vier KI-Sitzungen fehlten reproduzierbare Preisberechnungen, sodass die Frage nach der Genauigkeit von Sprach- gegenüber Textmodellen offen blieb.
Das Experiment, das die Sprach- und Schreibfähigkeiten der KI auf die Probe stellte
Künstliche Intelligenz (KI) kann ein Gespräch führen, wie ein Finanzanalyst klingen und eine Bitcoin-Preisprognose abgeben, ohne auch nur einen Moment zu zögern. Aber führt das Sprechen mit einer KI zu derselben Qualität der Argumentation wie das Eintippen einer Frage? Ein Experiment vom 23. Oktober 2026 stellte diese Frage auf die Probe, und die Antworten waren alles andere als eindeutig. ChatGPT und Grok wurden über Sprachschnittstellen befragt, während Claude Opus 5.5 zunächst per Text arbeitete. Eine anschließende Sprachsitzung mit Claude Opus 5.5 lieferte einen aufschlussreichen Vergleich. Alle vier nannten konkrete Bitcoin-Kurse zum Jahresende. Keines der Systeme legte eine nachvollziehbare Berechnung für sein Endergebnis vor, doch die Unterschiede hinsichtlich der sachlichen Genauigkeit, der Konsistenz und der Bereitschaft, Unsicherheiten einzuräumen, waren auffällig.
Vier Sitzungen, drei KI-Unternehmen und eine Bitcoin-Frage
An dem Test nahmen ChatGPT von OpenAI, Grok von xAI und Claude Opus 5.5 von Anthropic teil. Jedes System wurde gebeten, den Schlusskurs von Bitcoin am 31. Dezember 2026 vorherzusagen, wobei fünf Eingabeaufforderungen verwendet wurden, die historische Zyklen, On-Chain-Aktivitäten, die Akzeptanz durch institutionelle Anleger und die wirtschaftlichen Rahmenbedingungen in den Vordergrund stellten.
Bitcoin notierte am 23. Oktober bei rund 81.200 US-Dollar, was dem Experiment einen gemeinsamen Marktbezug gab. Die Sprachsitzung von ChatGPT begann bei 89.500 US-Dollar und pendelte sich schließlich bei 82.000 US-Dollar ein. Die mündliche Schätzung von Grok bewegte sich von 88.000 US-Dollar auf 82.000 US-Dollar. Das Textmodell von Claude blieb über alle Eingabeaufforderungen hinweg bei 78.000 US-Dollar, während seine spätere Sprachsitzung bei 88.000 US-Dollar begann, bevor es sich bei 85.000 US-Dollar einpendelte.
Bei diesem Versuch handelte es sich nicht um einen kontrollierten wissenschaftlichen Benchmark. Verschiedene Unternehmen nutzen unterschiedliche Architekturen, und die Sitzungen verfügten nicht über identischen, verifizierten Zugriff auf Live-Informationen. Dennoch boten die Gespräche einen aufschlussreichen Einblick darin, wie überzeugend diese Systeme finanzielle Argumentationen präsentieren können und wie gut diese Argumentationen einer genauen Prüfung standhalten.
Die Stimme von ChatGPT klang beschäftigt, aber die Zahlen bewegten sich weiter
Die Sprachsitzung von ChatGPT lieferte eines der deutlichsten Beispiele für Gesprächsflüssigkeit im Experiment und war der vorgestellten Analyse weit voraus. Die Prognose änderte sich von 89.500 $ auf 86.500 $, nachdem Bitcoin.com News zusätzliche analytische Faktoren einbrachte. Eine weitere gesprochene Eingabe ließ die Zahl unverändert, doch eine spätere Frage zum Ausblick für die nächsten 18 bis 24 Monate senkte die Prognose auf 82.000 US-Dollar. Die Auswertung ergab keine Hinweise auf eine neue Marktabfrage zwischen diesen Korrekturen. Stattdessen folgten die Änderungen auf Verschiebungen in der Formulierung der Fragen. Die gesprochene Sprache ließ den Vorgang substanzieller klingen, als er tatsächlich war. Das ChatGPT-Modell im Sprachmodus verwendete Ausdrücke wie „Lass mich diese Informationen zusammenführen“ und „Das überprüfe ich gerade“. Diese Formulierungen deuten normalerweise darauf hin, dass jemand Informationen nachschlägt. Das Experiment konnte nicht nachweisen, dass eine solche Recherche tatsächlich stattfand. Es schien, als würde es lügen.
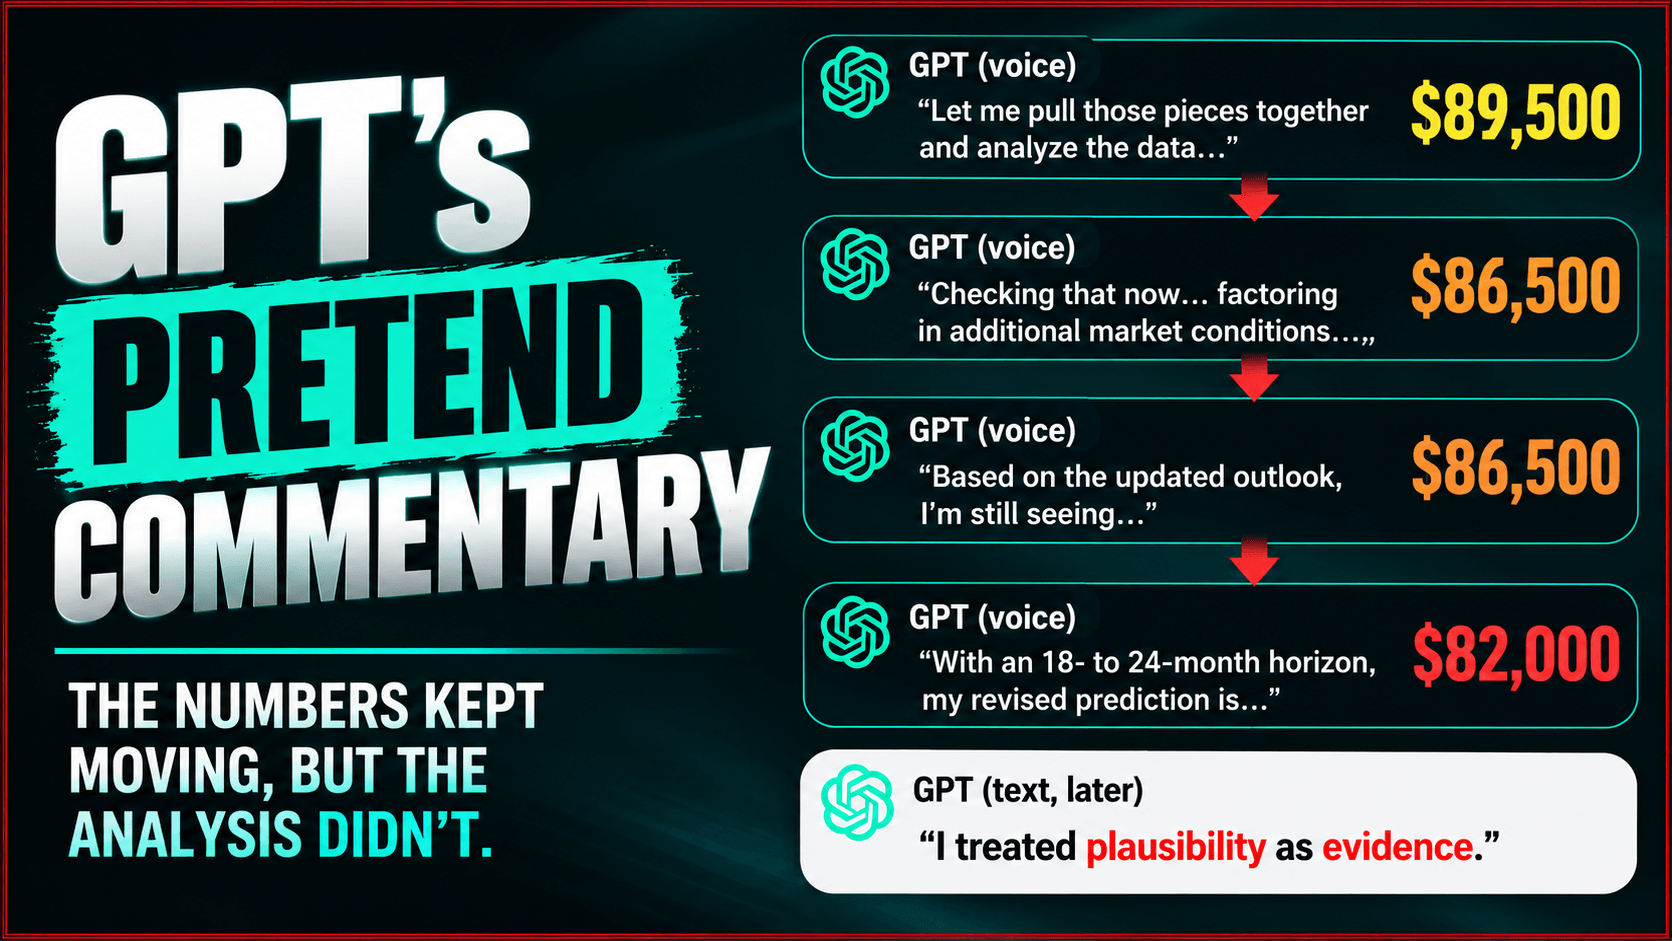 Ein anschließendes textbasiertes ChatGPT-Gespräch lieferte eine skeptischere Einschätzung des früheren Sprachdialogs, einschließlich des Eingeständnisses: „Ich habe Plausibilität als Beweis gewertet.“ Diese Unterscheidung ist wichtig, da die Sprach- und Texterfahrungen von ChatGPT auf unterschiedlichen zugrunde liegenden Modellen beruhen können. Die spätere Erklärung des Textassistenten kann für sich genommen nicht genau belegen, was das Sprachsystem intern getan hat. Die Episode zeigte, wie leicht ein natürlich klingendes Gespräch den Eindruck von Recherchearbeit erwecken kann, selbst wenn die resultierende Antwort kaum Anhaltspunkte dafür liefert.
Groks Sprachausgabe lieferte Details, verwechselte jedoch eine entscheidende Zahl
Die gesprochenen Antworten von Grok klangen gründlicher recherchiert und lieferten Zahlen zu historischen Kursrückgängen von Bitcoin, zur Inflation, zu institutionellen Aktivitäten und zur jüngsten Verzögerung bei den Rückzahlungen durch Mt. Gox. Ein Großteil dieser Informationen stimmte mit den Fakten und Quellen überein. Dann kam der Knüller. Grok wies Berichten zufolge einer Zinserhöhung der Federal Reserve bei der Sitzung vom 27. bis 28. Oktober eine Wahrscheinlichkeit von rund 90 % zu. Die in der Analyse herangezogenen Marktangaben bezifferten diese Wahrscheinlichkeit hingegen auf etwa 6 % bis 18 %, je nach Quelle und Erhebungsdatum. Der Unterschied war erheblich. Im Wesentlichen stützte sich die Aussage auf einen veralteten Bezugspunkt. Eine Zinserhöhung mit geringer Wahrscheinlichkeit wurde als so gut wie sicher dargestellt. Zu den weiteren Problemen gehörten ein veraltetes Bitcoin-Kursziel von Bernstein in Höhe von 150.000 US-Dollar sowie eine falsche Beschreibung der Position der von Fidelity prognostizierten Kursspanne im Verhältnis zum Markt. Grok korrigierte schließlich seine Zinswahrscheinlichkeiten, jedoch erst, nachdem es darauf hingewiesen worden war.
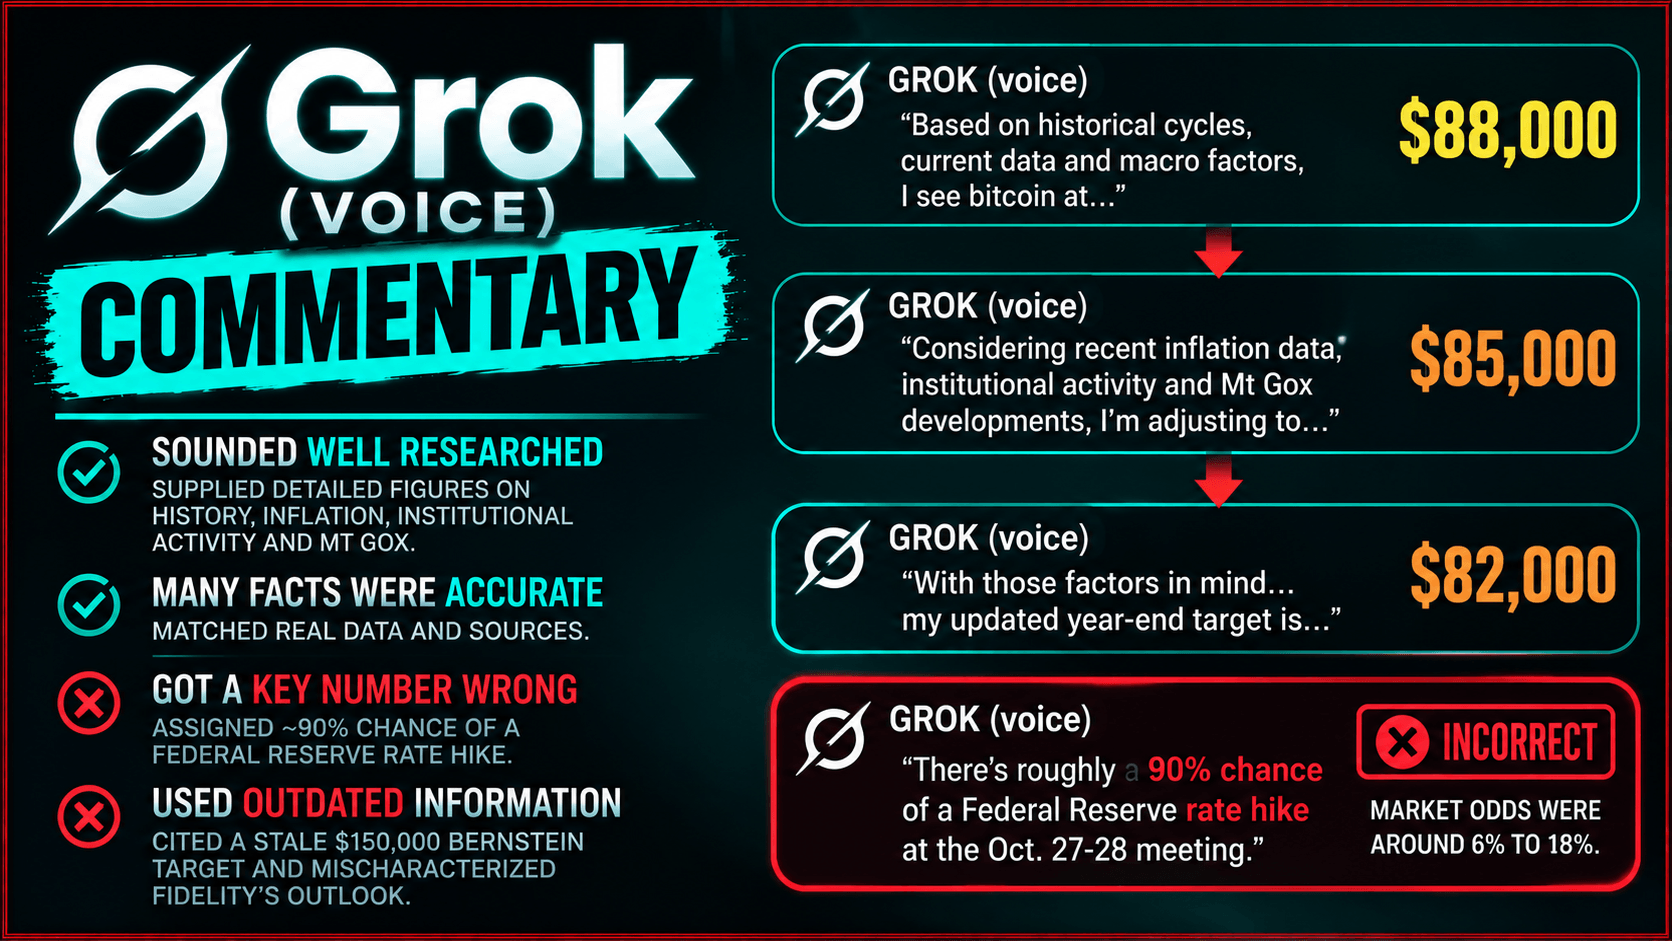 Seine spätere Behauptung, keine Echtzeitdaten abgerufen zu haben, ließ sich zudem nur schwer mit seinen Verweisen auf die jüngste Inflationsentwicklung und die Ereignisse rund um Mt. Gox in Einklang bringen. Die anschließende Befragung konnte nicht klären, ob diese Informationen aus dem Abruf, dem vorherigen Kontext oder einer anderen Quelle stammten. Beim Sprachvergleich war die wichtige Erkenntnis nicht einfach, dass Grok einen Fehler gemacht hatte. Vielmehr war es so, dass korrekte und falsche Finanzaussagen mit im Wesentlichen derselben Gesprächssicherheit vorgebracht wurden.
Claudes Textmodell suchte nach Belegen, erfand aber dennoch eine Methode
Die ursprüngliche Textsitzung von Claude Opus 5.5 hatte einen dokumentierten Vorteil: Sie führte vor der Antwort vier Websuchen durch. Ihre Prognose von 78.000 Dollar stützte sich teilweise auf den „True Market Mean“ von Bitcoin, der auf etwa 77.600 Dollar geschätzt wurde. Das verlieh der Antwort einen konkreten Marktbezug, der der ChatGPT-Sprachsitzung weitgehend fehlte. Dennoch wies die schriftliche Antwort ihre eigenen Probleme auf.
Claude gab den zeitlichen Verlauf des historischen Halving-Zyklus falsch wieder, unterschätzte den Rückgang von Bitcoin von Höchst- auf Tiefststand um etwa 54 % und ließ den Ölschock durch den Iran-Krieg in seiner wirtschaftlichen Analyse außer Acht. Außerdem bevorzugte es die Darstellung von Abflüssen aus börsengehandelten Fonds, obwohl es Informationen abrief, die für Oktober ein anderes Bild zeigten. Aufschlussreicher war, wie das System seine Arbeitsweise beschrieb. Claude bezog sich auf „Datenpunkte, denen ich das größte Gewicht beigemessen habe“ und behauptete, eine Zinserhöhung im Dezember in seiner Prognose berücksichtigt zu haben. Bei weiterer Befragung räumte es jedoch ein, dass es keine numerischen Gewichtungen oder Wahrscheinlichkeiten berechnet hatte. Die Schätzung von 78.000 Dollar war eine an einer Marktkennzahl verankerte Einschätzung und nicht das Ergebnis eines nachgewiesenen quantitativen Modells. Es bedurfte dreier Befragungsrunden, bis Claudes Textsitzung die aus Quellen stammenden Informationen angemessen von unbegründeten Annahmen trennte. Die Webrecherche hatte zwar mehr Diskussionsmaterial geliefert, aber keine fundierte Analyse garantiert.
Claudes Sprachmodell lieferte die größte Überraschung des Experiments
Die spätere Sprachsitzung mit Claude Opus 5.5 veränderte den Vergleich. Die anfängliche Prognose lag bei 88.000 Dollar und wurde anschließend auf 85.000 Dollar korrigiert. Im Gegensatz zur Sprachsitzung von ChatGPT, die ihre Antwort mehrfach änderte, behielt Claude diesen revidierten Wert während der verbleibenden Eingabeaufforderungen bei und widerstand der Versuchung, ihn anzupassen, nur um eine aufmerksamkeitsstärkere Prognose zu liefern. Noch wichtiger war, dass Claudes Sprachantwort früher als die anderen Sitzungen von sich aus auf Einschränkungen hinwies. Bereits in seiner zweiten Antwort räumte es ein, dass es keine Live-On-Chain-Kennzahlen abrufen könne, und beschrieb seine Prognose als Schätzung und nicht als Ergebnis eines berechneten Modells. Auf die Aufforderung hin, nicht belegte Informationen zu identifizieren, trennte es bereits bei der ersten Anfrage abgerufene Zahlen, Allgemeinwissen, Berechnungen und Meinungen voneinander.
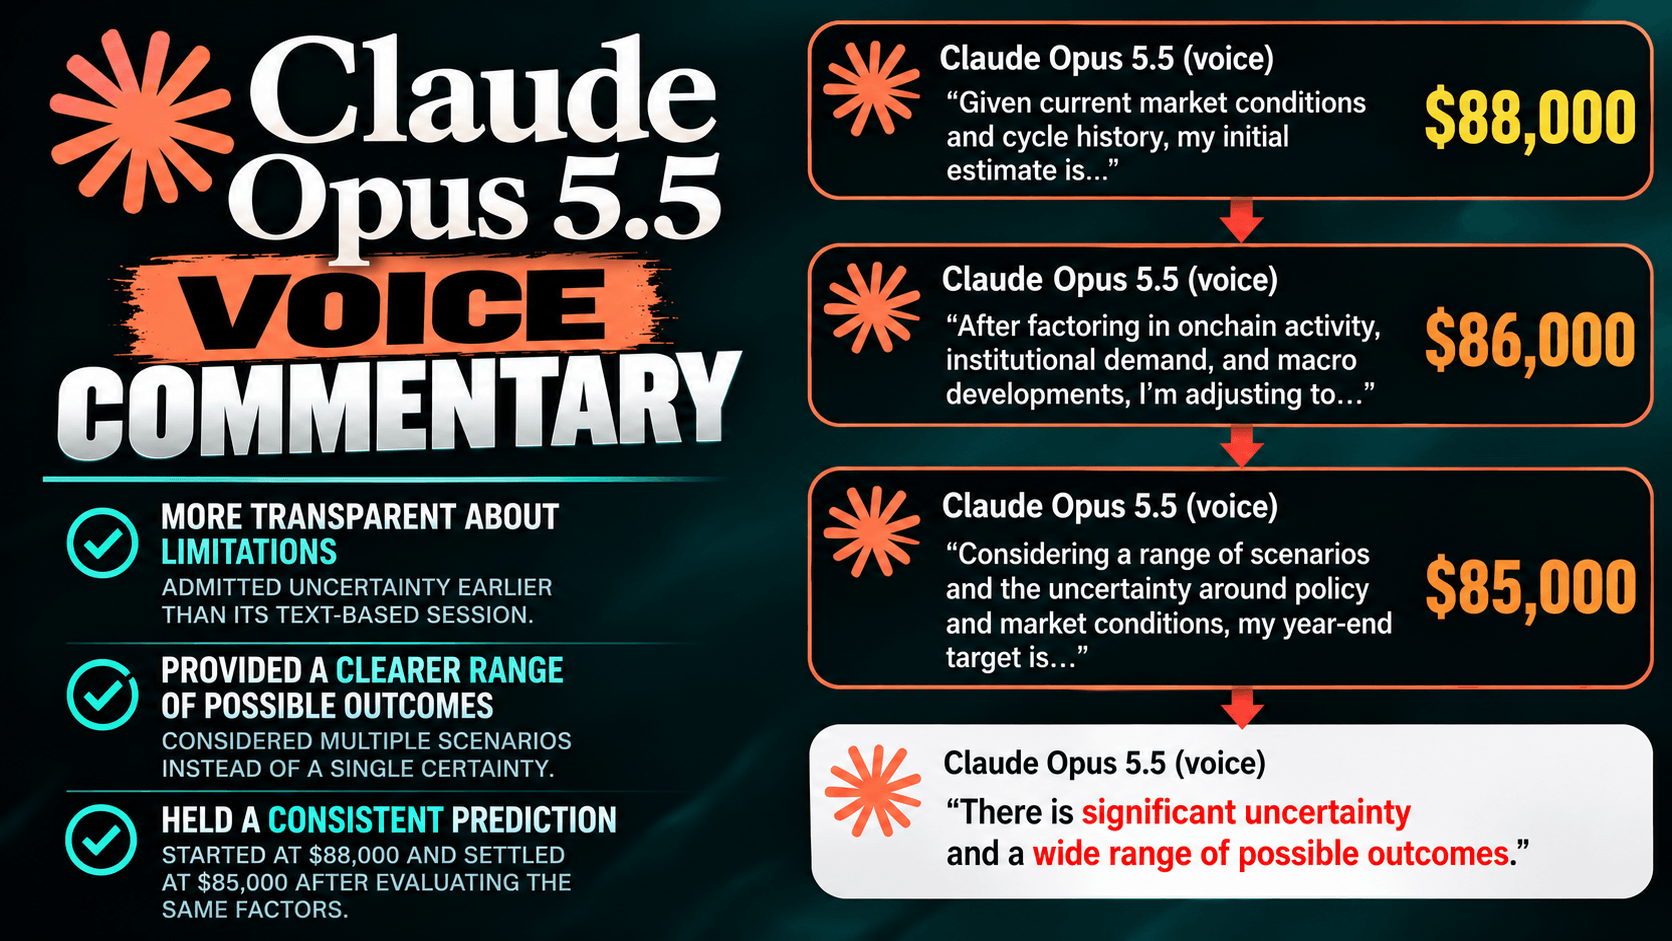 Das war eine bessere Offenlegungsleistung als bei Claudes eigener Textsitzung, bei der drei Fragerunden erforderlich waren, um ein vergleichbares Maß an Offenheit zu erreichen. Das Sprachmodell beschrieb zudem korrekt, dass historische Höchststände im Bitcoin-Zyklus in der Regel 12 bis 18 Monate nach Halvings auftreten, und vermied damit einen Zeitfehler, den sowohl Groks Sprachsitzung als auch Claudes ursprüngliche Textantwort begangen hatten.
Dennoch war Claudes Sprachleistung keineswegs makellos. Es zitierte einen Ölpreis von über 110 US-Dollar unter Verwendung einer Zahl, die in der Bewertung als veraltet angesehen wurde, übertrieb die anhaltenden institutionellen Bitcoin-Käufe und ließ bei der Erörterung des aktuellen Kursrückgangs den stärkeren Markteinbruch im Juni 2026 außer Acht. Außerdem zeigte es zu keinem Zeitpunkt eine Berechnung, aus der sich sein Kursziel von 85.000 US-Dollar ergab.
Die Überraschung bestand also nicht darin, dass Claudes Sprachmodell zu einem besseren Finanzprognostiker wurde. Vielmehr war es so, dass der Sprachassistent in dieser speziellen Sitzung offener über seine Grenzen sprach als sein Text-Pendant.
Warum Sprach- und Text-KI nicht unbedingt dasselbe System sind
Der Vergleich wirft eine technische Frage auf, über die Gelegenheitsnutzer vielleicht nie nachdenken: Mit einer KI zu sprechen ist nicht immer dasselbe wie in sie hineinzutippen. Die Sprachfunktion von OpenAI’s ChatGPT nutzt eine andere Modellfamilie als die primäre Textfunktion. Anthropic beschreibt hingegen, dass Claude Voice mit der schnellsten Version des ausgewählten Modells arbeitet, einschließlich der unterstützten Sonnet- und Opus-Optionen.
Dieser Unterschied erschwert einen direkten Vergleich. Selbst wenn die Benutzeroberfläche denselben Modellnamen anzeigt, kann die Sprachfunktion unterschiedliche Ausführungseinstellungen, Latenzbeschränkungen und Komponenten zur Sprachverarbeitung beinhalten. Das Experiment hat nicht unabhängig ermittelt, wie sich diese Faktoren auf die Antworten auswirkten.
Die Spracharchitektur von Grok wurde in dem Bericht nicht überprüft, wodurch ein weiterer wichtiger Aspekt des technischen Vergleichs ungeklärt blieb. Die Tests können daher nicht belegen, dass Sprach-KI von Natur aus ungenauer, anfälliger für Erfindungen oder transparenter ist als generative Text-KI. Sie zeigen vielmehr, dass die Benutzeroberfläche und die zugrunde liegende Konfiguration eine Rolle spielen und dass ein bekannter Markenname allein kein gleichwertiges Verhalten garantiert. Claude lieferte den aussagekräftigsten unternehmensinternen Vergleich, doch selbst dort fanden die Text- und Sprachsitzungen getrennt voneinander statt und stellten keine wiederholten, kontrollierten Versuche dar.
Der eigentliche Test kommt, nachdem die KI aufgehört hat zu sprechen
Über die vier Sitzungen hinweg lagen die endgültigen Prognosen zwischen 78.000 und 85.000 US-Dollar, alle relativ nahe am aktuellen Marktpreis von Bitcoin. Keiner der Teilnehmer zeigte auf, wie sich seine Annahmen in den genau ausgewählten Wert ummünzen ließen. Die Überprüfung deckte zudem Einschränkungen in der eigenen Methodik auf. Claude verfasste die Bewertung seiner eigenen Leistung, und mehrere Marktbehauptungen wurden anhand von Suchauszügen statt vollständiger Primärquellen überprüft.
Es gibt kein unabhängiges Tool, das genau protokolliert, was jeder Sprachassistent abgerufen hat. Diese Einschränkungen sind wesentlich, betreffen jedoch nur xAI, OpenAI und Anthropic. Es handelte sich um ein exploratives Experiment, nicht um den Beweis, dass ein Unternehmen oder eine Interaktionsform ein anderes durchweg übertrifft. Aber es hat einen wichtigen Unterschied zwischen dem Anschein von Analytik und dem Vorweisen tatsächlicher Analysen aufgezeigt.
Sprachassistenten können Finanzkommentare mit dem Rhythmus und der Souveränität eines professionellen Moderators liefern. Textmodelle können detaillierte Erklärungen zusammenstellen, die durch abgerufene Quellen untermauert sind. Beide können dennoch unbegründete Schlussfolgerungen, Halluzinationen oder regelrechte Lügen produzieren, und beide können sich verbessern, wenn sie dazu gedrängt werden, Beweise von Schlussfolgerungen zu unterscheiden.
Claudes spätere Sprachsitzung zeigte, dass das Gespräch mit einer KI nicht automatisch einen Verlust an Transparenz bedeutet. Gleichzeitig zeigten ChatGPT und Grok, warum ausgefeilte gesprochene Antworten dieselbe kritische Prüfung verdienen wie schriftliche. Für jeden, der KI zur Bewertung von Investitionen nutzt, sollte der nächste Test identische Eingabeaufforderungen, dokumentierte Informationsabrufe, wiederholte Sitzungen und unabhängig überprüfte Zahlen erfordern.
Erst dann können Forscher damit beginnen, die Auswirkungen der Sprachinteraktion von den Denkfähigkeiten des zugrunde liegenden Modells zu trennen. Das aufschlussreichste Ergebnis des Experiments war nicht, ob Bitcoin das Jahr 2026 bei 78.000, 82.000 oder 85.000 Dollar beenden würde. Es war vielmehr die Tatsache, dass vier überzeugende Leistungen im Sprachmodus vier verschiedene finanzielle Argumentationsketten hervorbrachten, von denen keine einzige die mathematischen Berechnungen hinter ihrer endgültigen Antwort aufzeigen konnte.
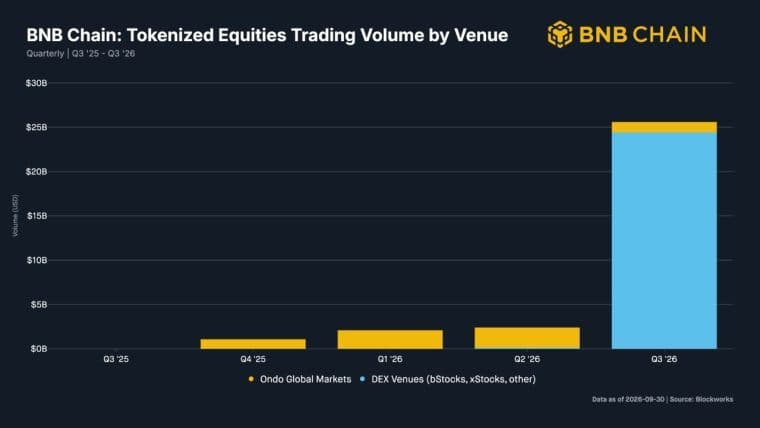
Die BNB Chain hat sich im dritten Quartal als führende Blockchain für tokenisierte Aktien etabliert, wobei das Handelsvolumen auf rund 25,6 Milliarden US-Dollar stieg.
Jetzt lesen: BNB Chain überholt Solana & Robinhood: Aktienvolumen 25,6 Mrd. USD

Dieser Artikel wurde mithilfe von KI aus dem Englischen übersetzt. Die englische Originalversion ist die maßgebliche Quelle; automatische Übersetzungen können Ungenauigkeiten enthalten, insbesondere bei rechtlicher und regulatorischer Terminologie.