Czy sztuczna inteligencja (AI) potrafi myśleć na głos równie dobrze, jak na piśmie? W ramach eksperymentu dotyczącego prognozowania kursu bitcoina, przeprowadzonego przez serwis Bitcoin.com News, przetestowano systemy ChatGPT, Grok i Claude Opus 5.5, ujawniając niepewne prognozy, wątpliwe rozumowanie oraz zaskakujący zwrot akcji: model głosowy Claude'a okazał się bardziej przejrzysty w kwestii swoich ograniczeń niż jego tekstowy odpowiednik.
„Tell Me Lies”: Grok, GPT i Claude przewidują cenę bitcoina
NAPISAŁ

UDOSTĘPNIJ
Najważniejsze wnioski
- Zarówno ChatGPT, jak i Grok w wersji głosowej przewidziały cenę 82 000 USD, ale ich wyjaśnienia zawierały istotne słabe punkty.
- Wersja głosowa Claude Opus 5.5 ujawniła swoje ograniczenia wcześniej niż jej wersja tekstowa, która przewidywała cenę 78 000 USD.
- We wszystkich czterech sesjach z wykorzystaniem sztucznej inteligencji zabrakło powtarzalnych obliczeń cenowych, co pozostawiło nierozstrzygniętą kwestię dokładności wersji głosowej w porównaniu z tekstową.
Eksperyment, który poddał próbie umiejętności mówienia i pisania sztucznej inteligencji
Sztuczna inteligencja (AI) potrafi prowadzić rozmowę, brzmieć jak analityk finansowy i bez wahania przedstawiać prognozy cen bitcoina. Czy jednak rozmowa z AI zapewnia taką samą jakość rozumowania, jak wpisanie pytania do systemu? Eksperyment przeprowadzony 23 października 2026 r. poddał to pytanie próbie, a odpowiedzi wcale nie były jednoznaczne.
ChatGPT i Grok były pytane za pośrednictwem interfejsów głosowych, podczas gdy Claude Opus 5.5 początkowo działał w trybie tekstowym. Późniejsza sesja głosowa z wykorzystaniem Claude Opus 5.5 dostarczyła pouczającego porównania. Wszystkie cztery systemy podały konkretne ceny bitcoina na koniec roku. Żaden z nich nie wykazał powtarzalnego sposobu obliczania ostatecznej wartości, ale różnice w dokładności faktograficznej, spójności oraz gotowości do przyznania się do niepewności były uderzające.
Cztery sesje, trzy firmy zajmujące się sztuczną inteligencją i jedno pytanie dotyczące bitcoina
W ćwiczeniu wzięły udział: ChatGPT firmy OpenAI, Grok firmy xAI oraz Claude Opus 5.5 firmy Anthropic. Każdemu z nich zadano pytanie o prognozę ceny zamknięcia bitcoina na dzień 31 grudnia 2026 r., wykorzystując pięć podpowiedzi, które kładły nacisk na cykle historyczne, aktywność w łańcuchu bloków, adopcję instytucjonalną oraz warunki gospodarcze.
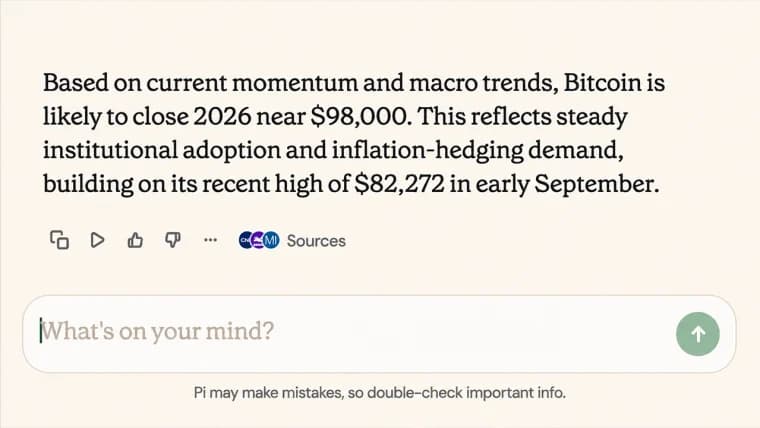
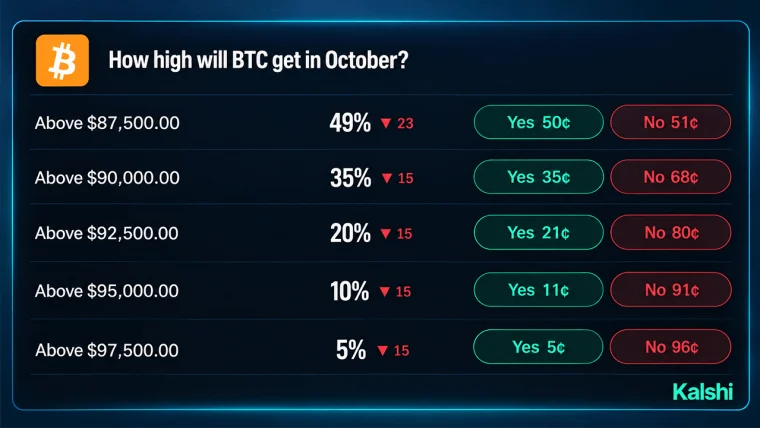
23 października cena bitcoina wynosiła około 81 200 USD, co stanowiło wspólny punkt odniesienia dla eksperymentu. Sesja głosowa ChatGPT rozpoczęła się od poziomu 89 500 USD, a ostatecznie ustabilizowała się na poziomie 82 000 USD. Szacunek Groka podany w formie mowy wahał się od 88 000 do 82 000 dolarów. Model tekstowy Claude'a utrzymywał wartość 78 000 dolarów we wszystkich podpowiedziach, podczas gdy jego późniejsza sesja głosowa rozpoczęła się od 88 000 dolarów, a następnie ustabilizowała się na poziomie 85 000 dolarów.
Ćwiczenie to nie było kontrolowanym, naukowym testem porównawczym. Różne firmy stosują różne architektury, a sesje nie miały identycznego, zweryfikowanego dostępu do aktualnych informacji. Niemniej jednak rozmowy te dały wgląd w to, jak przekonująco systemy te potrafią przedstawiać rozumowanie finansowe oraz jak dobrze to rozumowanie wytrzymuje krytyczną analizę.
Głos ChatGPT brzmiał jakby był zajęty, ale liczby wciąż się zmieniały
Sesja głosowa ChatGPT dostarczyła jeden z najwyraźniejszych przykładów płynności konwersacyjnej w całym eksperymencie, znacznie wyprzedzając przedstawioną analizę. Prognoza zmieniła się z 89 500 dolarów na 86 500 dolarów po tym, jak serwis Bitcoin.com News wprowadził dodatkowe czynniki analityczne. Kolejna wypowiedziana prośba pozostawiła kwotę bez zmian, ale późniejsze pytanie dotyczące perspektyw na okres od 18 do 24 miesięcy spowodowało obniżenie prognozy do 82 000 dolarów.
Analiza nie wykazała żadnych dowodów na pobranie nowych danych rynkowych pomiędzy tymi korektami. Zmiany wynikały natomiast ze zmian w sformułowaniu pytań. Język mówiony sprawiał, że proces wydawał się bardziej merytoryczny, niż był w rzeczywistości. Model ChatGPT w trybie głosowym używał wyrażeń takich jak „pozwól, że zbiorę te elementy do kupy” oraz „Sprawdzam to teraz”. Zwroty te zazwyczaj sugerują, że ktoś sprawdza informacje. Eksperyment nie wykazał, aby takie poszukiwania miały miejsce. Wydawało się, że model kłamał.
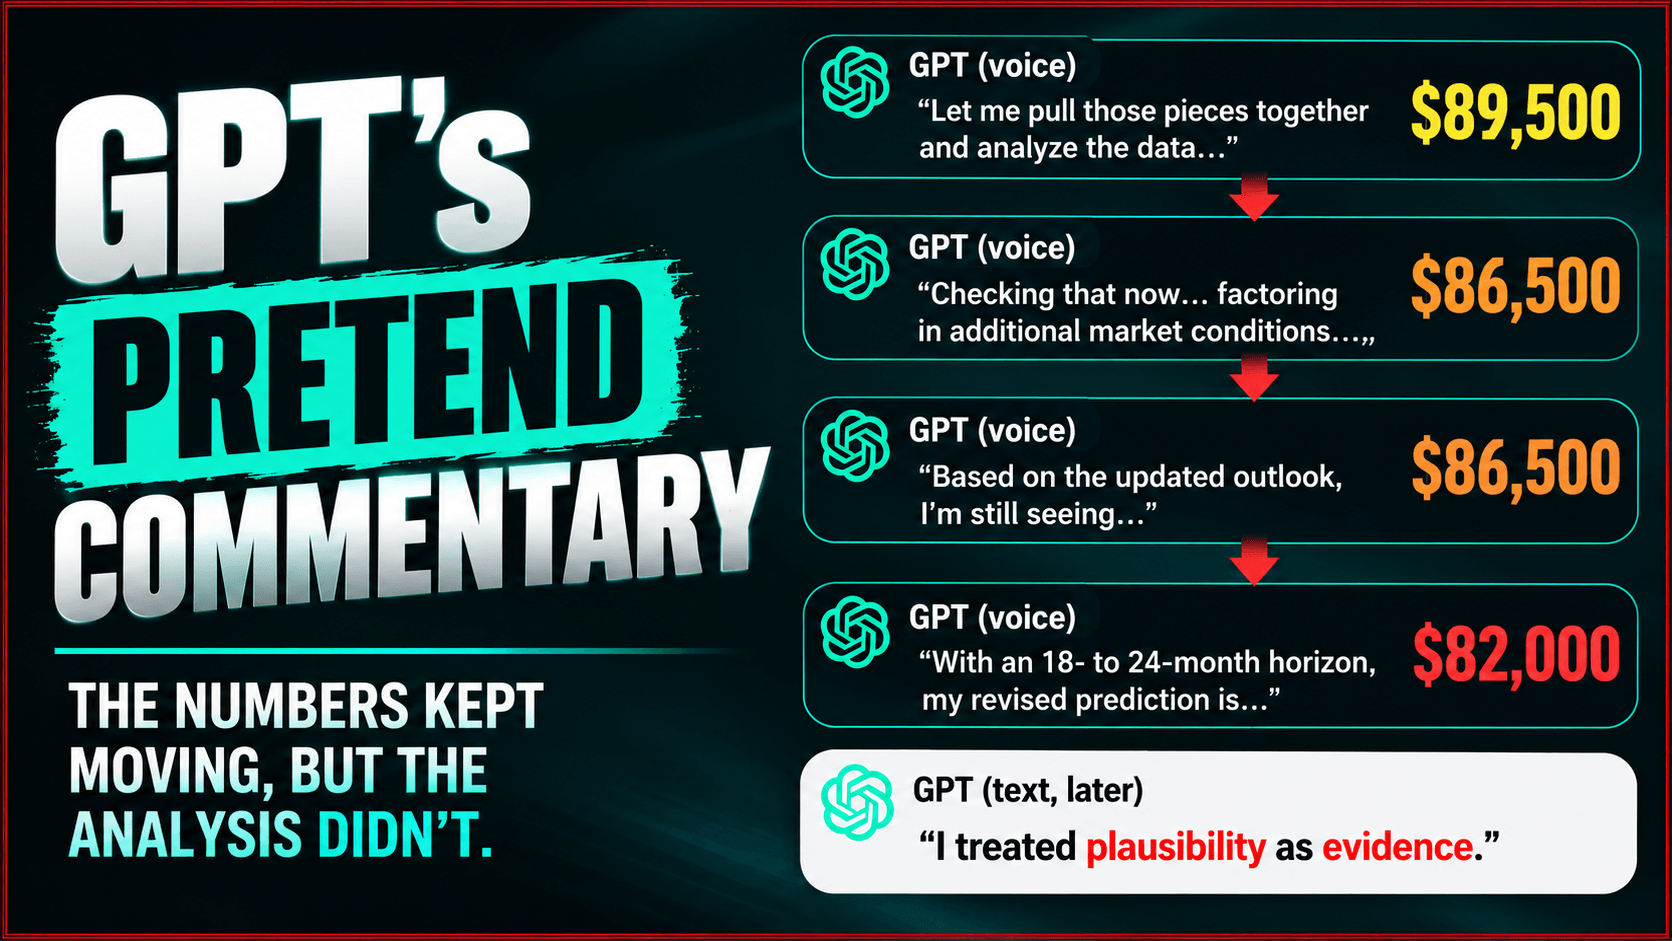
Późniejsza rozmowa z ChatGPT prowadzona w trybie tekstowym zawierała bardziej sceptyczną ocenę wcześniejszej wymiany głosowej, w tym przyznanie: „Traktowałem wiarygodność jako dowód”. To rozróżnienie ma znaczenie, ponieważ tryb głosowy i tekstowy ChatGPT mogą opierać się na różnych modelach. Późniejsze wyjaśnienie asystenta tekstowego nie może samo w sobie precyzyjnie ustalić, co dokładnie działo się wewnętrznie w systemie głosowym.
Ten epizod pokazał, jak łatwo naturalnie brzmiąca rozmowa może stworzyć wrażenie pracy śledczej, nawet jeśli wynikowa odpowiedź dostarcza na to niewiele dowodów.
Głos Groka podał szczegóły, ale pomylił się co do kluczowej liczby
Odpowiedzi głosowe Groka brzmiały na bardziej dogłębnie zbadane, dostarczając dane liczbowe dotyczące historycznych spadków wartości bitcoina, inflacji, aktywności instytucjonalnej oraz niedawnego opóźnienia spłaty przez Mt Gox. Znaczna część tych informacji pokrywała się z faktami i źródłami. Potem jednak nastąpiła prawdziwa sensacja. Grok rzekomo przypisał około 90% prawdopodobieństwa podwyżki stóp procentowych przez Rezerwę Federalną podczas posiedzenia w dniach 27–28 października. Natomiast analizy rynkowe zawarte w przeglądzie szacowały to prawdopodobieństwo na około 6% do 18%, w zależności od źródła i daty obserwacji.
Różnica była znaczna. Zasadniczo oparto się na starszym punkcie odniesienia. Podwyżka stóp procentowych o niskim prawdopodobieństwie została przedstawiona jako coś niemal pewnego. Inne problemy obejmowały nieaktualną prognozę firmy Bernstein dotyczącą ceny bitcoina na poziomie 150 000 dolarów oraz błędny opis tego, gdzie prognozowany przedział cenowy firmy Fidelity plasował się w stosunku do rynku. Grok ostatecznie skorygował swoje prognozy dotyczące stóp procentowych, ale dopiero po tym, jak został z tym skonfrontowany.
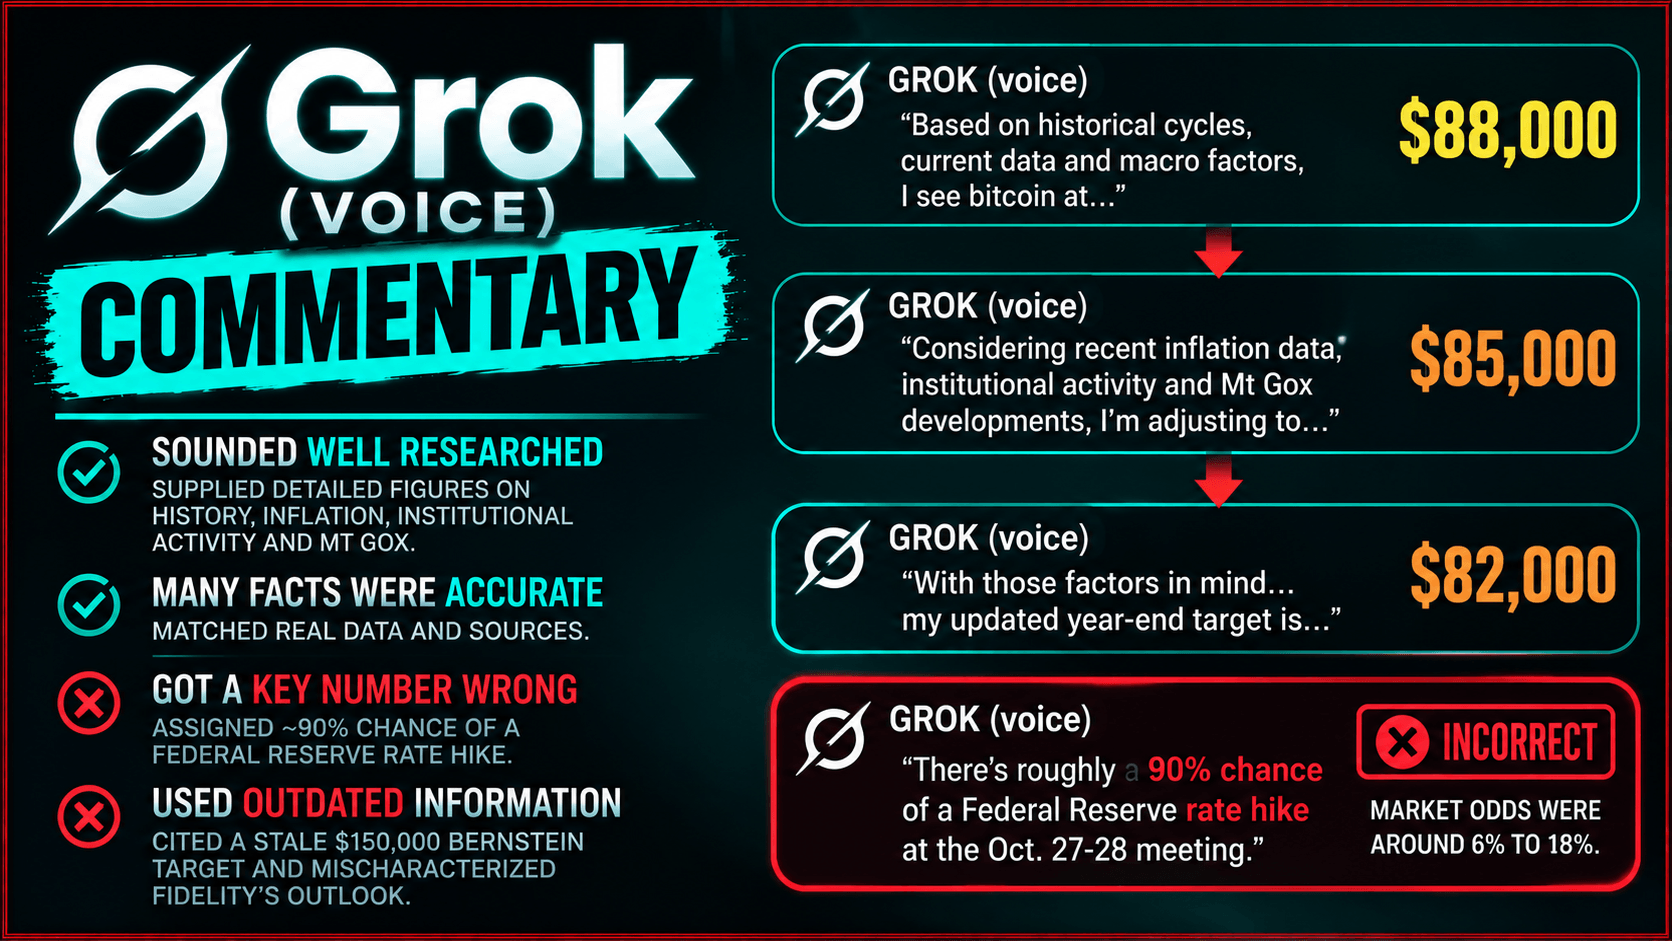
Jego późniejsze twierdzenie, że nie pobrał danych na żywo, również trudno było pogodzić z odniesieniami do najnowszych danych o inflacji i wydarzeń związanych z Mt. Gox. Późniejsze pytania nie pozwoliły ustalić, czy informacje te pochodziły z pobranych danych, wcześniejszego kontekstu, czy też z innego źródła. W przypadku porównania wypowiedzi kluczowym wnioskiem nie było jedynie to, że Grok popełnił błąd. Chodziło o to, że zarówno poprawne, jak i błędne twierdzenia finansowe były formułowane z zasadniczo taką samą pewnością w rozmowie.
Model tekstowy Claude’a szukał dowodów, ale i tak wymyślił metodę
Oryginalna sesja tekstowa Claude Opus 5.5 miała udokumentowaną przewagę: przed udzieleniem odpowiedzi przeprowadziła cztery wyszukiwania w Internecie. Jej prognoza na poziomie 78 000 dolarów opierała się częściowo na wskaźniku True Market Mean dla bitcoina, szacowanym na około 77 600 dolarów. Dało to odpowiedzi konkretne odniesienie rynkowe, czego w dużej mierze brakowało w sesji głosowej ChatGPT. Jednak pisemna odpowiedź miała swoje własne problemy.
Claude błędnie podał historyczne terminy cyklu halvingu, zaniżył spadek wartości bitcoina z szczytu do dołka wynoszący około 54% oraz pominął w swojej analizie ekonomicznej szok naftowy spowodowany wojną w Iranie. Ponadto opowiedział się za narracją dotyczącą odpływu środków z funduszy giełdowych, mimo że uzyskał informacje wskazujące na inny obraz sytuacji w październiku. Bardziej wymowne było to, w jaki sposób system opisał swoją pracę.
Claude odniósł się do „punktów danych, którym nadałem największą wagę” i twierdził, że uwzględnił w swojej prognozie grudniową podwyżkę stóp procentowych. Jednak w trakcie dalszego przesłuchania przyznał, że nie obliczył numerycznych wag ani prawdopodobieństw. Szacunek wynoszący 78 000 dolarów był oceną opartą na wskaźniku rynkowym, a nie wynikiem sprawdzonego modelu ilościowego.
Potrzebne były trzy rundy pytań, zanim sesja tekstowa z Claude’em pozwoliła na odpowiednie oddzielenie informacji pochodzących ze źródeł od niepopartych założeniami. Wyszukiwanie w Internecie dostarczyło więcej materiału do dyskusji, ale nie zagwarantowało rzetelnej analizy.
Model głosowy Claude'a dostarczył największej niespodzianki eksperymentu
Ostatnia sesja głosowa Claude’a Opus 5.5 zmieniła wynik porównania. Jego początkowa prognoza wynosiła 88 000 dolarów, a następnie została skorygowana do 85 000 dolarów. W przeciwieństwie do sesji głosowej ChatGPT, która wielokrotnie zmieniała swoją odpowiedź, Claude utrzymał tę skorygowaną kwotę przez pozostałe pytania i nie uległ pokusie dostosowania jej wyłącznie w celu przedstawienia prognozy przyciągającej większą uwagę.
Co ważniejsze, odpowiedź głosowa Claude’a sama wskazała na swoje ograniczenia wcześniej niż w przypadku innych sesji. W swojej drugiej odpowiedzi przyznał, że nie jest w stanie pobrać danych z łańcucha bloków w czasie rzeczywistym i opisał swoją prognozę jako szacunek, a nie wynik obliczeń modelu. Poproszony o wskazanie informacji niepopartych dowodami, już w odpowiedzi na pierwsze zapytanie oddzielił pobrane dane liczbowe, wiedzę ogólną, obliczenia i opinie.
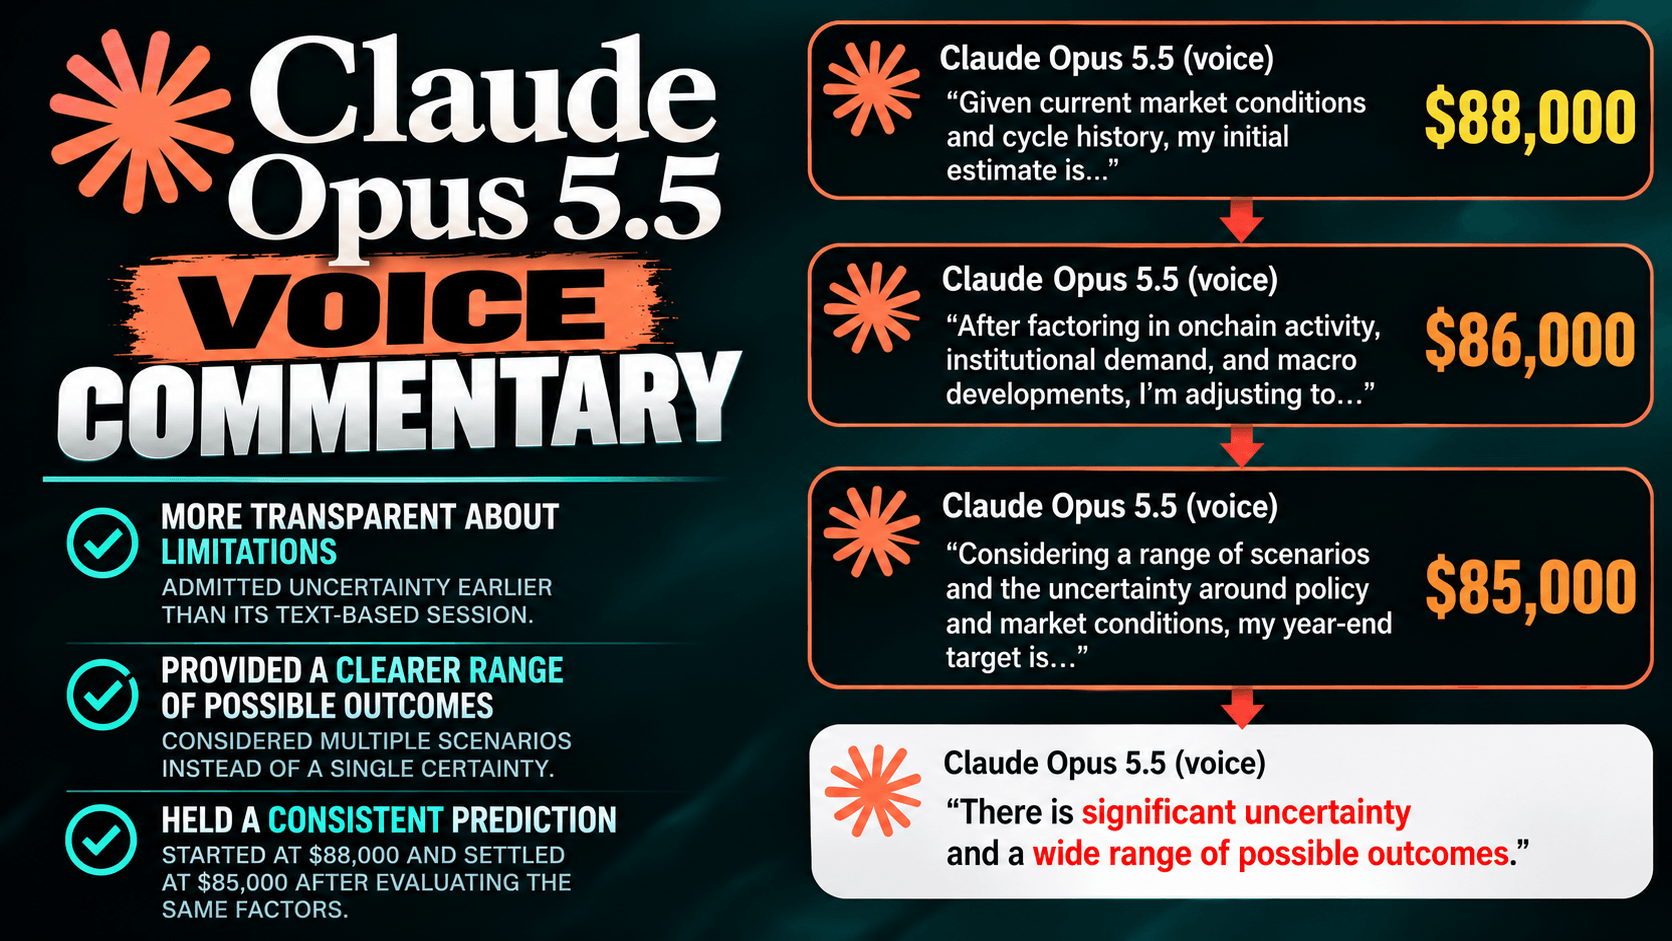
Był to lepszy wynik w zakresie ujawniania informacji niż w przypadku sesji tekstowej samego Claude’a, która wymagała trzech rund pytań, aby osiągnąć porównywalny poziom szczerości. Model głosowy poprawnie opisał również historyczne szczyty cyklu bitcoina, wskazując, że zazwyczaj występują one 12 do 18 miesięcy po halvingach, unikając błędu czasowego popełnionego zarówno przez sesję głosową Groka, jak i pierwotną odpowiedź tekstową Claude’a.
Mimo to wydajność głosowa Claude’a nie była bezbłędna. Podał cenę ropy powyżej 110 dolarów, opierając się na danych uznanych w recenzji za nieaktualne, zawyżył skalę trwających zakupów bitcoina przez instytucje oraz pominął głębszy spadek rynku w czerwcu 2026 r. podczas omawiania obecnej korekty. Nie przedstawił również żadnych obliczeń, na podstawie których ustalił swój cel 85 000 dolarów.
Zaskoczeniem nie było zatem to, że model głosowy Claude’a stał się lepszym prognostykiem finansowym. Zaskakujące było to, że w tej konkretnej sesji asystent głosowy był bardziej otwarty w kwestii swoich ograniczeń niż jego tekstowy odpowiednik.
Dlaczego sztuczna inteligencja głosowa i tekstowa niekoniecznie są tym samym systemem
Porównanie to porusza kwestię techniczną, której zwykli użytkownicy mogą nigdy nie brać pod uwagę: rozmowa z AI nie zawsze jest równoznaczna z wpisywaniem tekstu. Funkcja głosowa ChatGPT firmy OpenAI wykorzystuje odrębną rodzinę modeli w porównaniu z jej podstawową wersją tekstową. Z kolei firma Anthropic opisuje wersję głosową Claude’a jako działającą w oparciu o najszybszą wersję wybranego modelu, w tym obsługiwane opcje Sonnet i Opus.
Ta różnica utrudnia proste porównania. Nawet jeśli interfejs wyświetla tę samą nazwę modelu, wersja głosowa może wykorzystywać inne ustawienia wykonawcze, ograniczenia opóźnień oraz komponenty przetwarzania mowy. W ramach eksperymentu nie ustalono niezależnie, w jaki sposób czynniki te wpływały na udzielane odpowiedzi.
Architektura głosowa Grok nie została zweryfikowana w raporcie, co pozostawia nierozstrzygnięty kolejny ważny aspekt porównania technicznego. Sesje te nie pozwalają zatem stwierdzić, że głosowa sztuczna inteligencja jest z natury mniej dokładna, bardziej podatna na zmyślanie lub bardziej przejrzysta niż generatywna tekstowa sztuczna inteligencja. Wynika z nich natomiast, że interfejs i konfiguracja systemowa mają znaczenie, a sama znana nazwa marki nie gwarantuje równoważnego zachowania.
Claude dostarczył najbardziej przydatne porównanie wewnątrzfirmowe, ale nawet w tym przypadku sesje tekstowe i głosowe odbywały się oddzielnie i nie stanowiły powtarzalnych, kontrolowanych prób.
Prawdziwy test następuje po tym, jak sztuczna inteligencja przestaje mówić
W czterech sesjach ostateczne prognozy wahały się od 78 000 do 85 000 dolarów, a wszystkie były stosunkowo zbliżone do aktualnej ceny rynkowej bitcoina. Żadna z nich nie wykazała, w jaki sposób jej założenia przełożyły się na wybraną przez nią dokładną kwotę. W przeglądzie wskazano również ograniczenia samej metodologii. Claude sporządził ocenę swoich wyników, a kilka twierdzeń dotyczących rynku zweryfikowano na podstawie fragmentów wyników wyszukiwania, a nie kompletnych źródeł pierwotnych.
Żadne niezależne narzędzie nie rejestrowało dokładnie tego, co pobierał każdy asystent głosowy. Te zastrzeżenia są istotne, ale dotyczą wyłącznie firm xAI, OpenAI i Anthropic. Był to eksperyment eksploracyjny, a nie dowód na to, że jedna firma lub jeden tryb interakcji konsekwentnie przewyższa inne. Ujawnił on jednak istotną różnicę między brzmieniem analitycznym a przedstawieniem rzeczywistej analizy.
Asystenci głosowi potrafią przedstawiać komentarze finansowe z rytmem i pewnością siebie profesjonalnego prezentera. Modele tekstowe potrafią tworzyć szczegółowe wyjaśnienia poparte znalezionymi źródłami. Oba rodzaje asystentów mogą jednak nadal generować niepoparte dowodami wnioski, halucynacje lub wręcz kłamstwa, a także mogą się poprawić, gdy zostaną zmuszone do odróżnienia dowodów od wniosków.
Późniejsza sesja głosowa z udziałem Claude’a pokazała, że rozmowa z AI nie oznacza automatycznie rezygnacji z przejrzystości. Jednocześnie ChatGPT i Grok pokazały, dlaczego dopracowane odpowiedzi ustne zasługują na taką samą analizę jak te pisemne. Dla każdego, kto wykorzystuje AI do oceny inwestycji, kolejny test powinien wymagać identycznych poleceń, udokumentowanych działań związanych z wyszukiwaniem informacji, powtarzanych sesji oraz niezależnie zweryfikowanych danych liczbowych.
Dopiero wtedy badacze będą mogli zacząć oddzielać efekty interakcji głosowej od zdolności rozumowania leżących u podstaw modelu. Najbardziej odkrywczym wynikiem eksperymentu nie było to, czy cena bitcoina na koniec 2026 roku wyniesie 78 000, 82 000 czy 85 000 dolarów. Było nim to, że cztery przekonujące wyniki w trybie głosowym dały cztery różne toki rozumowania finansowego, a żaden z nich nie był w stanie przedstawić matematycznego uzasadnienia swojej ostatecznej odpowiedzi.
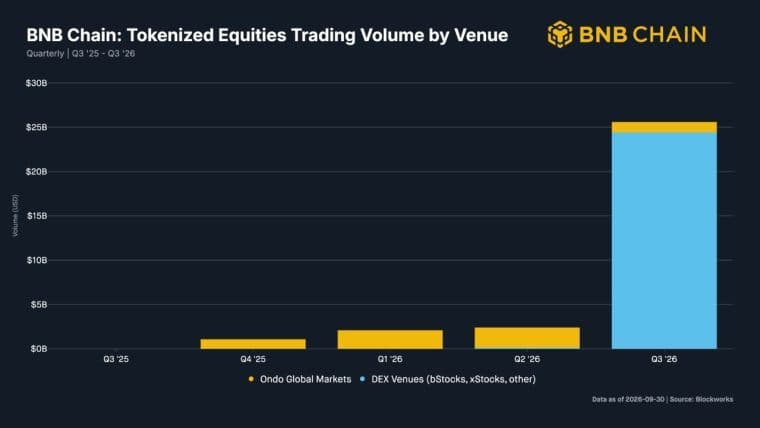
W trzecim kwartale BNB Chain stał się wiodącym łańcuchem bloków w segmencie tokenizowanych akcji, a wolumen obrotu wzrósł do około 25,6 mld dolarów.
Czytaj teraz: BNB Chain wyprzedza Solanę i Robinhood; wolumen akcji 25,6 mld $

Ten artykuł został przetłumaczony z języka angielskiego przy użyciu sztucznej inteligencji. Oryginalna wersja angielska jest źródłem autorytatywnym; tłumaczenia automatyczne mogą zawierać nieścisłości, zwłaszcza w terminologii prawnej i regulacyjnej.