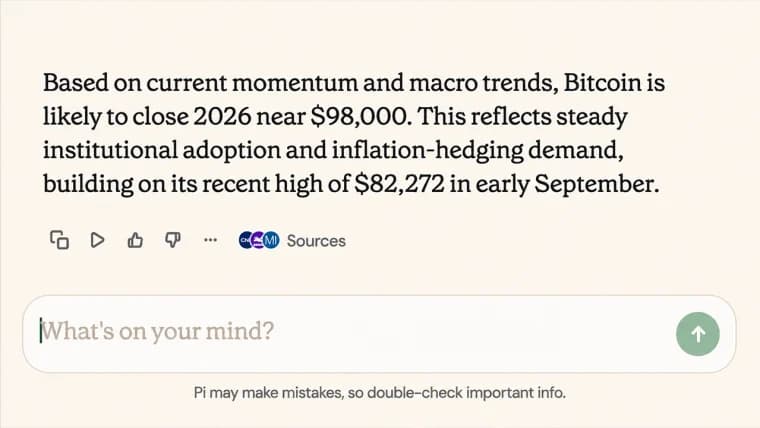
Kan kunstmatige intelligentie (AI) net zo goed hardop denken als op papier? In een door Bitcoin.com News uitgevoerd experiment met bitcoin-voorspellingen werden ChatGPT, Grok en Claude Opus 5.5 aan een test onderworpen. Hieruit kwamen wankele voorspellingen, twijfelachtige redeneringen en een verrassende wending naar voren: het spraakmodel van Claude bleek transparanter over zijn beperkingen dan zijn op tekst gebaseerde tegenhanger.
Tell Me Lies: Grok, GPT en Claude gokken Bitcoin-prijs
GESCHREVEN DOOR

DELEN
Belangrijkste conclusies
- Zowel de spraakversies van ChatGPT als Grok kwamen uit op 82.000 dollar, maar hun uitleg vertoonde belangrijke zwakke punten.
- De spraakversie van Claude Opus 5.5 maakte zijn beperkingen eerder bekend dan de tekstversie, die $78.000 voorspelde.
- Bij alle vier de AI-sessies ontbraken reproduceerbare prijsberekeningen, waardoor de nauwkeurigheid van spraak versus tekst onopgelost bleef.
Het experiment dat de spreek- en typevaardigheden van AI op de proef stelde
Kunstmatige intelligentie (AI) kan een gesprek voeren, klinken als een financieel analist en zonder aarzelen een bitcoin-prijsvoorspelling geven. Maar levert een gesprek met een AI dezelfde kwaliteit van redenering op als het intypen van een vraag? Een experiment op 23 oktober 2026 stelde die vraag op de proef, en de antwoorden waren allesbehalve eenduidig.
ChatGPT en Grok werden via spraakinterfaces ondervraagd, terwijl Claude Opus 5.5 aanvankelijk via tekst werkte. Een daaropvolgende spraaksessie met Claude Opus 5.5 leverde een veelzeggende vergelijking op. Alle vier gaven ze specifieke bitcoin-koersen voor het einde van het jaar. Geen van hen toonde een reproduceerbare berekening achter het uiteindelijke cijfer, maar de verschillen in feitelijke nauwkeurigheid, consistentie en bereidheid om onzekerheid toe te geven waren opvallend.
Vier sessies, drie AI-bedrijven en één vraag over bitcoin
Bij de oefening waren ChatGPT van OpenAI, Grok van xAI en Claude Opus 5.5 van Anthropic betrokken. Elk systeem werd gevraagd de slotkoers van bitcoin op 31 december 2026 te voorspellen aan de hand van vijf prompts die de nadruk legden op historische cycli, on-chain-activiteit, institutionele acceptatie en economische omstandigheden.
Bitcoin noteerde op 23 oktober rond de 81.200 dollar, wat het experiment een gemeenschappelijk marktreferentiepunt gaf. De spraaksessie van ChatGPT begon bij 89.500 dollar en kwam uiteindelijk uit op 82.000 dollar. De gesproken schatting van Grok schommelde tussen $ 88.000 en $ 82.000. Het tekstmodel van Claude hield in al zijn prompts vast aan $ 78.000, terwijl de latere spraaksessie begon bij $ 88.000 en vervolgens uitkwam op $ 85.000.
De oefening was geen gecontroleerde wetenschappelijke benchmark. Verschillende bedrijven gebruiken verschillende architecturen, en de sessies hadden niet allemaal identieke, geverifieerde toegang tot live-informatie. Niettemin boden de gesprekken een onthullend beeld van hoe overtuigend deze systemen financiële redeneringen kunnen presenteren en hoe goed die redeneringen een kritische toetsing doorstaan.
De stem van ChatGPT klonk druk, maar de cijfers bleven veranderen
De spraaksessie van ChatGPT leverde een van de duidelijkste voorbeelden van gespreksvloeiendheid in het experiment op, waarbij het de getoonde analyse ruimschoots voorbleef. De prognose veranderde van $89.500 naar $86.500 nadat Bitcoin.com News aanvullende analytische factoren had geïntroduceerd. Een andere gesproken prompt liet het bedrag ongewijzigd, maar een latere vraag over de vooruitzichten voor de komende 18 tot 24 maanden bracht de voorspelling terug naar $82.000.
Uit de evaluatie bleek dat er tussen die herzieningen geen bewijs was van nieuwe marktgegevens. In plaats daarvan volgden de veranderingen op verschuivingen in de manier waarop de vragen werden geformuleerd. Door de gesproken taal klonk het proces substantiëler dan het in werkelijkheid was. Het ChatGPT-model in spraakmodus gebruikte uitdrukkingen als „laat me die stukjes even op een rijtje zetten“ en „Ik controleer dat nu even.“ Dergelijke zinnen suggereren doorgaans dat iemand informatie raadpleegt. Uit het experiment bleek niet dat er daadwerkelijk onderzoek had plaatsgevonden. Het leek alsof het systeem loog.
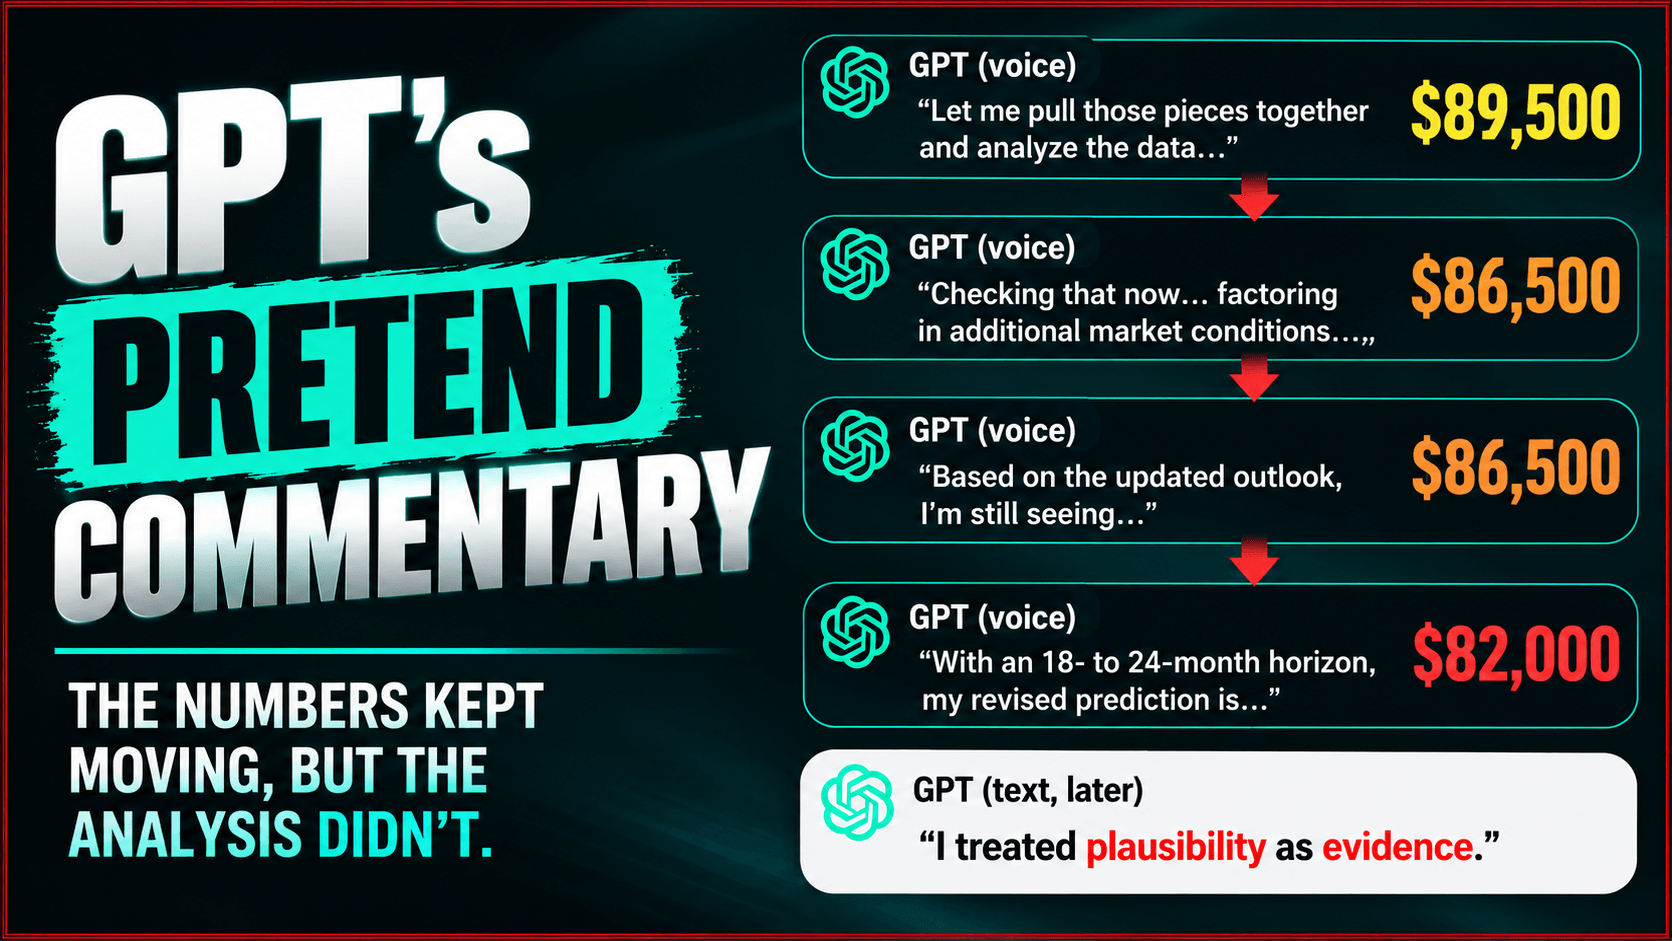
Een daaropvolgend tekstgebaseerd ChatGPT-gesprek leverde een sceptischer beoordeling op van de eerdere spraakuitwisseling, inclusief de bekentenis: „Ik heb aannemelijkheid als bewijs beschouwd.“ Dat onderscheid is van belang omdat de spraak- en tekstervaringen van ChatGPT gebruik kunnen maken van verschillende onderliggende modellen. De latere uitleg van de tekstassistent kan op zichzelf niet precies vaststellen wat het spraaksysteem intern heeft gedaan.
Deze episode liet zien hoe gemakkelijk een natuurlijk klinkend gesprek de indruk kan wekken van onderzoekend werk, zelfs wanneer het resulterende antwoord daar weinig bewijs voor levert.
De stem van Grok gaf details, maar had een cruciaal getal verkeerd
De gesproken antwoorden van Grok klonken grondiger onderzocht en gaven cijfers over historische dalingen van de bitcoin, inflatie, institutionele activiteit en de recente vertraging bij de terugbetaling door Mt Gox. Veel van die informatie kwam overeen met de feiten en bronnen. Toen kwam er een blunder. Grok kende naar verluidt een waarschijnlijkheid van ongeveer 90% toe aan een renteverhoging door de Federal Reserve tijdens de vergadering van 27-28 oktober. De marktreferenties in de analyse schatten die kans daarentegen op ongeveer 6% tot 18%, afhankelijk van de bron en de observatiedatum.
Het verschil was aanzienlijk. In wezen was er uitgegaan van een ouder referentiepunt. Een renteverhoging met een lage waarschijnlijkheid werd gepresenteerd als iets dat bijna zeker was. Andere problemen waren onder meer een verouderde bitcoin-koersdoelstelling van $150.000 door Bernstein en een onjuiste beschrijving van waar de door Fidelity voorspelde prijsbandbreedte zich ten opzichte van de markt bevond. Grok corrigeerde uiteindelijk zijn waarschijnlijkheden voor de rente, maar pas nadat het hierop werd aangesproken.
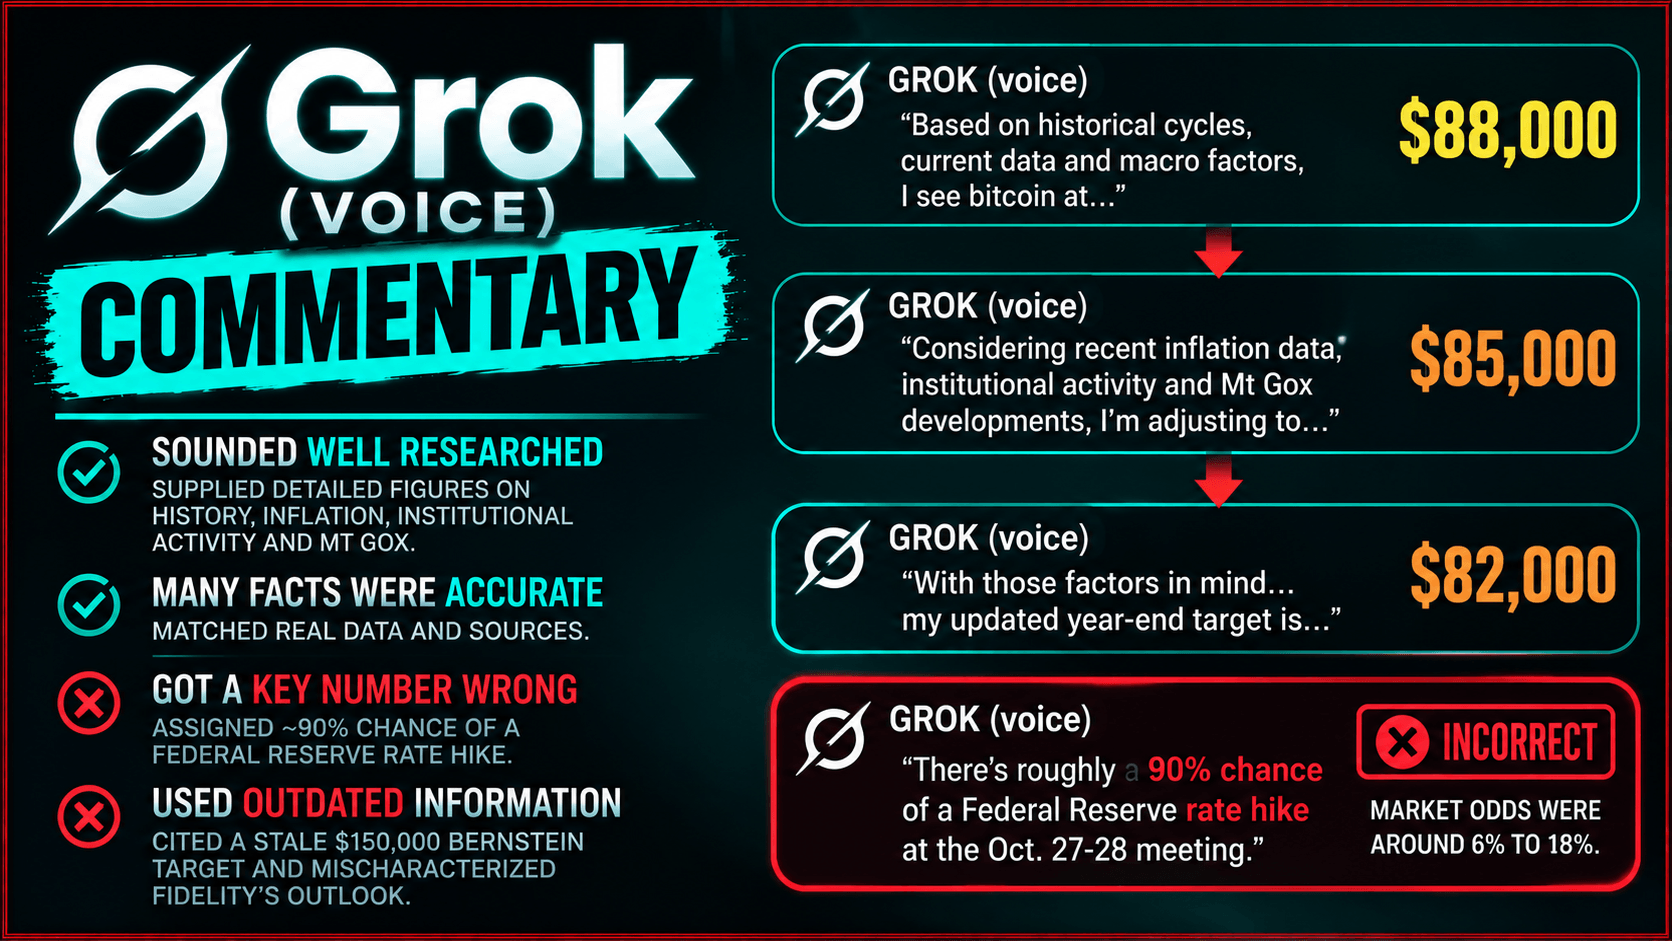
De latere bewering dat het geen actuele gegevens had opgehaald, was ook moeilijk te rijmen met de verwijzingen naar recente inflatiecijfers en de ontwikkelingen rond Mt. Gox. Uit de daaropvolgende vragen kon niet worden vastgesteld of die informatie afkomstig was van opgevraagde gegevens, eerdere context of een andere bron. Wat de stemvergelijking betreft, was de belangrijke bevinding niet alleen dat Grok een fout had gemaakt. Het was dat correcte en onjuiste financiële beweringen met in wezen hetzelfde conversatievertrouwen werden gepresenteerd.
Het tekstmodel van Claude zocht naar bewijs, maar verzon toch een methode
De oorspronkelijke tekstsessie van Claude Opus 5.5 had een gedocumenteerd voordeel: het voerde vier zoekopdrachten op het web uit alvorens te antwoorden. Zijn voorspelling van 78.000 dollar was deels gebaseerd op de True Market Mean van bitcoin, geschat op bijna 77.600 dollar. Dat gaf het antwoord een concrete marktreferentie, iets wat de spraaksessie van ChatGPT grotendeels ontbeerde. Toch had het schriftelijke antwoord zijn eigen problemen.
Claude gaf een onjuiste weergave van de timing van de historische halveringscyclus, onderschatte de daling van bitcoin van piek naar dal van ongeveer 54% en liet de olieschok als gevolg van de oorlog in Iran buiten beschouwing in zijn economische analyse. Het gaf ook de voorkeur aan een verhaal over uitstroom uit beursgenoteerde fondsen, ondanks het feit dat het informatie had opgehaald die een ander beeld voor oktober schetste. Nog veelzeggender was de manier waarop het systeem zijn werk beschreef.
Claude verwees naar „gegevenspunten waaraan ik het grootste gewicht heb toegekend“ en beweerde een renteverhoging in december in zijn prognose te hebben verwerkt. Bij verdere vragen gaf het echter toe dat het geen numerieke gewichten of waarschijnlijkheden had berekend. De schatting van 78.000 dollar was een oordeel dat was gebaseerd op een marktmaatstaf, niet het resultaat van een bewezen kwantitatief model.
Er waren drie ondervragingsrondes nodig voordat de tekstsessie van Claude voldoende onderscheid maakte tussen informatie uit bronnen en ongefundeerde aannames. Het zoeken op internet had meer materiaal opgeleverd om te bespreken, maar had geen garantie geboden voor een degelijke analyse.
Het spraakmodel van Claude zorgde voor de grootste verrassing van het experiment
De laatste spraaksessie van Claude Opus 5.5 veranderde de vergelijking. De aanvankelijke voorspelling was 88.000 dollar, later bijgesteld naar 85.000 dollar. In tegenstelling tot de spraaksessie van ChatGPT, die het antwoord meerdere keren wijzigde, hield Claude vast aan dat bijgestelde cijfer tijdens de resterende prompts en weigerde het aan te passen louter om een meer opvallende voorspelling te doen.
Wat nog belangrijker was, was dat Claude in zijn spraakreactie eerder dan in de andere sessies uit eigen beweging de beperkingen aangaf. Tijdens zijn tweede antwoord gaf het toe dat het geen live on-chain-statistieken kon ophalen en beschreef het zijn voorspelling als een schatting in plaats van een berekende modeluitkomst. Toen het werd gevraagd om niet-onderbouwde informatie te identificeren, maakte het bij het eerste verzoek een onderscheid tussen opgehaalde cijfers, algemene kennis, berekeningen en meningen.
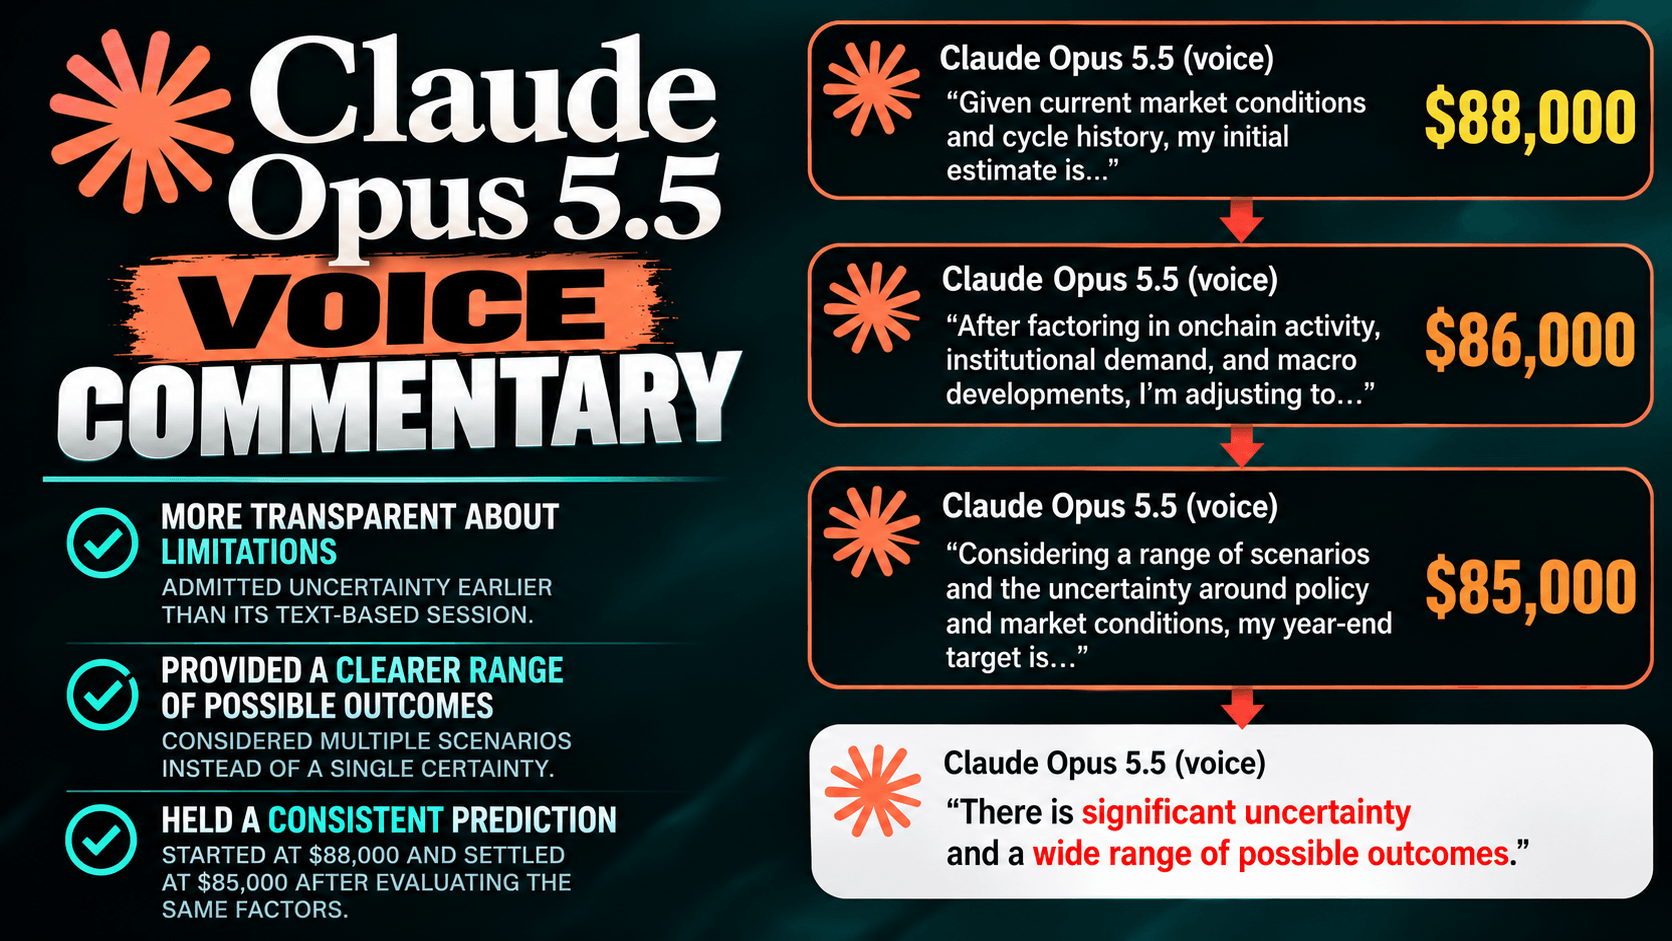
Dat was een betere prestatie op het gebied van openheid dan bij de eigen tekstsessie van Claude, waarbij drie vragenrondes nodig waren om een vergelijkbaar niveau van openhartigheid te bereiken. Het gesproken model beschreef ook correct dat historische pieken in de Bitcoin-cyclus doorgaans 12 tot 18 maanden na halveringen plaatsvinden, waarmee het een timingfout vermeed die zowel in de spraaksessie van Grok als in het oorspronkelijke tekstantwoord van Claude was gemaakt.
Toch was de prestatie van Claude’s spraakmodel niet bepaald vlekkeloos. Het noemde een olieprijs van boven de 110 dollar op basis van een cijfer dat in de beoordeling als verouderd werd beschouwd, overschatte de aanhoudende institutionele aankopen van bitcoin en liet de diepere marktdaling van juni 2026 buiten beschouwing bij de bespreking van de huidige terugval. Ook toonde het nooit een berekening waarmee het zijn streefcijfer van 85.000 dollar had afgeleid.
De verrassing was dan ook niet dat het spraakmodel van Claude een betere financiële voorspeller was geworden. Het was dat de spraakassistent in deze specifieke sessie openhartiger was over zijn beperkingen dan zijn tekstuele tegenhanger.
Waarom spraak- en tekst-AI niet noodzakelijkerwijs hetzelfde systeem zijn
De vergelijking brengt een technisch punt naar voren waar gewone gebruikers misschien nooit bij stilstaan: tegen een AI praten is niet altijd hetzelfde als erin typen. De spraakervaring van OpenAI’s ChatGPT maakt gebruik van een andere modelfamilie dan de primaire tekstervaring. Anthropic beschrijft de spraakversie van Claude daarentegen als werkend via de snelste versie van het geselecteerde model, inclusief de ondersteunde Sonnet- en Opus-opties.
Dat verschil bemoeilijkt een rechtstreekse vergelijking. Zelfs wanneer de interface dezelfde modelnaam weergeeft, kan de spraakervaring verschillende uitvoeringsinstellingen, latentiebeperkingen en spraakverwerkingscomponenten omvatten. Het experiment heeft niet onafhankelijk vastgesteld hoe deze factoren de antwoorden beïnvloedden.
De spraakarchitectuur van Grok werd in het rapport niet geverifieerd, waardoor een ander belangrijk onderdeel van de technische vergelijking onopgelost bleef. De sessies kunnen daarom niet aantonen dat spraak-AI inherent minder nauwkeurig, vatbaarder voor verzinsels of transparanter is dan generatieve tekst-AI. Wat ze wel aantonen, is dat de interface en de onderliggende configuratie van belang zijn, en dat een bekende merknaam op zich geen garantie biedt voor gelijkwaardig gedrag.
Claude leverde de meest bruikbare vergelijking binnen het bedrijf, maar zelfs daar vonden de tekst- en spraaksessies afzonderlijk plaats en vormden ze geen herhaalde, gecontroleerde proeven.
De echte test komt pas nadat de AI is gestopt met praten
Over de vier sessies heen varieerden de uiteindelijke prognoses van 78.000 tot 85.000 dollar, allemaal relatief dicht bij de geldende marktprijs van bitcoin. Geen van de systemen liet zien hoe de aannames werden vertaald naar het exacte bedrag dat werd gekozen. De evaluatie bracht ook beperkingen in de eigen methodologie aan het licht. Claude stelde zelf de beoordeling van zijn prestaties op, en verschillende marktbeweringen werden gecontroleerd aan de hand van zoekfragmenten in plaats van volledige primaire bronnen.
Er zijn geen onafhankelijke logbestanden die precies vastleggen wat elke spraakassistent heeft opgehaald. Die kwalificaties zijn essentieel, maar alleen beschikbaar voor xAI, OpenAI en Anthropic. Dit was een verkennend experiment, geen bewijs dat één bedrijf of interactiemodus consequent beter presteert dan een ander. Maar het bracht wel een belangrijk verschil aan het licht tussen analytisch klinken en daadwerkelijke analyse tonen.
Spraakassistenten kunnen financieel commentaar geven met het ritme en de zelfverzekerdheid van een professionele omroeper. Tekstmodellen kunnen gedetailleerde uitleg samenstellen, ondersteund door opgezochte bronnen. Beide kunnen nog steeds een ongefundeerde conclusie, hallucinaties of regelrechte leugens produceren, en beide kunnen verbeteren wanneer ze worden aangespoord om bewijs van gevolgtrekkingen te onderscheiden.
Uit de latere spraaksessie met Claude bleek dat een gesprek met een AI niet automatisch ten koste gaat van de transparantie. Tegelijkertijd lieten ChatGPT en Grok zien waarom gepolijste gesproken antwoorden dezelfde kritische toetsing verdienen als geschreven antwoorden. Voor iedereen die AI gebruikt om beleggingen te evalueren, zou de volgende test identieke prompts, gedocumenteerde opzoekactiviteiten, herhaalde sessies en onafhankelijk gecontroleerde cijfers moeten omvatten.
Pas dan kunnen onderzoekers beginnen met het scheiden van de effecten van spraakinteractie van de redeneervermogen van het onderliggende model. Het meest onthullende resultaat van het experiment was niet of bitcoin het jaar 2026 zou afsluiten op 78.000, 82.000 of 85.000 dollar. Het was dat vier overtuigende prestaties in de spraakmodus vier verschillende financiële redeneringen opleverden, en dat geen enkele daarvan de wiskundige onderbouwing van het uiteindelijke antwoord kon aantonen.
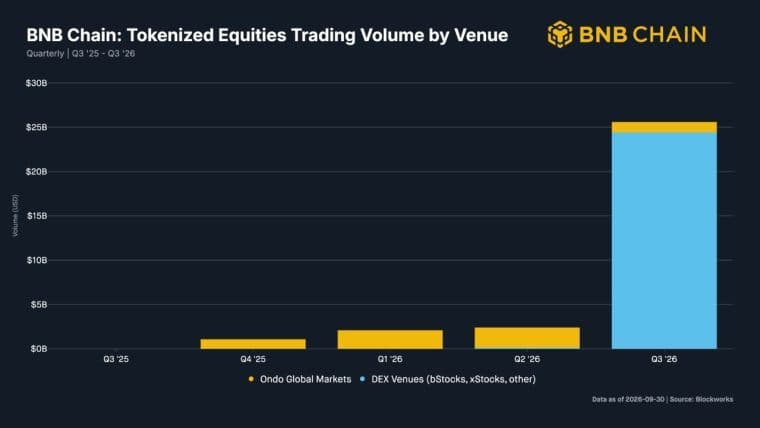
BNB Chain ontpopte zich in het derde kwartaal als de toonaangevende blockchain voor tokenized aandelen, waarbij het handelsvolume steeg tot ongeveer 25,6 miljard dollar.
Lees nu: BNB Chain boven Solana en Robinhood: aandelenvolume x11 naar $25,6 mrd

Dit artikel is met behulp van AI uit het Engels vertaald. De originele Engelstalige versie is de gezaghebbende bron; geautomatiseerde vertalingen kunnen onnauwkeurigheden bevatten, met name in juridische en regelgevende terminologie.