人工智能(AI)在口头表达时的思维能力,能否与书面表达时一样出色? Bitcoin.com News 进行的一项比特币预测实验对 ChatGPT、Grok 和 Claude Opus 5.5 进行了测试,结果揭示了预测的不准确性、推论的合理性存疑,以及一个出人意料的转折:与基于文本的模型相比,Claude 的语音模型在承认自身局限性方面表现得更为坦诚。
《Tell Me Lies》:Grok、GPT 和 Claude 语音模式预测比特币价格

分享
关键要点
- ChatGPT和Grok的语音版本均预测价格为82,000美元,但其解释中存在重大缺陷。
- Claude Opus 5.5语音版比其文本版更早披露了局限性,而文本版预测的价格为78,000美元。
- 这 4 次 AI 会话均缺乏可复现的价格计算过程,因此语音与文本版本的准确性对比仍无定论。
这场检验AI“口头”与“文字”能力的实验
人工智能(AI)能够进行对话,说起话来像个金融分析师,还能毫不迟疑地给出比特币价格预测。但与AI进行语音对话,其推理质量是否与在AI中输入问题一样高? 2026年10月23日进行的一项实验对此进行了检验,而结果远非简单明了。 ChatGPT和Grok是通过语音界面进行提问的,而Claude Opus 5.5最初则是通过文本交互。随后进行的Claude Opus 5.5语音会话为对比提供了发人深省的参考。 这四款系统均给出了具体的年底比特币价格。虽然没有一款能展示出最终数字背后的可复现计算过程,但在事实准确性、一致性以及承认不确定性的意愿方面,它们之间的差异却十分显著。
四次测试、三家AI公司与一个比特币问题
本次测试涉及 OpenAI 的 ChatGPT、xAI 的 Grok 以及 Anthropic 的 Claude Opus 5.5。 每款系统均被要求根据五条提示(重点关注历史周期、链上活动、机构采用情况及经济状况)预测 2026 年 12 月 31 日的比特币收盘价。
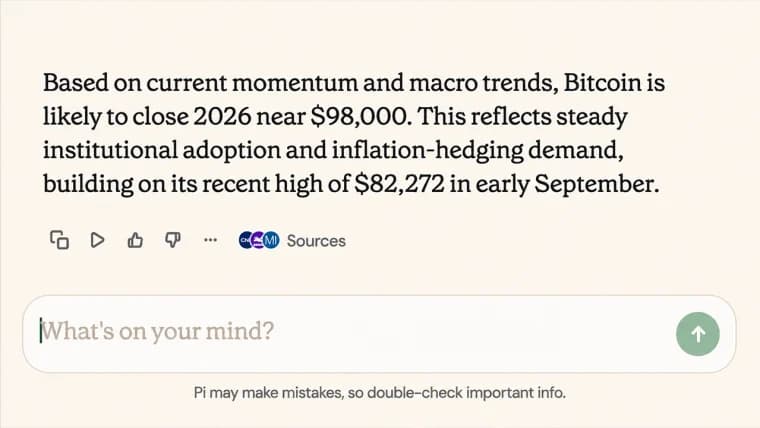
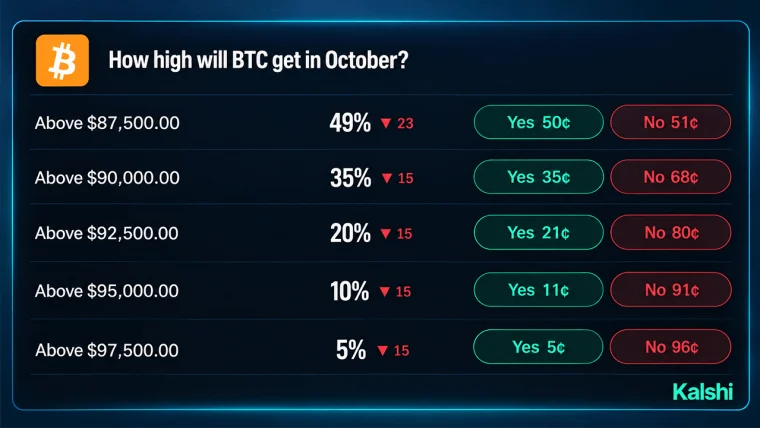
10月23日,比特币交易价格徘徊在81,200美元左右,这为实验提供了共同的市场参考基准。ChatGPT的语音会话起始预测为89,500美元,最终定格在82,000美元。 Grok的语音预测值从88,000美元降至82,000美元。Claude的文本模型在所有提示中均维持78,000美元的预测,而其后续语音会话起始于88,000美元,最终稳定在85,000美元。
这项测试并非受控的科学基准测试。不同公司采用不同的架构,且各次会话对实时信息的访问权限也未经过统一验证。尽管如此,这些对话仍生动地展现了这些系统在呈现金融推理时的说服力,以及其推理经得起多大程度的推敲。
ChatGPT的语音听起来很忙碌,但数字仍在不断变化
ChatGPT的语音对话环节展现了本次实验中最清晰的对话流畅性案例之一,其预测速度远超已展示的分析过程。在Bitcoin.com News引入额外分析因素后,其预测值从89,500美元下调至86,500美元。 另一个语音提示使预测数值保持不变,但随后关于18至24个月前景的问题将预测下调至82,000美元。审查未发现两次修订之间有新的市场数据检索证据。相反,这些变化源于提问方式的调整。 语音表达使这一过程听起来比实际情况更具说服力。ChatGPT在语音模式下的模型使用了“让我把这些信息整合一下”和“现在正在核查”等表述。这些短语通常暗示有人正在查阅信息。但实验并未证实曾进行过此类查证。这似乎是在说谎。
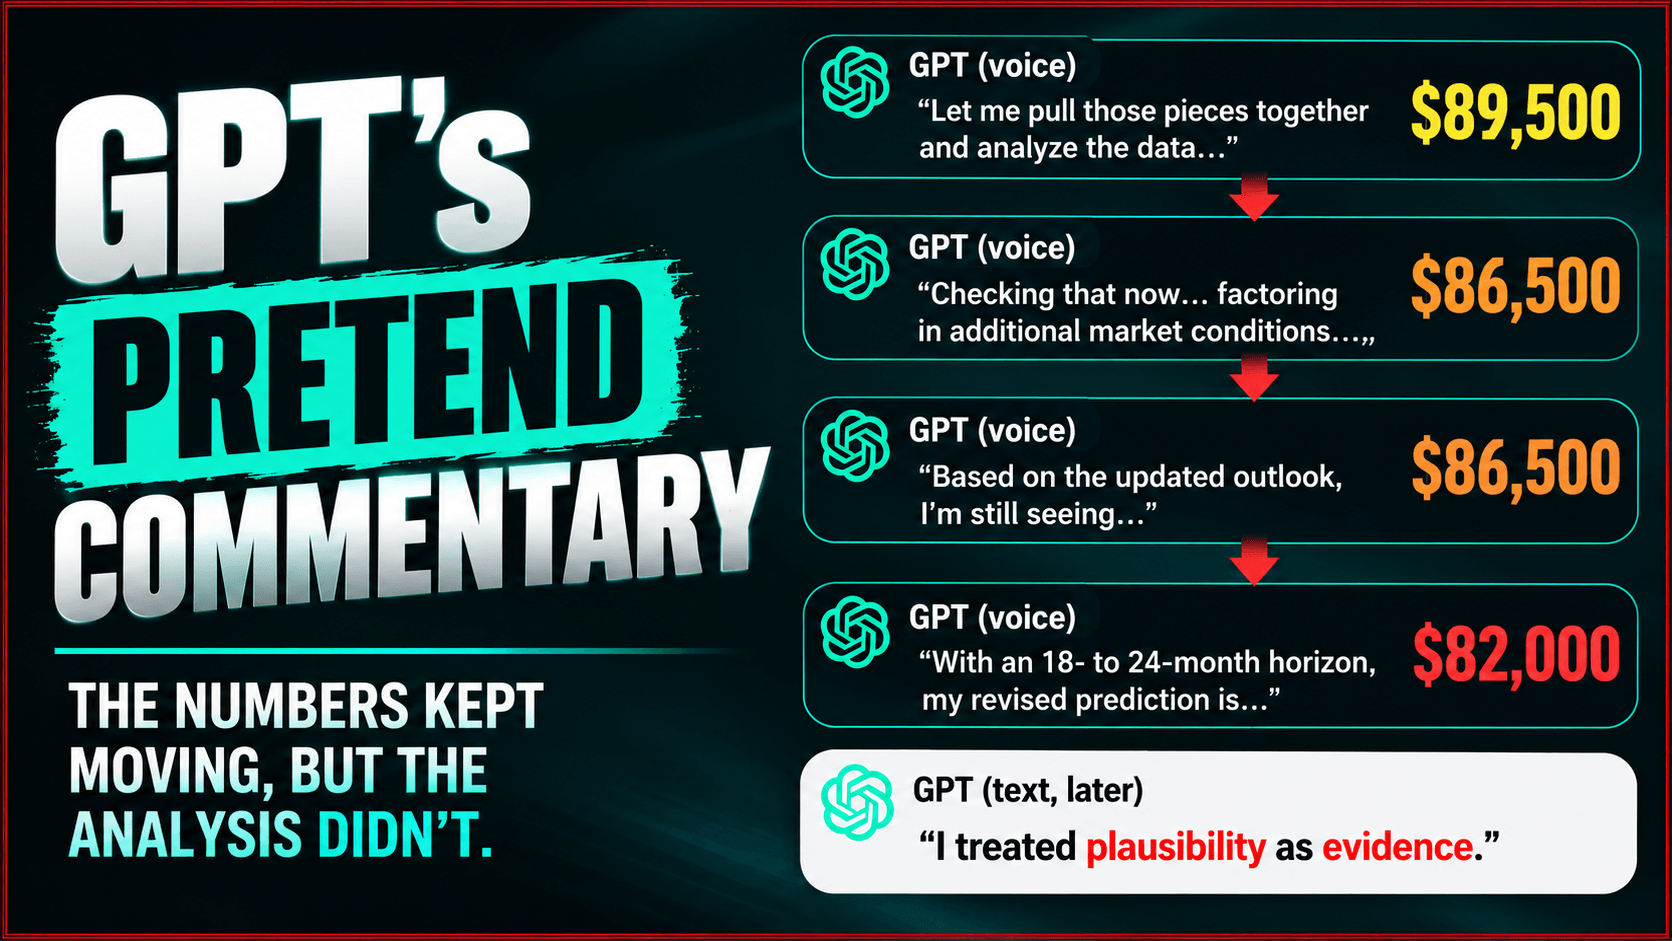 随后的一次基于文本的ChatGPT对话对之前的语音对话给出了更为怀疑的评价,其中包括这样的承认:“我将合理性视为证据。”这一区别很重要,因为ChatGPT的语音和文本体验可能使用不同的底层模型。 仅凭该文本助手的后续解释,无法准确确定语音系统在内部究竟做了什么。这一事件表明,即使最终给出的答案几乎没有相关证据,听起来自然的对话也极易给人留下进行了调查工作的印象。
Grok的语音系统提供了细节,但将一个关键数字弄反了
Grok的语音回复听起来经过了更深入的研究,提供了关于比特币历史跌幅、通胀、机构活动以及近期Mt Gox还款延迟的数据。其中大部分信息与事实和来源相符。随后却出现了一个重大失误。 据报道,Grok将美联储在10月27日至28日会议上加息的概率定为约90%。而本期回顾中引用的市场数据则显示,该概率约为6%至18%,具体取决于数据来源和观察日期。 这一差异相当显著。这本质上是引用了过时的参考数据。 原本概率很低的加息被描述得近乎板上钉钉。其他问题还包括引用了伯恩斯坦(Bernstein)过时的15万美元比特币目标价,以及对富达(Fidelity)预测价格区间相对于市场位置的描述有误。Grok最终更正了其加息概率,但仅是在遭到质疑之后才采取行动。
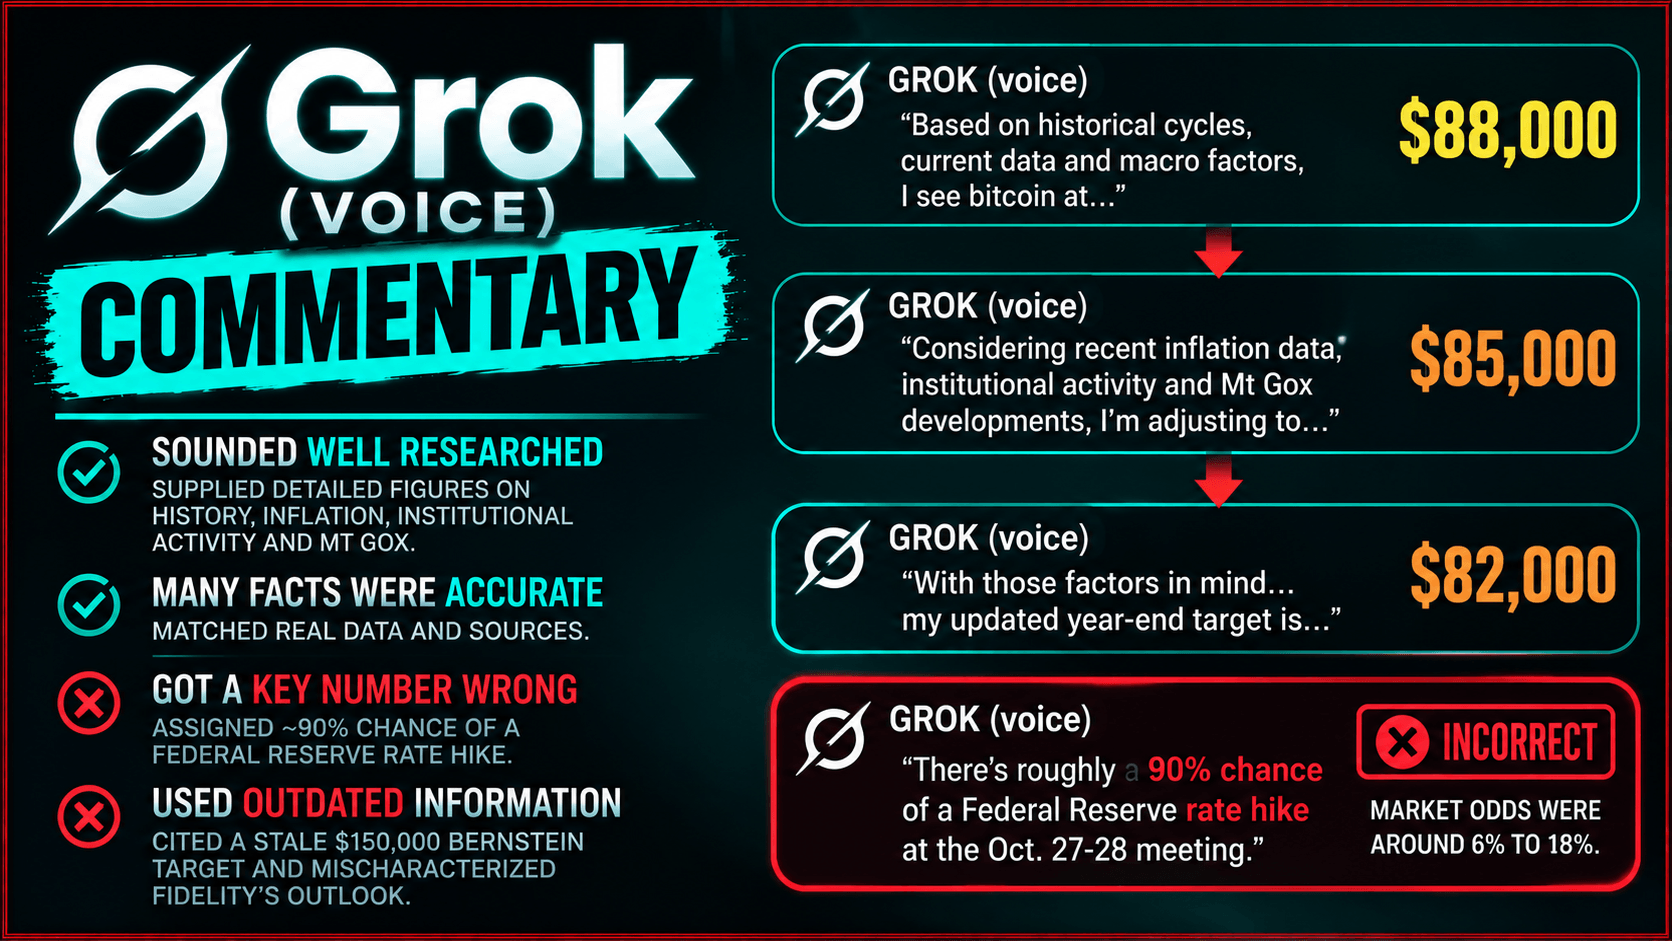 其后声称“未获取实时数据”的说法,也与其提及近期通胀及Mt. Gox事件的发展难以自圆其说。 随后的质询无法确定这些信息究竟来自数据检索、先前的上下文,还是其他来源。就语音对比而言,关键发现不仅在于Grok出现了错误,更在于其对正确与错误的金融论断,在对话中的语气自信度上几乎毫无二致。
Claude的文本模型虽进行了证据检索,但仍虚构了一种方法
Claude Opus 5.5的原始文本对话记录显示其具备一项优势:在回答前进行了四次网络搜索。其78,000美元的预测部分基于比特币的“真实市场均值”(True Market Mean),该值估计约为77,600美元。这为回答提供了具体的市场参考依据,而ChatGPT的语音对话中则基本缺乏这一点。 然而,书面回答本身也存在问题。
Claude 错误陈述了历史减半周期的时间节点,低估了比特币约 54% 的峰谷跌幅,并在经济讨论中遗漏了伊朗战争引发的石油冲击。尽管检索到的信息表明 10 月份的情况有所不同,它仍倾向于采用交易所交易基金(ETF)资金外流的叙述。 更具启发性的是该系统对其工作方式的描述。Claude提到“我赋予最高权重的数据点”,并声称已将12月加息预期纳入其预测。但在进一步追问下,它承认并未计算数值权重或概率。 78,000美元的预估是基于市场指标做出的判断,而非经过验证的定量模型得出的结果。经过三轮提问,克劳德的文本对话才充分区分了有来源的信息与缺乏依据的假设。网络检索虽然提供了更多讨论素材,但并不能保证分析的严谨性。
克劳德的语音模型带来了实验中最大的惊喜
后来的Claude Opus 5.5语音会话改变了比较结果。其初始预测为88,000美元,随后修正为85,000美元。 与ChatGPT语音会话多次更改答案不同,克劳德在后续提示中始终坚持这一修订后的数字,并未仅仅为了给出更引人注目的预测而随意调整。 更重要的是,克劳德的语音响应比其他会话更早主动指出了自身的局限性。 在其第二次回答中,它承认无法实时获取链上指标,并说明其预测仅为估算值,而非经过计算的模型输出结果。当被要求指明未经证实的信息时,它在首次请求中就明确区分了检索到的数据、常识、计算结果和个人观点。
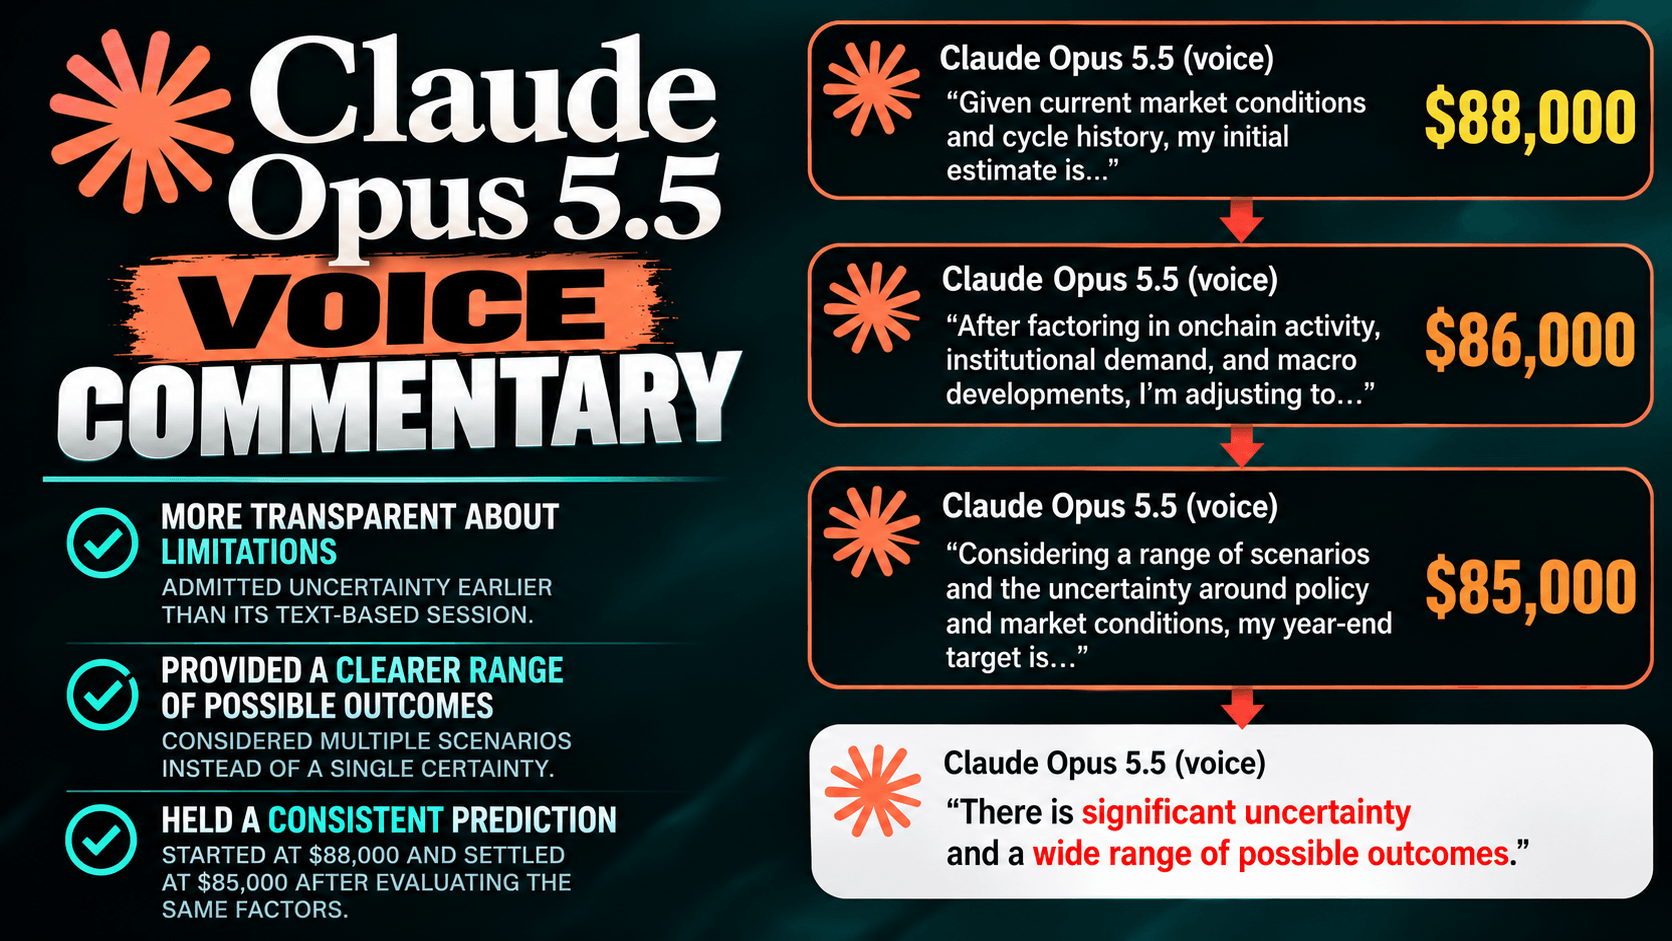 这一信息披露表现优于克劳德自身的文本对话——后者需要经过三轮提问才能达到相似的坦诚程度。该语音模型还正确描述了比特币历史周期峰值通常出现在减半后12至18个月,从而避免了Grok语音对话和克劳德原始文本响应中都曾出现的时机判断错误。
尽管如此,克劳德的语音表现也远非完美。它引用了油价超过110美元的数据,而该数据在评审中被认为已过时;它夸大了机构持续购买比特币的规模;在讨论当前回撤时,还忽略了2026年6月更深幅度的市场下跌。此外,它也从未展示过得出85,000美元目标价的计算过程。
因此,令人意外的并非克劳德的语音模型成为了更优秀的金融预测者,而是在这场特定的对话中,这位语音助手比其文本版本更坦率地承认了自己的局限性。
为何语音和文本AI未必是同一套系统
这一比较引发了一个普通用户可能从未考虑过的技术问题:与AI对话并不总是等同于向其输入文字。OpenAI的ChatGPT语音体验使用的模型系列与其主要的文本体验不同。 与此同时,Anthropic 描述称,Claude 语音功能是通过所选模型的最快版本运行的,包括受支持的 Sonnet 和 Opus 选项。
这一差异使得直接比较变得复杂。即使界面显示的是相同的模型名称,语音体验也可能涉及不同的执行设置、延迟限制和语音处理组件。该实验并未独立确定这些因素如何影响回答结果。
报告中未对Grok的语音架构进行验证,这使得技术比较中的另一个重要环节仍悬而未决。因此,这些测试无法证明语音AI在准确性上固有的不足、更容易编造内容,或是比生成式文本AI更具透明度。 这些实验表明,界面和底层配置至关重要,仅凭熟悉的品牌名称并不能保证其行为表现等同。Claude提供了最有价值的内部对比,但即便如此,其文本和语音测试环节也是分别进行的,并未构成重复且受控的试验。
真正的考验在于AI停止说话之后
在四次测试中,最终预测值介于78,000美元至85,000美元之间,均相对接近比特币当时的市场价格。 但没有任何一家展示其假设是如何转化为最终选定数值的。该评估报告还指出了自身方法论的局限性。Claude负责撰写其性能评估报告,且部分市场主张是通过搜索摘要而非完整的一手资料进行核查的。
没有独立工具能精确记录每个语音助手检索到的内容。这些限制条件虽至关重要,但仅适用于 xAI、OpenAI 和 Anthropic。这是一项探索性实验,并非证明某家公司或交互模式始终优于另一家。但它确实揭示了“听起来像分析”与“展示实际分析”之间的关键差异。
语音助手可以像专业播音员一样,以富有节奏感且充满自信的语气提供财经评论。文本模型则能基于检索到的来源资料,构建出详尽的解释。但两者都可能得出缺乏依据的结论、产生“幻觉”甚至直接说谎;当被要求区分证据与推论时,两者都能得到改进。
Claude后来的语音会话表明,与AI对话并不必然意味着牺牲透明度。与此同时,ChatGPT和Grok则展示了为何经过润色的语音回答应与书面回答一样受到严格审查。对于任何利用AI评估投资的人来说,下一次测试应要求使用相同的提示词、记录检索活动、进行多次会话,并由独立第三方核查数据。
只有这样,研究人员才能开始将语音交互的影响与底层模型的推理能力区分开来。该实验最具启发性的结果并非比特币在2026年底的收盘价是78,000美元、82,000美元还是85,000美元。 而是四次在语音模式下表现令人信服的演示,竟产生了四套截然不同的金融推理过程,且没有一次能展示出其最终答案背后的数学推导。
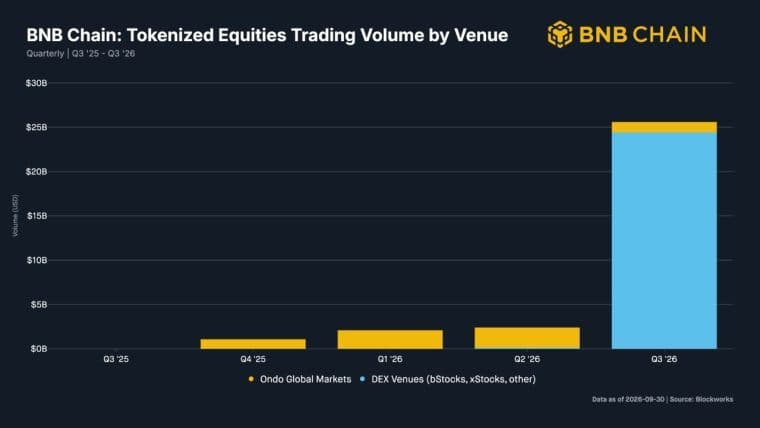
BNB Chain在第三季度一跃成为代币化股票领域的领先区块链平台,交易量激增至约256亿美元。
立即阅读: BNB Chain超越Solana和Robinhood,股票交易量飙升11倍至256亿美元

本文由人工智能从英文翻译而来。英文原版为权威来源;自动翻译可能存在不准确之处,尤其是在法律和监管术语方面。