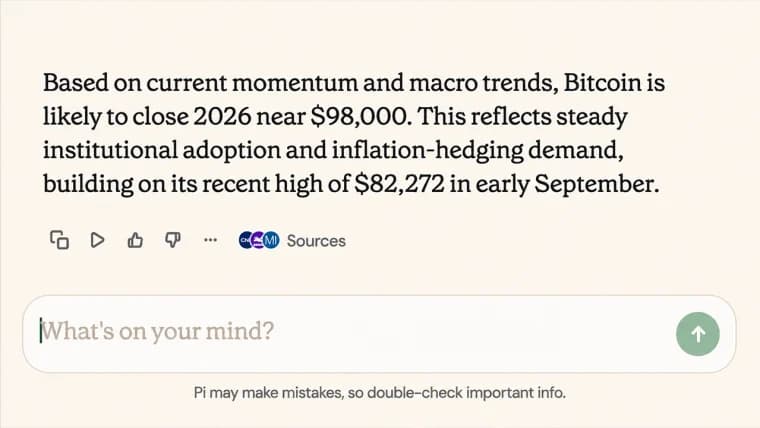
人工知能(AI)は、文章で表現するのと同じくらい、声に出して考えることもできるのでしょうか? Bitcoin.com Newsが実施したビットコイン予測実験では、ChatGPT、Grok、Claude Opus 5.5を検証した結果、不安定な予測や疑問の残る推論が明らかになりました。さらに、意外な展開も見られました。それは、Claudeの音声モデルが、テキストベースのモデルよりも自身の限界についてより率直に示していたという点です。
『Tell Me Lies』:Grok、GPT、Claudeの音声モードがビットコインの価格を予測

共有
主なポイント
- ChatGPTとGrokの音声版はいずれも82,000ドルと予測しましたが、その説明には重大な弱点がありました。
- 一方、Claude Opus 5.5の音声版は、78,000ドルと予測したテキスト版よりも早く自身の限界を明示しました。
- 4つのAIセッションすべてにおいて再現可能な価格算出が欠けており、音声版とテキスト版の精度の比較は未解決のままとなりました。
AIの「話す」能力と「打つ」能力を検証した実験
人工知能(AI)は会話を続け、金融アナリストのような口調で、途切れることなくビットコインの価格予測を提示することができます。しかし、AIと会話することで得られる推論の質は、質問をタイプ入力した場合と同じものでしょうか? 2026年10月23日に行われた実験でこの疑問が検証されたが、その答えは決して単純なものではなかった。 ChatGPTとGrokには音声インターフェースを通じて質問し、一方、Claude Opus 5.5は当初テキストで対応した。その後行われたClaude Opus 5.5の音声セッションにより、示唆に富む比較結果が得られた。 4つのAIはいずれも年末のビットコイン価格を具体的に提示しました。最終的な数値の背後にある再現可能な計算過程を示したものはなかったものの、事実の正確性、一貫性、そして不確実性を認める姿勢には顕著な違いが見られました。
4つのセッション、3社のAI企業、そして1つのビットコインに関する質問
本実験にはOpenAIのChatGPT、xAIのGrok、AnthropicのClaude Opus 5.5が参加しました。 各システムには、過去のサイクル、オンチェーン活動、機関投資家の採用状況、経済情勢を強調した5つのプロンプトを用いて、2026年12月31日のビットコイン終値を予測するよう依頼しました。
10月23日時点ではビットコインは81,200ドル前後で取引されており、実験における共通の市場基準となりました。ChatGPTの音声セッションは89,500ドルから始まり、最終的には82,000ドルに落ち着きました。 Grokの音声予測は88,000ドルから82,000ドルへと変動しました。Claudeのテキストモデルはプロンプト全体で78,000ドルを維持しましたが、その後の音声セッションでは88,000ドルから始まり、最終的に85,000ドルで落ち着きました。
この実験は厳密に管理された科学的なベンチマークではありませんでした。各社で採用されているアーキテクチャは異なり、各セッションにおいてリアルタイム情報へのアクセスが完全に同一であるとは確認されていません。とはいえ、これらの会話を通じて、各システムがいかに説得力を持って財務的な推論を提示できるか、またその推論が精査にどれだけ耐えられるかについて、示唆に富む知見が得られました。
ChatGPTの音声は慌ただしい印象だったが、数値は変動し続けた
ChatGPTの音声セッションは、実験の中で最も明快な会話の流暢さの例の一つを示し、提示された分析をはるかに上回る成果を上げた。Bitcoin.com Newsが追加の分析要素を提示した後、その予測は89,500ドルから86,500ドルへと変化した。 別の音声プロンプトでは数値は変わらなかったが、その後、18~24か月先の見通しに関する質問が投げかけられると、予測額は82,000ドルに引き下げられた。検証の結果、これらの修正の間に新たな市場データの取得が行われた証拠は見つからなかった。むしろ、変更は質問の立て方の変化に伴うものだった。 音声による表現は、実際のところよりもそのプロセスを重要そうに聞こえさせていました。音声モードのChatGPTモデルは、「それらの情報をまとめてみます」や「今確認しています」といった表現を使用していました。こうしたフレーズは通常、誰かが情報を参照していることを示唆します。しかし、この実験では、そのような調査が行われたことは確認されませんでした。それは嘘をついているように見えました。
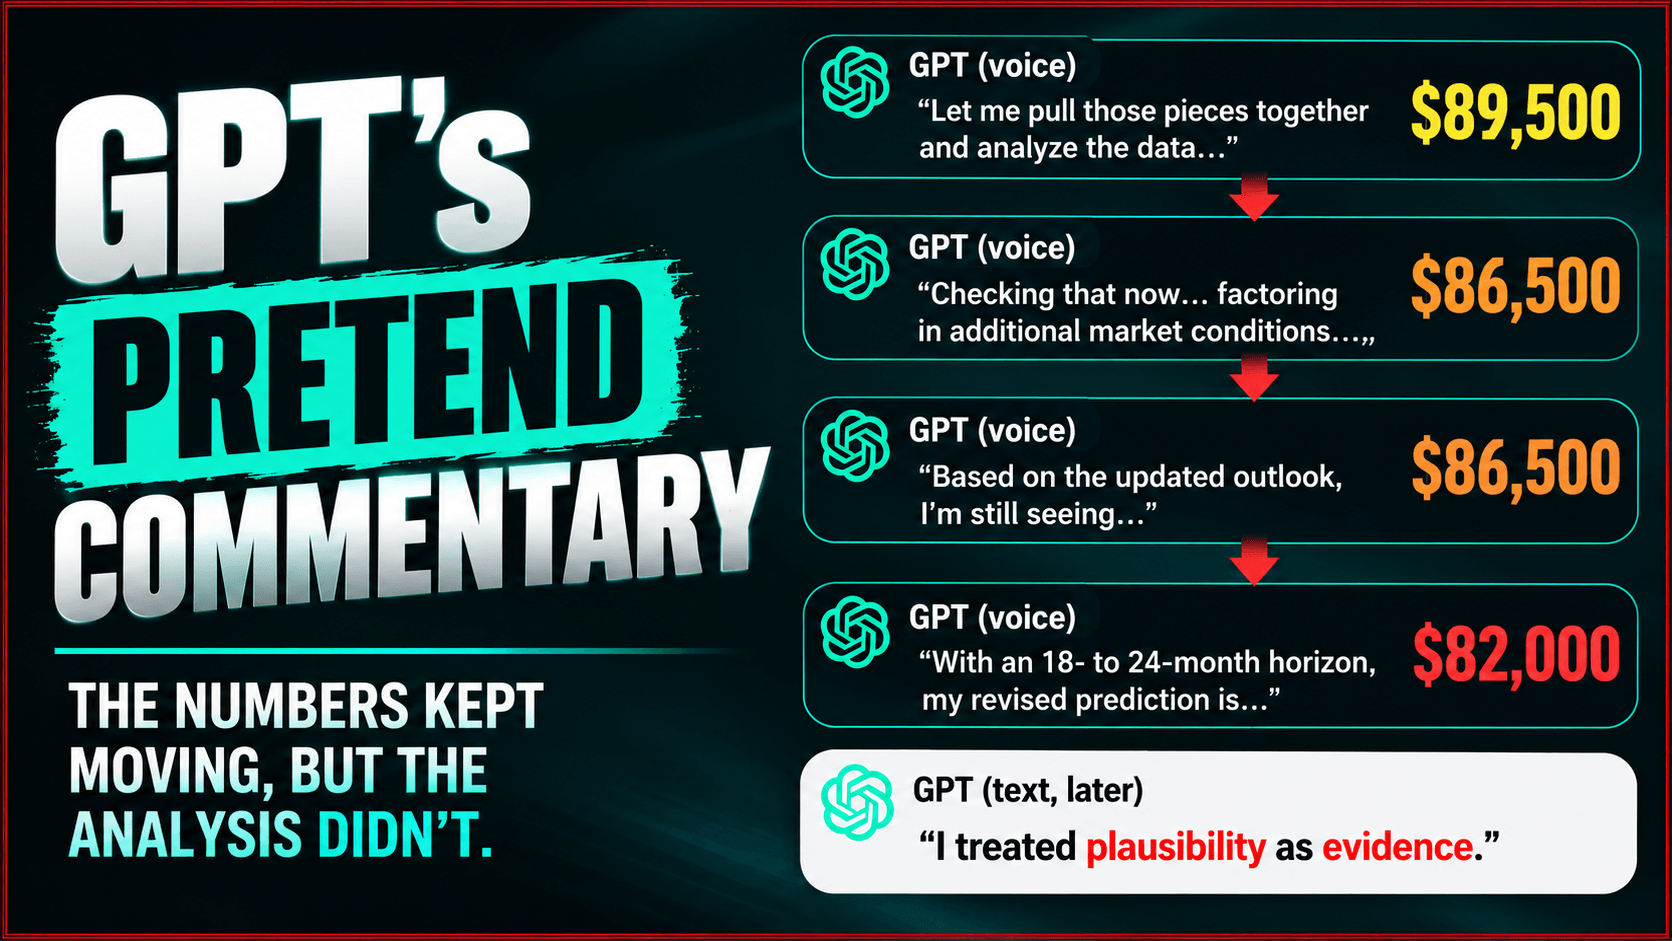 その後、テキストベースで行われたChatGPTとの会話では、先ほどの音声によるやり取りに対してより懐疑的な評価が示され、「私は妥当性を証拠として扱ってしまった」という自認も含まれていた。この区別が重要なのは、ChatGPTの音声とテキストの体験では、基盤となるモデルが異なる場合があるためだ。 テキスト版の説明だけでは、音声システムが内部でどのような処理を行ったのかを証明することはできません。この出来事は、たとえ回答を裏付ける根拠がほとんどない場合でも、自然で聞き慣れた会話が容易に調査を行っているかのような印象を与えることを示しています。
Grokの音声は詳細を伝えたが、重要な数値を逆にしてしまった
Grokの音声回答はより入念に調査したかのように聞こえ、ビットコインの過去の価格下落、インフレ、機関投資家の動向、最近のMt. Goxの返済遅延に関する数値を提供しました。その多くは事実や情報源と一致していました。しかし、その後、大きな誤りが生じました。 報道によると、Grokは10月27~28日の連邦公開市場委員会(FOMC)会合で利上げが実施される可能性を約90%と見積もっていました。一方、本レビューで参照した市場情報では、情報源や調査日によって異なりますが、その確率は約6~18%とされていました。その差は甚大でした。Grokは本質的に、古い参照データを基にしていたのです。 発生確率が低い利上げが、ほぼ確実であるかのように提示されていた。その他の問題点としては、バーンスタインによる15万ドルという古くなったビットコインの目標価格や、フィデリティの予測価格帯が市場に対してどの位置にあるかについての誤った説明などが挙げられた。Grokは最終的に利上げ確率を修正したが、それは指摘を受けてからのことだった。
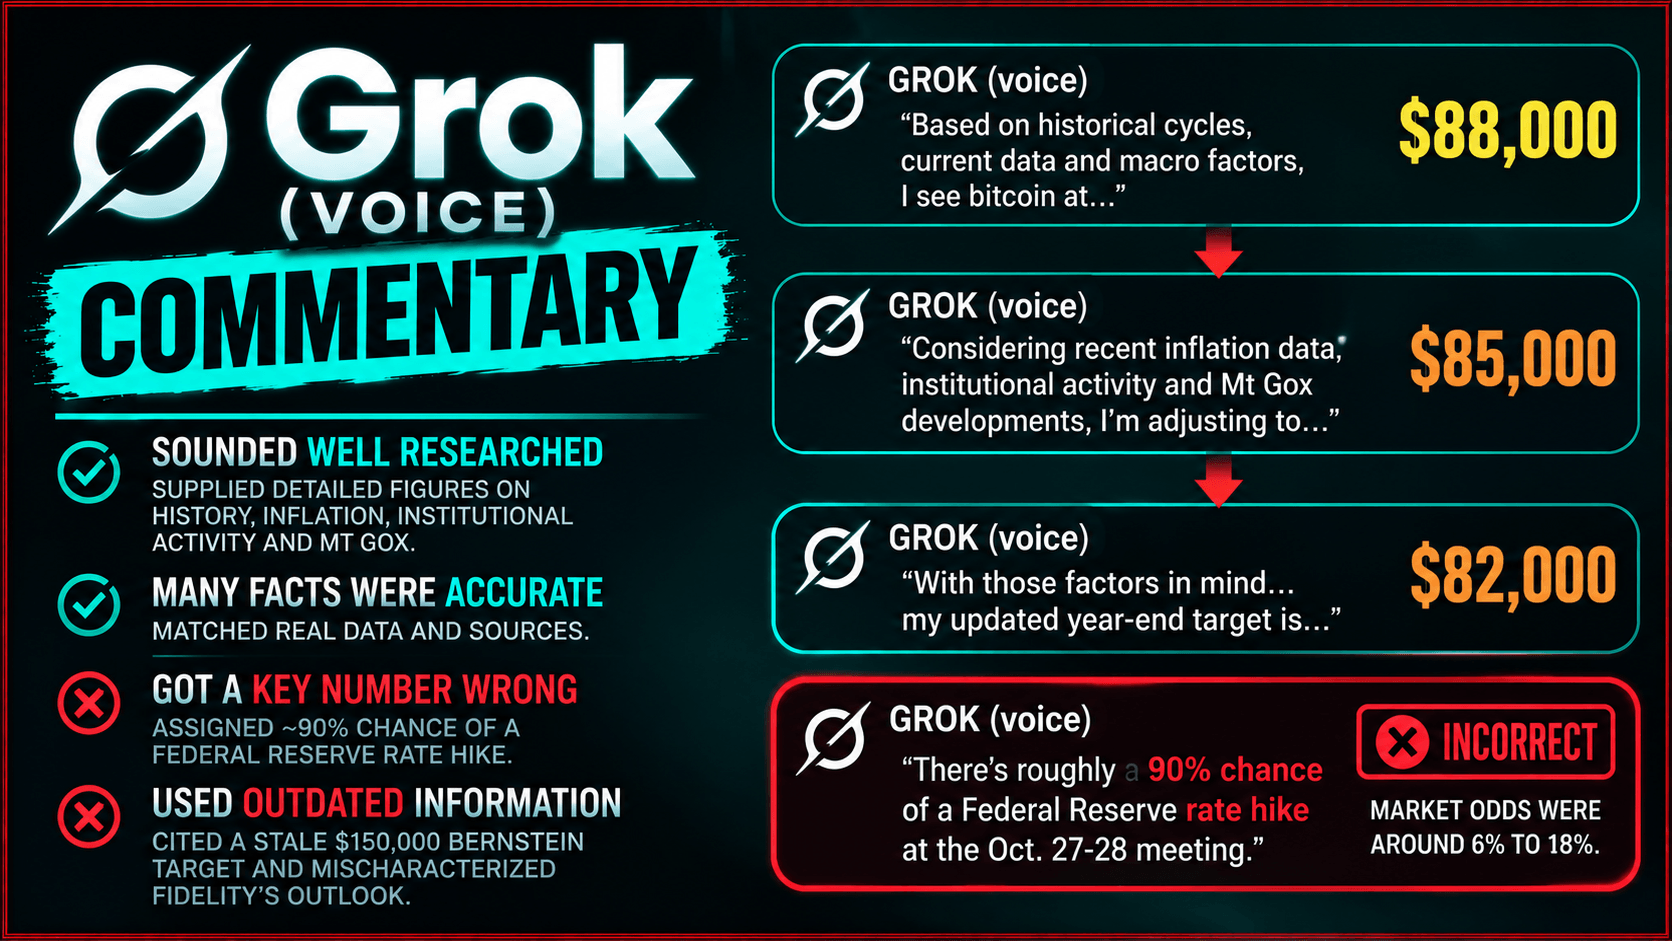 また、リアルタイムデータを取得していなかったという後の主張も、最近のインフレやMt. Goxの動向への言及と整合させることは困難でした。 その後の質疑応答では、その情報がデータ取得によるものか、事前の文脈に基づくものか、あるいは別の情報源によるものか、特定することはできなかった。音声比較において重要な発見は、単にGrokが誤りを犯したという事実だけではなかった。正しい金融に関する主張と誤った主張が、本質的に同じ会話上の確信度で提示されていたという点である。
Claudeのテキストモデルは証拠を探したが、それでも手法をでっち上げた
一方、Claude Opus 5.5のテキストセッションには、記録上明らかな利点がありました。回答前に4回のウェブ検索を実施していたのです。78,000ドルという予測は、77,600ドル近くと推定されるビットコインの「True Market Mean」を部分的に参照していました。これにより回答には具体的な市場指標が盛り込まれましたが、これはChatGPTの音声セッションには概して欠けていた要素です。 しかし、書面による回答にも独自の問題がありました。
また、過去の半減期サイクルのタイミングを誤り、ビットコインのピークから底値までの下落率(約54%)を過小評価し、経済論議ではイラン戦争による石油ショックにも言及しませんでした。さらに、10月の状況については異なる情報を取得していたにもかかわらず、上場投資信託(ETF)からの資金流出説を優先していました。 さらに興味深かったのは、システムが自身の推論過程をどのように説明したかです。Claudeは「私が最も重み付けしたデータポイント」に言及し、12月の利上げを予測に織り込んだと主張しました。しかし、さらに質問を重ねると、数値的な重みや確率を計算していなかったことを認めました。 78,000ドルという推定値は、実証済みの定量モデルによる出力ではなく、市場の指標に依拠した判断に過ぎませんでした。クロードとのテキストセッションでは、情報源に基づく事実と根拠のない仮定を適切に区別できるようになるまで、3回の質疑応答を要しました。ウェブ検索によって議論の材料は増えましたが、それが妥当な分析を保証するものではありませんでした。
クロードの音声モデルが実験最大の驚きをもたらした
後半のClaude Opus 5.5による音声セッションは、比較の結果を一変させました。最初の予測は88,000ドルでしたが、その後85,000ドルに修正されました。 ChatGPTの音声セッションのように回答を何度も変えることはなく、クロードは残りのプロンプトを通じて修正後の数値を維持し、注目を集めるために数値を調整することは避けました。 さらに重要な点は、クロードの音声応答が他のセッションよりも早く自らの限界を自ら指摘したことです。 2回目の回答では、オンチェーンのリアルタイム指標を取得できないことを認め、その予測を「計算されたモデル出力」ではなく「推定値」であると説明しました。裏付けのない情報を特定するよう求められた際、最初のリクエストで、検索結果、一般知識、計算結果、および意見を明確に区別して提示しました。
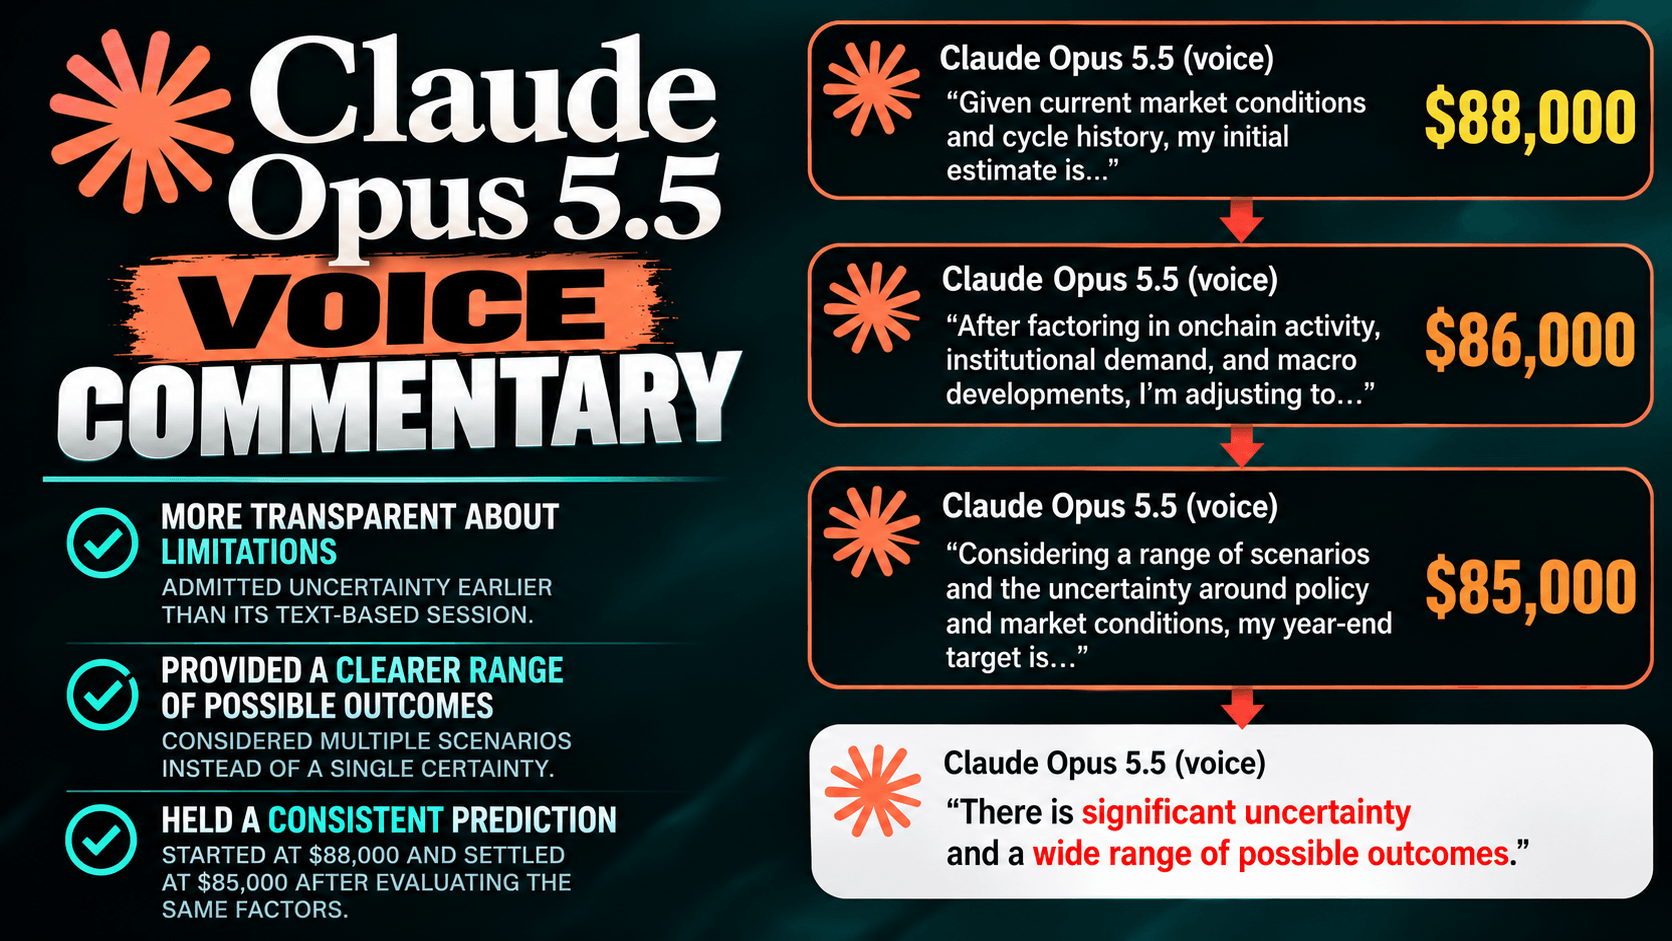 これは、同等の率直さに達するまでに3回の質問を要したクロード自身のテキストセッションよりも優れた情報開示のパフォーマンスでした。また、この音声モデルは、ビットコインの過去のサイクルにおけるピークが一般的に半減期の12~18ヶ月後に発生することを正しく説明しており、Grokの音声セッションやクロードの元のテキスト応答の両方が犯したタイミングの誤りを回避していました。
とはいえ、クロードの音声パフォーマンスが完璧だったわけではありません。レビューでは時代遅れと見なされた数値を用いて原油価格が110ドルを超えると引用し、機関投資家によるビットコインの継続的な購入を過大評価し、現在の価格下落について論じる際に2026年6月のより深刻な市場下落を省略していました。また、85,000ドルという目標値を導き出した計算過程を一切示しませんでした。
したがって、驚きだったのは、クロードの音声モデルがより優れた金融予測者になったことではない。この特定のセッションにおいて、音声アシスタントがテキスト版よりも自らの限界について率直に語っていたという点だった。
音声AIとテキストAIが必ずしも同じシステムではない理由
この比較は、一般ユーザーが決して考えないかもしれない技術的な問題を浮き彫りにしています。AIに話しかけることは、必ずしもAIに文字を入力することと同等ではありません。OpenAIのChatGPT音声体験は、その主要なテキスト体験とは別のモデルファミリーを使用しています。 一方、Anthropicは、Claudeの音声機能が、サポートされているSonnetやOpusのオプションを含め、選択されたモデルの最速バージョンを通じて動作すると説明しています。
この違いにより、単純な比較は複雑になります。インターフェースに同じモデル名が表示されていても、音声体験では異なる実行設定、遅延の制約、音声処理コンポーネントが使用されている可能性があります。この実験では、それらの要因が回答にどのような影響を与えたかを個別に立証することはできませんでした。
Grokの音声アーキテクチャについては本レポートで検証されておらず、技術的比較におけるもう一つの重要な要素が未解決のままとなっています。したがって、これらのセッションだけでは、音声AIが本質的に生成型テキストAIよりも精度が低く、虚偽の生成を招きやすく、あるいは透明性が高いと断定することはできません。 これらの実験が示しているのは、インターフェースと基盤となる構成が重要であり、馴染みのあるブランド名だけでは同等の動作が保証されないということです。Claudeは社内の比較において最も有用な結果を提供しましたが、そこでもテキストセッションと音声セッションは別々に行われ、反復された管理された試験とはなりませんでした。
真の試練は、AIが話し終えた後に訪れる
4つのセッションを通じて、最終的な予測値は78,000ドルから85,000ドルの範囲であり、いずれもビットコインの当時の市場価格に比較的近かったです。 どのシステムも、その前提条件がどのようにして選択した正確な数値につながったのかを提示していませんでした。また、本レビューでは、その方法論自体にも限界があることが明らかになりました。パフォーマンスの評価はClaude自身が作成したものであり、市場に関するいくつかの主張は、完全な一次情報源ではなく、検索結果の抜粋を通じて確認されていました。
各音声アシスタントが具体的にどのような情報を取得したかを正確に記録する独立したツールは存在しませんでした。こうした検証は不可欠ですが、xAI、OpenAI、Anthropicのみが実施可能です。これは探索的な実験であり、特定の企業や対話モードが他を常に上回っているという証明ではありません。しかし、分析的に聞こえることと、実際の分析を示すこととの間の重要な違いを浮き彫りにしました。
音声アシスタントは、プロの放送局員のようなリズムと確信を持って金融解説を行うことができます。テキストモデルは、検索した情報源に裏付けられた詳細な説明を組み立てることができます。いずれの場合も、根拠のない結論や「幻覚」、あるいは完全な嘘を生み出す可能性は依然としてあり、証拠と推論を区別するよう求められれば、どちらも改善の余地があります。
後の音声セッションでは、ClaudeがAIとの対話でも透明性を維持できることを示しました。一方、ChatGPTとGrokは、洗練された音声回答であっても文章回答と同様に精査されるべき理由を明らかにしました。AIを用いて投資を評価する者にとって、次のテストでは同一のプロンプト、記録された情報検索活動、繰り返しのセッション、独立して検証された数値が求められるべきです。
そうして初めて、研究者は音声対話による影響と基盤となるモデルの推論能力とを分離し始めることができる。この実験で最も示唆に富む結果は、ビットコインが2026年末に78,000ドル、82,000ドル、あるいは85,000ドルで終値をつけるかどうかではなかった。 最も示唆的だったのは、音声モードで4つの説得力あるパフォーマンスが4つの異なる財務的推論を生んだにもかかわらず、最終的な答えの背後にある計算過程を示せたものが一つもなかった点です。
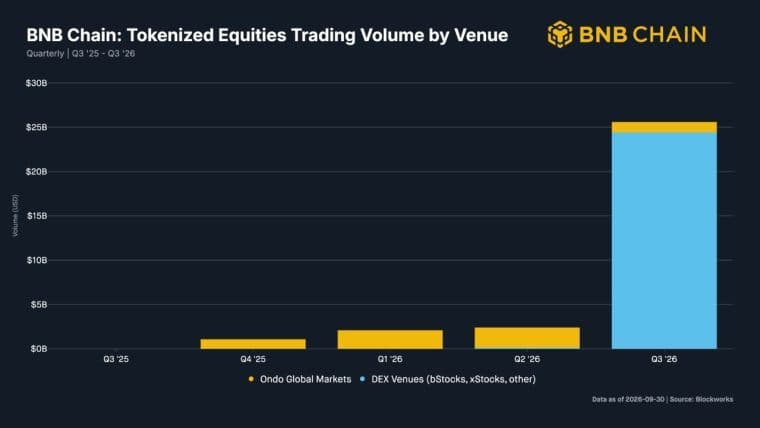
BNB Chainは第3四半期、トークン化された株式の分野でトップのブロックチェーンとして台頭し、取引高は約256億ドルまで急増しました。
今すぐ読む: BNBチェーン、ソラナやロビンフッド上回る 株式取引高11倍256億ドルに

この記事はAIを使用して英語から翻訳されました。英語の原文が正式な情報源であり、自動翻訳には、特に法律および規制に関する用語において不正確な部分が含まれる場合があります。