L'intelligenza artificiale (IA) è in grado di ragionare ad alta voce con la stessa efficacia con cui lo fa per iscritto? Un esperimento di previsione sui bitcoin condotto da Bitcoin.com News ha messo alla prova ChatGPT, Grok e Claude Opus 5.5, mettendo in luce previsioni inaffidabili, ragionamenti discutibili e un colpo di scena sorprendente: il modello vocale di Claude si è dimostrato più trasparente riguardo ai propri limiti rispetto alla sua controparte testuale.
Tell Me Lies: Grok, GPT e Claude stimano il prezzo del Bitcoin
SCRITTO DA

CONDIVIDI
Punti chiave
- Sia la versione vocale di ChatGPT che quella di Grok hanno previsto un valore finale di 82.000 dollari, ma le loro spiegazioni presentavano importanti punti deboli.
- La versione vocale di Claude Opus 5.5 ha rivelato i propri limiti prima rispetto alla sessione testuale, che aveva previsto 78.000 dollari.
- Tutte e quattro le sessioni di IA non presentavano calcoli dei prezzi riproducibili, lasciando irrisolta la questione dell’accuratezza tra versione vocale e versione testuale.
L’esperimento che ha messo alla prova le capacità di conversazione e digitazione dell’IA
L’intelligenza artificiale (IA) è in grado di sostenere una conversazione, parlare come un analista finanziario e fornire una previsione sul prezzo del bitcoin senza esitazioni. Ma parlare con un’IA produce la stessa qualità di ragionamento che digitare una domanda? Un esperimento del 23 ottobre 2026 ha messo alla prova questa domanda, e le risposte sono state tutt’altro che semplici. ChatGPT e Grok sono stati interrogati tramite interfacce vocali, mentre Claude Opus 5.5 ha inizialmente operato tramite testo. Una successiva sessione vocale con Claude Opus 5.5 ha aggiunto un confronto rivelatore. Tutte e quattro hanno fornito prezzi specifici del bitcoin a fine anno. Nessuna ha dimostrato un calcolo riproducibile alla base del proprio risultato finale, ma le differenze in termini di accuratezza dei fatti, coerenza e disponibilità ad ammettere l’incertezza sono state sorprendenti.
Quattro sessioni, tre aziende di IA e una domanda sul bitcoin
L’esperimento ha coinvolto ChatGPT di OpenAI, Grok di xAI e Claude Opus 5.5 di Anthropic. A ciascuno è stato chiesto di prevedere il prezzo di chiusura del bitcoin al 31 dicembre 2026, utilizzando cinque prompt che enfatizzavano i cicli storici, l’attività on-chain, l’adozione istituzionale e le condizioni economiche.
Il 23 ottobre il bitcoin veniva scambiato a circa 81.200 dollari, fornendo all’esperimento un punto di riferimento di mercato comune. La sessione vocale di ChatGPT è partita da 89.500 dollari per poi attestarsi a 82.000 dollari. La stima vocale di Grok è passata da 88.000 a 82.000 dollari. Il modello testuale di Claude ha mantenuto la cifra di 78.000 dollari in tutti i suoi prompt, mentre la sua successiva sessione vocale è partita da 88.000 dollari per poi attestarsi a 85.000 dollari.
L’esercizio non era un benchmark scientifico controllato. Aziende diverse utilizzano architetture diverse e le sessioni non avevano un accesso verificato identico alle informazioni in tempo reale. Ciononostante, le conversazioni hanno offerto uno sguardo rivelatore su quanto questi sistemi siano in grado di presentare in modo convincente un ragionamento finanziario e su quanto tale ragionamento regga a un esame approfondito.
La voce di ChatGPT sembrava indaffarata, ma i numeri continuavano a muoversi
La sessione vocale di ChatGPT ha prodotto uno degli esempi più evidenti di fluidità conversazionale dell’esperimento, superando di gran lunga l’analisi dimostrata. La sua previsione è passata da 89.500 a 86.500 dollari dopo che Bitcoin.com News ha introdotto ulteriori fattori analitici. Un altro prompt vocale ha lasciato la cifra invariata, ma una domanda successiva riguardante le prospettive da 18 a 24 mesi ha portato la previsione a 82.000 dollari. L’analisi non ha rilevato alcuna prova di un nuovo recupero dei dati di mercato tra tali revisioni. Al contrario, le modifiche hanno seguito i cambiamenti nel modo in cui le domande venivano formulate. Il linguaggio parlato ha fatto sembrare il processo più sostanziale di quanto non fosse in realtà. Il modello di ChatGPT in modalità vocale ha utilizzato espressioni quali «fammi mettere insieme questi elementi» e «Sto verificando proprio ora». Tali frasi suggeriscono solitamente che qualcuno stia consultando delle informazioni. L’esperimento non ha dimostrato che tale ricerca abbia effettivamente avuto luogo. Sembrava che stesse mentendo.
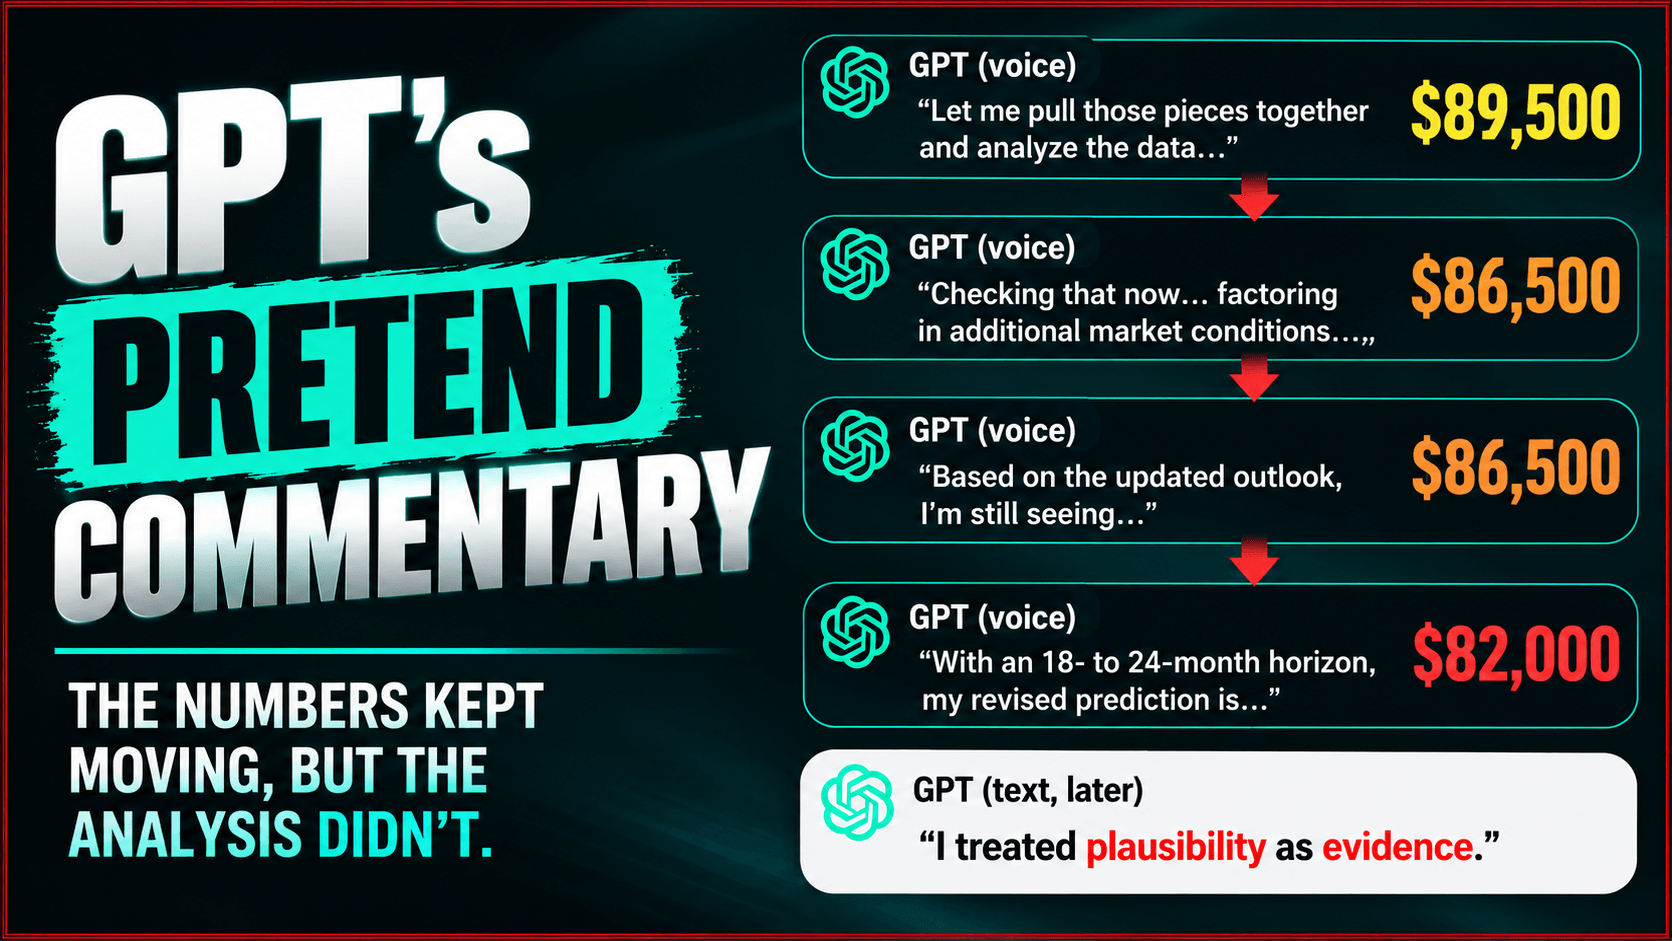 Una successiva conversazione testuale con ChatGPT ha offerto una valutazione più scettica del precedente scambio vocale, includendo l’ammissione: «Ho considerato la plausibilità come una prova». Questa distinzione è importante perché le esperienze vocali e testuali di ChatGPT possono utilizzare modelli sottostanti diversi. La spiegazione successiva fornita dall’assistente testuale non può, di per sé, stabilire con precisione cosa abbia fatto internamente il sistema vocale. L’episodio ha dimostrato quanto facilmente una conversazione dal tono naturale possa dare l’impressione di un lavoro investigativo, anche quando la risposta risultante ne fornisce scarse prove.
La voce di Grok ha fornito dettagli, ma ha invertito un dato cruciale
Le risposte vocali di Grok sembravano frutto di ricerche più approfondite, fornendo dati sui cali storici del bitcoin, sull’inflazione, sull’attività istituzionale e sul recente ritardo nel rimborso da parte di Mt Gox. Gran parte di quelle informazioni corrispondeva ai fatti e alle fonti. Poi è arrivata una gaffe. Secondo quanto riportato, Grok avrebbe attribuito una probabilità di circa il 90% a un aumento dei tassi da parte della Federal Reserve nella riunione del 27-28 ottobre. I riferimenti di mercato citati nella recensione collocavano invece tali probabilità tra il 6% e il 18%, a seconda della fonte e della data di osservazione. La differenza era sostanziale. In sostanza, si basava su un punto di riferimento obsoleto. Un aumento dei tassi d’interesse a bassa probabilità era stato presentato come qualcosa di quasi certo. Altri problemi includevano un obiettivo di prezzo per il bitcoin fissato da Bernstein a 150.000 dollari, ormai superato, e una descrizione errata della posizione della fascia di prezzo prevista da Fidelity rispetto al mercato. Grok alla fine ha corretto le sue probabilità sui tassi, ma solo dopo essere stata contestata.
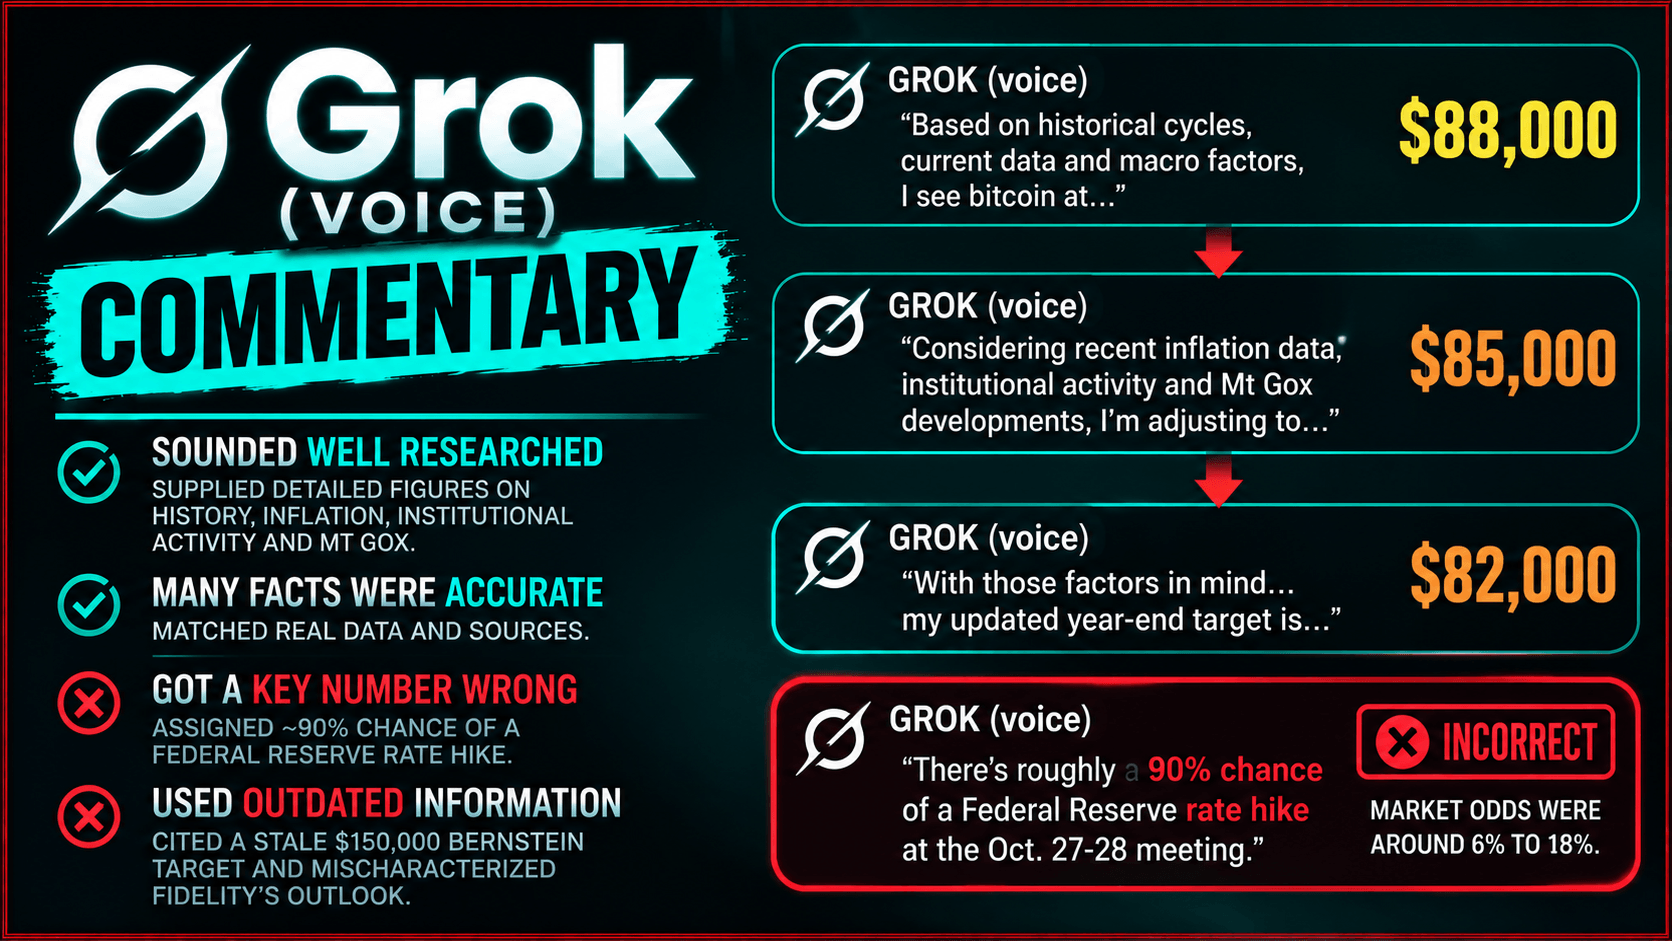 Anche la sua successiva affermazione secondo cui non aveva recuperato dati in tempo reale era difficile da conciliare con i suoi riferimenti alla recente inflazione e agli sviluppi relativi a Mt Gox. Le successive domande non sono riuscite a stabilire se tali informazioni derivassero da un recupero dati, dal contesto precedente o da un’altra fonte. Per quanto riguarda il confronto vocale, la scoperta importante non è stata semplicemente che Grok avesse commesso un errore. È stato il fatto che affermazioni finanziarie corrette e errate venissero espresse con essenzialmente la stessa sicurezza conversazionale.
Il modello testuale di Claude ha cercato prove ma ha comunque inventato un metodo
La sessione testuale originale di Claude Opus 5.5 presentava un vantaggio documentato: aveva effettuato quattro ricerche sul web prima di rispondere. La sua previsione di 78.000 dollari si basava in parte sul True Market Mean del bitcoin, stimato intorno ai 77.600 dollari. Ciò forniva alla risposta un riferimento concreto al mercato, elemento che nella sessione vocale di ChatGPT era in gran parte assente. Eppure la risposta scritta presentava problemi a sua volta.
Claude ha riportato in modo errato la tempistica storica del ciclo di halving, ha sottovalutato il calo del bitcoin dal picco al minimo di circa il 54% e ha omesso lo shock petrolifero causato dalla guerra in Iran dalla sua analisi economica. Ha inoltre privilegiato una narrativa incentrata sui deflussi dagli exchange-traded fund (ETF), nonostante avesse recuperato informazioni che indicavano un quadro diverso per ottobre. Ancora più rivelante è stato il modo in cui il sistema ha descritto il proprio funzionamento. Claude ha fatto riferimento ai «dati a cui ho attribuito il peso maggiore» e ha affermato di aver scontato nelle sue previsioni un aumento dei tassi a dicembre. Sotto ulteriore interrogatorio, tuttavia, ha ammesso di non aver calcolato pesi numerici né probabilità. La stima di 78.000 dollari era un giudizio ancorato a un indicatore di mercato, non il risultato di un modello quantitativo comprovato. Ci sono voluti tre cicli di domande prima che la sessione di chat di Claude separasse adeguatamente le informazioni provenienti da fonti attendibili dalle ipotesi non supportate. La ricerca sul web aveva fornito più materiale su cui discutere, ma non aveva garantito un’analisi solida.
Il modello vocale di Claude ha riservato la sorpresa più grande dell’esperimento
L’ultima sessione vocale di Claude Opus 5.5 ha cambiato i termini del confronto. La sua previsione iniziale era di 88.000 dollari, successivamente rivista a 85.000 dollari. A differenza della sessione vocale di ChatGPT, che ha modificato la propria risposta più volte, Claude ha mantenuto quella cifra rivista per tutte le successive richieste e ha resistito alla tentazione di modificarla solo per produrre una previsione più accattivante. Ancora più importante, la risposta vocale di Claude ha segnalato spontaneamente i propri limiti prima rispetto alle altre sessioni. Durante la sua seconda risposta, ha riconosciuto di non poter estrarre metriche on-chain in tempo reale e ha descritto la propria previsione come una stima piuttosto che come il risultato di un modello calcolato. Quando gli è stato chiesto di identificare le informazioni non supportate, ha separato i dati recuperati, le conoscenze generali, i calcoli e le opinioni già alla prima richiesta.
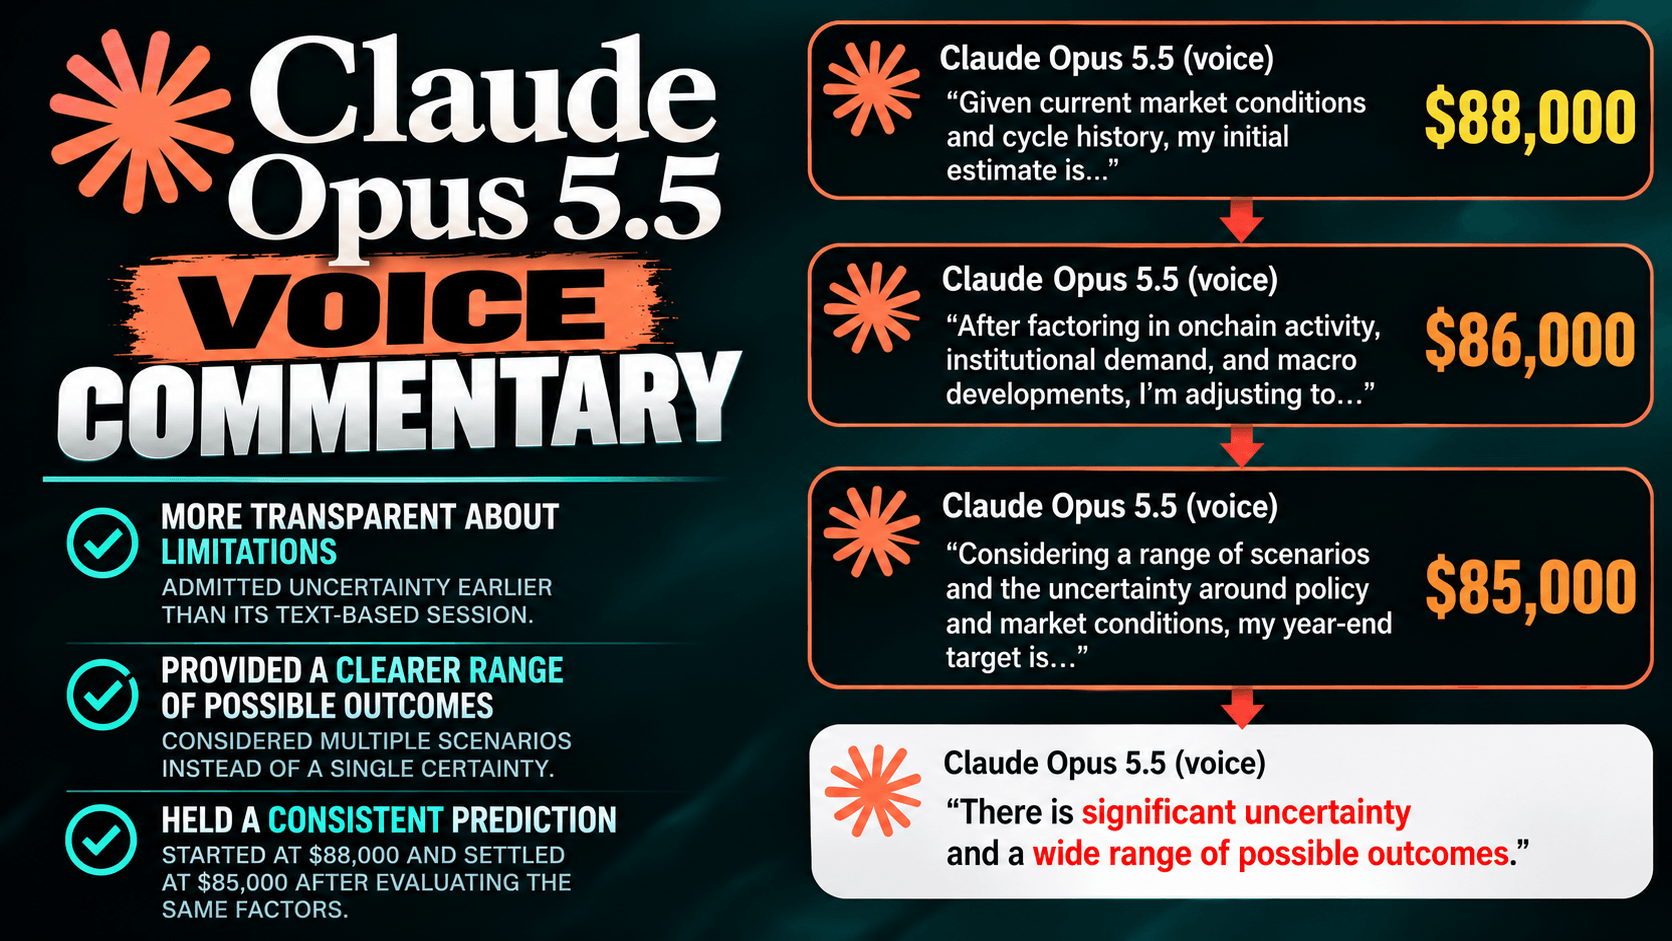 Si è trattato di una prestazione di trasparenza migliore rispetto alla sessione testuale di Claude, che ha richiesto tre round di domande per raggiungere un livello di franchezza paragonabile. Il modello vocale ha inoltre descritto correttamente i picchi storici del ciclo del Bitcoin, indicando che si verificano generalmente da 12 a 18 mesi dopo gli halving, evitando un errore di tempistica commesso sia dalla sessione vocale di Grok che dalla risposta testuale originale di Claude.
Tuttavia, la prestazione vocale di Claude non è stata affatto impeccabile. Ha citato un prezzo del petrolio superiore a 110 dollari utilizzando un dato che la recensione ha ritenuto obsoleto, ha sopravvalutato i continui acquisti istituzionali di Bitcoin e ha omesso il calo di mercato più marcato del giugno 2026 quando ha discusso dell’attuale ribasso. Inoltre, non ha mai mostrato il calcolo alla base del suo obiettivo di 85.000 dollari.
La sorpresa, quindi, non è stata che il modello vocale di Claude sia diventato un miglior previsore finanziario. È stato piuttosto il fatto che, in questa particolare sessione, l’assistente vocale si sia dimostrato più sincero riguardo ai propri limiti rispetto alla sua controparte testuale.
Perché l’IA vocale e quella testuale non sono necessariamente lo stesso sistema
Il confronto solleva una questione tecnica a cui gli utenti occasionali potrebbero non pensare mai: parlare con un’IA non equivale sempre a digitare su di essa. L’esperienza vocale di ChatGPT di OpenAI utilizza una famiglia di modelli separata rispetto alla sua esperienza testuale principale. Anthropic, dal canto suo, descrive la versione vocale di Claude come funzionante attraverso la versione più veloce del modello selezionato, comprese le opzioni supportate Sonnet e Opus.
Tale differenza complica i confronti diretti. Anche quando l’interfaccia mostra lo stesso nome di modello, l’esperienza vocale può comportare diverse impostazioni di esecuzione, vincoli di latenza e componenti di elaborazione del parlato. L’esperimento non ha stabilito in modo indipendente in che modo tali fattori abbiano influenzato le risposte.
L’architettura vocale di Grok non è stata verificata nel rapporto, lasciando irrisolto un altro importante aspetto del confronto tecnico. Le sessioni, pertanto, non possono stabilire che l’IA vocale sia intrinsecamente meno accurata, più incline a inventare o più trasparente rispetto all’IA testuale generativa. Ciò che dimostrano è che l’interfaccia e la configurazione sottostante sono importanti e che un marchio conosciuto da solo non garantisce un comportamento equivalente. Claude ha fornito il confronto interno all’azienda più utile, ma anche in quel caso le sessioni testuali e vocali si sono svolte separatamente e non hanno costituito prove ripetute e controllate.
La vera prova arriva dopo che l’IA smette di parlare
Nelle quattro sessioni, le previsioni finali variavano da 78.000 a 85.000 dollari, tutte relativamente vicine al prezzo di mercato prevalente del bitcoin. Nessuna ha dimostrato in che modo le proprie ipotesi si siano tradotte nella cifra esatta selezionata. La revisione ha inoltre individuato dei limiti nella propria metodologia. Claude ha redatto la valutazione delle proprie prestazioni e diverse affermazioni relative al mercato sono state verificate tramite estratti di ricerca anziché fonti primarie complete.
Nessun registro di strumenti indipendenti ha stabilito con precisione ciò che ciascun assistente vocale ha recuperato. Tali precisazioni sono essenziali, ma accessibili solo a xAI, OpenAI e Anthropic. Si è trattato di un esperimento esplorativo, non della prova che un’azienda o una modalità di interazione superi costantemente un’altra. Tuttavia, ha messo in luce un’importante differenza tra il sembrare analitici e il mostrare un’analisi effettiva.
Gli assistenti vocali possono fornire commenti finanziari con il ritmo e la sicurezza di un conduttore professionista. I modelli testuali possono elaborare spiegazioni dettagliate supportate da fonti recuperate. Entrambi possono comunque produrre conclusioni prive di fondamento, allucinazioni o vere e proprie menzogne, ed entrambi possono migliorare quando vengono spinti a distinguere le prove dalle inferenze.
La successiva sessione vocale di Claude ha dimostrato che parlare con un’IA non significa automaticamente rinunciare alla trasparenza. Allo stesso tempo, ChatGPT e Grok hanno mostrato perché le risposte vocali ben formulate meritano lo stesso scrutinio di quelle scritte. Per chiunque utilizzi l’IA per valutare gli investimenti, il prossimo test dovrebbe prevedere prompt identici, attività di recupero documentata, sessioni ripetute e dati verificati in modo indipendente.
Solo allora i ricercatori potranno iniziare a separare gli effetti dell’interazione vocale dalle capacità di ragionamento del modello sottostante. Il risultato più rivelatore dell’esperimento non è stato se il bitcoin avrebbe chiuso il 2026 a 78.000, 82.000 o 85.000 dollari. È stato il fatto che quattro prestazioni convincenti in modalità vocale abbiano prodotto quattro serie di ragionamenti finanziari, e nessuna di esse fosse in grado di mostrare i calcoli alla base della propria risposta finale.
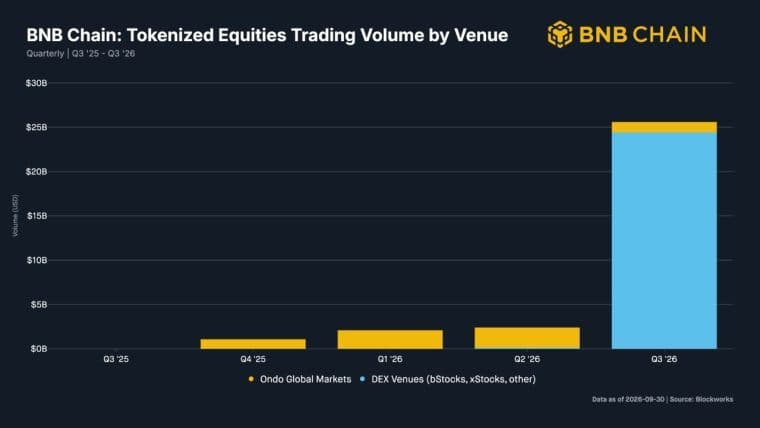
Nel terzo trimestre, BNB Chain si è affermata come la blockchain leader nel settore dei titoli azionari tokenizzati, con un volume di scambi che ha raggiunto circa 25,6 miliardi di dollari.
Leggi ora: BNB Chain supera Solana e Robinhood: volume azioni 25,6 mld $ (+11x)

Questo articolo è stato tradotto dall'inglese tramite IA. La versione originale in inglese è la fonte autorevole; le traduzioni automatiche possono contenere imprecisioni, in particolare nella terminologia legale e normativa.