¿Es capaz la inteligencia artificial (IA) de pensar tan bien en voz alta como lo hace por escrito? Un experimento de predicción sobre el bitcoin llevado a cabo por Bitcoin.com News puso a prueba a ChatGPT, Grok y Claude Opus 5.5, sacando a la luz predicciones poco fiables, razonamientos cuestionables y un giro sorprendente: el modelo de voz de Claude demostró ser más transparente sobre sus limitaciones que su homólogo basado en texto.
Grok, GPT y Claude con voz adivinan el precio del bitcoin
ESCRITO POR

COMPARTIR
Puntos clave
- Tanto la versión de voz de ChatGPT como la de Grok terminaron en 82 000 dólares, pero sus explicaciones presentaban importantes deficiencias.
- La versión de voz de Claude Opus 5.5 reveló sus limitaciones antes que su sesión de texto, que predijo 78 000 dólares.
- Las cuatro sesiones de IA carecían de cálculos de precios reproducibles, lo que dejó sin resolver la cuestión de la precisión entre la versión de voz y la de texto.
El experimento que puso a prueba las habilidades de habla y escritura de la IA
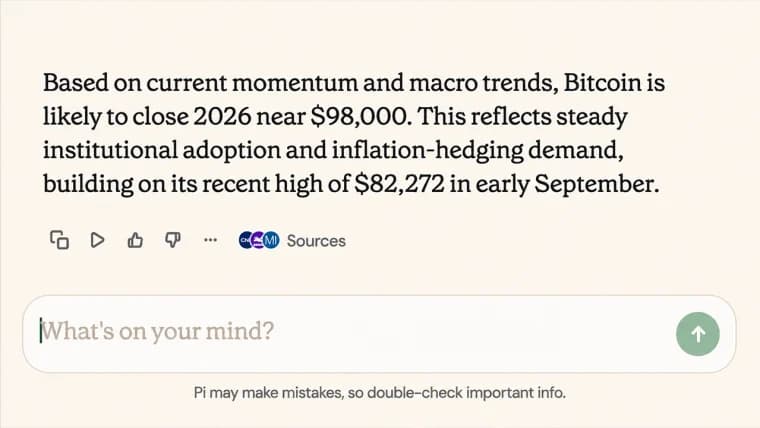
La inteligencia artificial (IA) puede mantener una conversación, sonar como un analista financiero y ofrecer una predicción del precio del bitcoin sin perder el ritmo. Pero, ¿hablar con una IA produce la misma calidad de razonamiento que escribirle una pregunta? Un experimento realizado el 23 de octubre de 2026 puso a prueba esa pregunta, y las respuestas distaron mucho de ser sencillas. Se interrogó a ChatGPT y a Grok a través de interfaces de voz, mientras que Claude Opus 5.5 funcionó inicialmente mediante texto. Una sesión de voz posterior con Claude Opus 5.5 aportó una comparación reveladora. Los cuatro proporcionaron precios específicos del bitcoin para finales de año. Ninguno demostró un cálculo reproducible detrás de su cifra final, pero las diferencias en cuanto a precisión de los datos, coherencia y disposición a admitir la incertidumbre fueron llamativas.
Cuatro sesiones, tres empresas de IA y una pregunta sobre el bitcoin
En el ejercicio participaron ChatGPT de OpenAI, Grok de xAI y Claude Opus 5.5 de Anthropic. A cada uno se le pidió que predijera el precio de cierre del bitcoin el 31 de diciembre de 2026, utilizando cinco indicaciones que hacían hincapié en los ciclos históricos, la actividad en la cadena de bloques, la adopción institucional y las condiciones económicas.
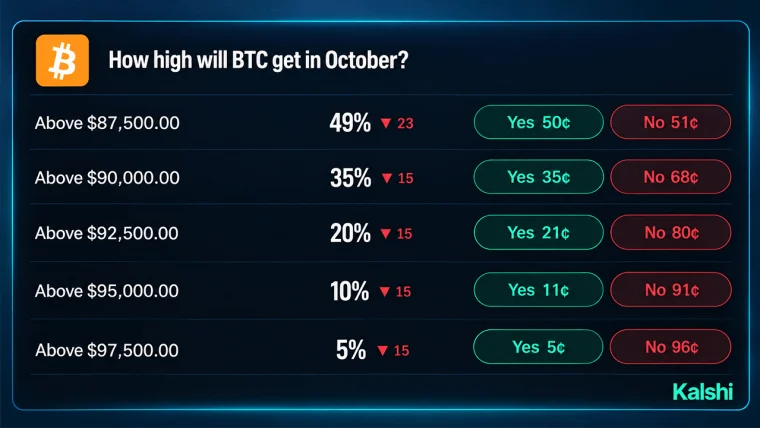
El bitcoin cotizaba cerca de los 81 200 dólares el 23 de octubre, lo que proporcionó al experimento una referencia de mercado común. La sesión de voz de ChatGPT comenzó en 89 500 dólares y finalmente se situó en 82 000 dólares. La estimación oral de Grok pasó de 88 000 dólares a 82 000 dólares. El modelo de texto de Claude se mantuvo en 78 000 dólares en todas sus indicaciones, mientras que su posterior sesión de voz comenzó en 88 000 dólares antes de estabilizarse en 85 000 dólares.
El ejercicio no fue una prueba comparativa científica controlada. Las distintas empresas utilizan arquitecturas diferentes, y las sesiones no contaban con un acceso verificado idéntico a la información en tiempo real. No obstante, las conversaciones ofrecieron una visión reveladora de la capacidad de estos sistemas para presentar un razonamiento financiero convincente y de hasta qué punto ese razonamiento resiste un análisis riguroso.
La voz de ChatGPT parecía atareada, pero las cifras no dejaban de variar
La sesión de voz de ChatGPT ofreció uno de los ejemplos más claros del experimento en cuanto a fluidez conversacional, adelantándose con creces al análisis demostrado. Su previsión pasó de 89 500 dólares a 86 500 dólares después de que Bitcoin.com News introdujera factores analíticos adicionales. Otra indicación verbal dejó la cifra sin cambios, pero una pregunta posterior sobre las perspectivas para un plazo de 18 a 24 meses redujo la predicción a 82 000 dólares. La revisión no encontró pruebas de que se hubieran consultado nuevos datos de mercado entre esas revisiones. En cambio, los cambios se debieron a modificaciones en la forma en que se planteaban las preguntas. El lenguaje hablado hizo que el proceso pareciera más sustancial de lo que realmente era. El modelo de ChatGPT en modo de voz utilizó expresiones como «déjame reunir esos datos» y «Lo estoy comprobando ahora». Esas frases suelen sugerir que alguien está consultando información. El experimento no demostró que se hubiera llevado a cabo ninguna investigación de ese tipo. Parecía estar mintiendo.
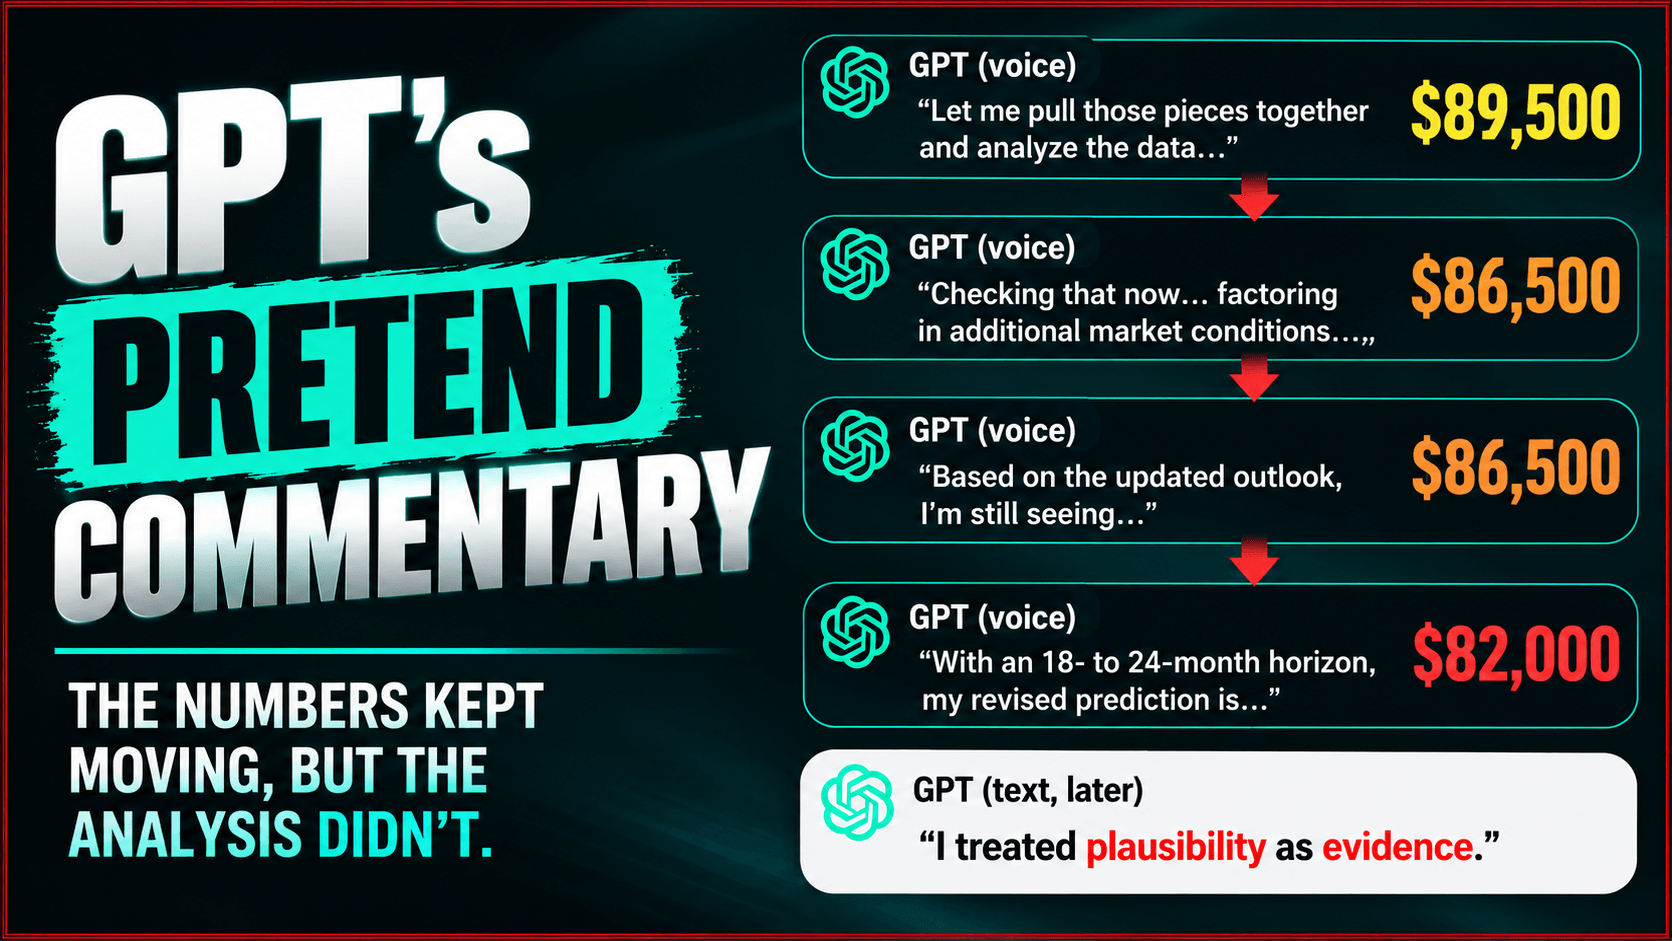 Una conversación posterior con ChatGPT basada en texto ofreció una valoración más escéptica del intercambio de voz anterior, incluyendo la admisión: «Consideré la verosimilitud como prueba». Esa distinción es importante porque las experiencias de voz y texto de ChatGPT pueden utilizar modelos subyacentes diferentes. La explicación posterior del asistente de texto no puede, por sí sola, determinar con precisión qué hizo el sistema de voz a nivel interno. El episodio demostró lo fácil que es que una conversación que suena natural dé la impresión de ser un trabajo de investigación, incluso cuando la respuesta resultante aporta pocas pruebas de ello.
La voz de Grok proporcionó detalles, pero se equivocó en una cifra crucial
Las respuestas habladas de Grok parecían estar más bien documentadas, ya que proporcionaban cifras sobre las caídas históricas del bitcoin, la inflación, la actividad institucional y el reciente retraso en los reembolsos de Mt. Gox. Gran parte de esa información coincidía con los hechos y las fuentes. Pero entonces llegó la sorpresa. Según se informó, Grok asignó una probabilidad de aproximadamente el 90 % a una subida de tipos por parte de la Reserva Federal en la reunión del 27 al 28 de octubre. En cambio, las referencias de mercado del análisis situaban esas probabilidades entre el 6 % y el 18 %, dependiendo de la fuente y la fecha de observación. La diferencia era sustancial. Básicamente, se basaba en un punto de referencia obsoleto. Una subida de los tipos de interés con baja probabilidad se había presentado como algo casi seguro. Otros problemas incluían un objetivo obsoleto de Bernstein para el bitcoin de 150 000 dólares y una descripción incorrecta de dónde se situaba el rango de precios previsto por Fidelity en relación con el mercado. Grok acabó corrigiendo sus probabilidades sobre los tipos de interés, pero solo después de que se le cuestionara.
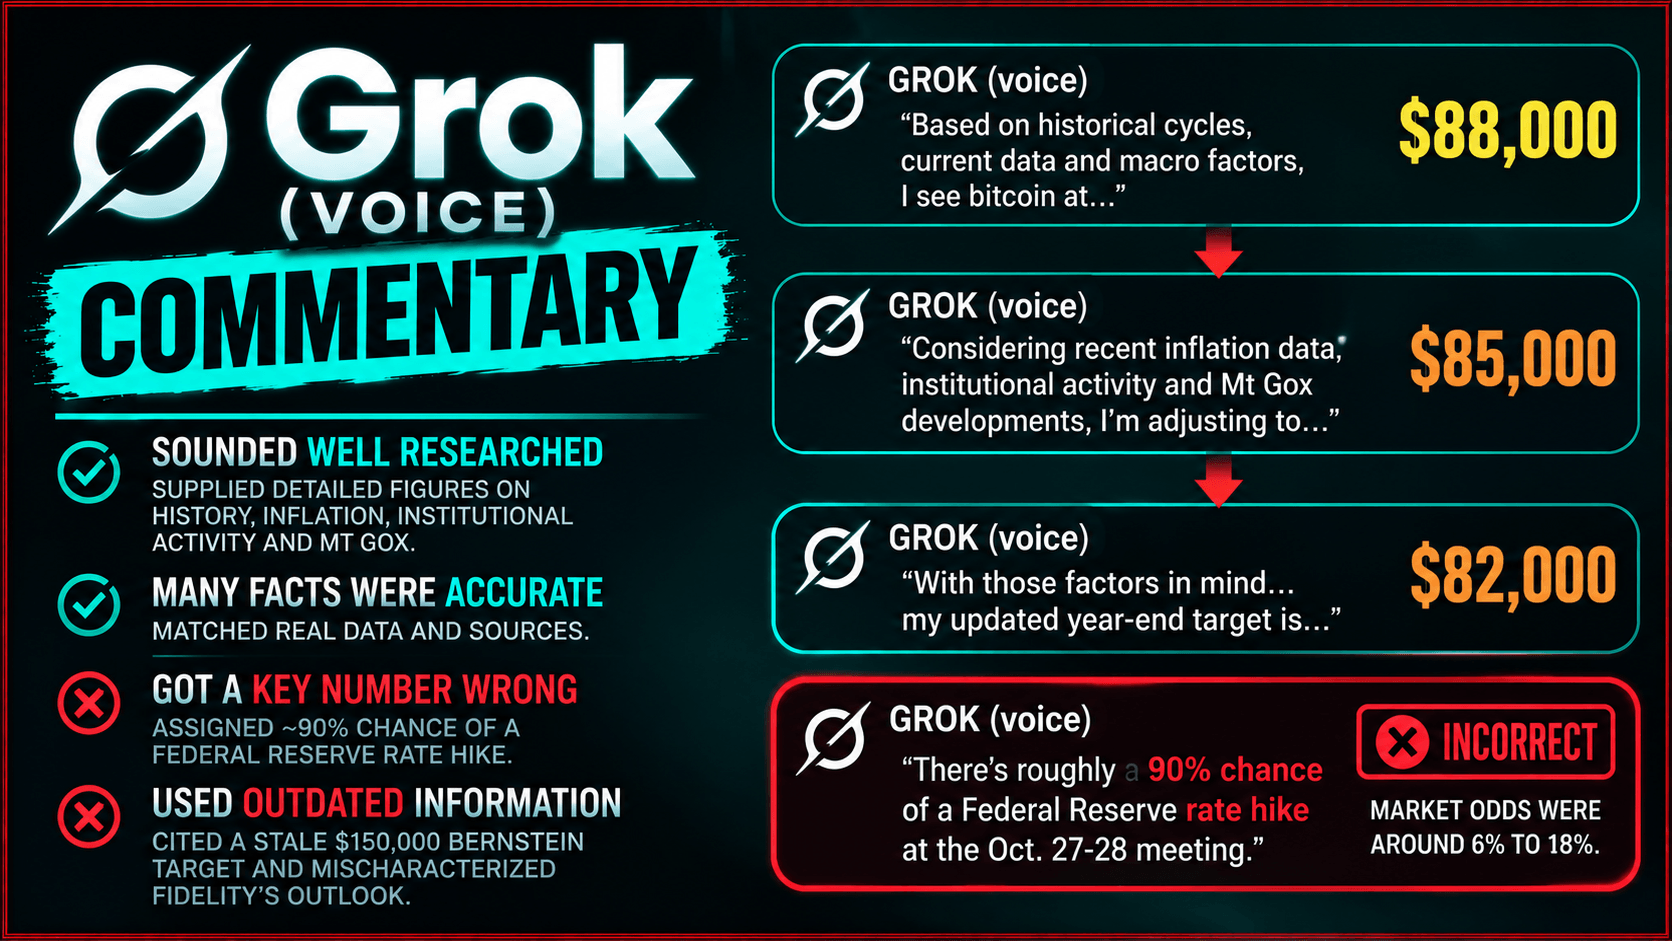 Su afirmación posterior de que no había recuperado datos en tiempo real también resultaba difícil de conciliar con sus referencias a la inflación reciente y a los acontecimientos relacionados con Mt. Gox. El interrogatorio posterior no pudo determinar si esa información procedía de la recuperación de datos, del contexto previo o de otra fuente. En cuanto a la comparación de voces, la conclusión importante no fue simplemente que Grok cometiera un error, sino que las afirmaciones financieras correctas e incorrectas se expresaban con prácticamente la misma seguridad conversacional.
El modelo de texto de Claude buscó pruebas, pero aun así inventó un método
La sesión de texto original de Claude Opus 5.5 tenía una ventaja documentada: realizó cuatro búsquedas en la web antes de responder. Su predicción de 78 000 dólares se basó en parte en la «media real de mercado» del bitcoin, estimada en cerca de 77 600 dólares. Eso dotó a la respuesta de una referencia de mercado concreta, algo de lo que carecía en gran medida la sesión de voz de ChatGPT. Sin embargo, la respuesta escrita tenía sus propios problemas.
Claude se equivocó al indicar los plazos históricos del ciclo de halving, subestimó la caída de aproximadamente el 54 % del bitcoin desde su máximo hasta su mínimo y omitió la crisis del petróleo provocada por la guerra de Irán en su análisis económico. Además, se decantó por una narrativa de salida de fondos de los fondos cotizados en bolsa (ETF), a pesar de haber recuperado información que indicaba un panorama diferente para octubre. Más revelador fue cómo el sistema describió su funcionamiento. Claude se refirió a «los datos a los que di mayor peso» y afirmó haber tenido en cuenta en su previsión una subida de los tipos de interés en diciembre. Sin embargo, al ser interrogado más a fondo, reconoció que no había calculado ponderaciones numéricas ni probabilidades. La estimación de 78 000 dólares era una valoración basada en un indicador de mercado, no el resultado de un modelo cuantitativo contrastado. Fueron necesarias tres rondas de preguntas antes de que la sesión de chat con Claude lograra separar adecuadamente la información contrastada de las suposiciones sin fundamento. La búsqueda en la web había proporcionado más material para debatir, pero no había garantizado un análisis sólido.
El modelo de voz de Claude deparó la mayor sorpresa del experimento
La última sesión de voz de Claude Opus 5.5 cambió el panorama. Su predicción inicial fue de 88 000 dólares, revisada posteriormente a 85 000 dólares. A diferencia de la sesión de voz de ChatGPT, que cambió su respuesta en múltiples ocasiones, Claude mantuvo esa cifra revisada a lo largo de las preguntas restantes y se resistió a ajustarla simplemente para ofrecer una previsión más llamativa. Y lo que es más importante, la respuesta de voz de Claude señaló sus limitaciones de forma espontánea antes que en las otras sesiones. Durante su segunda respuesta, reconoció que no podía obtener métricas en tiempo real de la cadena de bloques y describió su predicción como una estimación, en lugar de como el resultado de un modelo calculado. Cuando se le pidió que identificara la información no contrastada, separó las cifras recuperadas, los conocimientos generales, los cálculos y las opiniones ya en la primera solicitud.
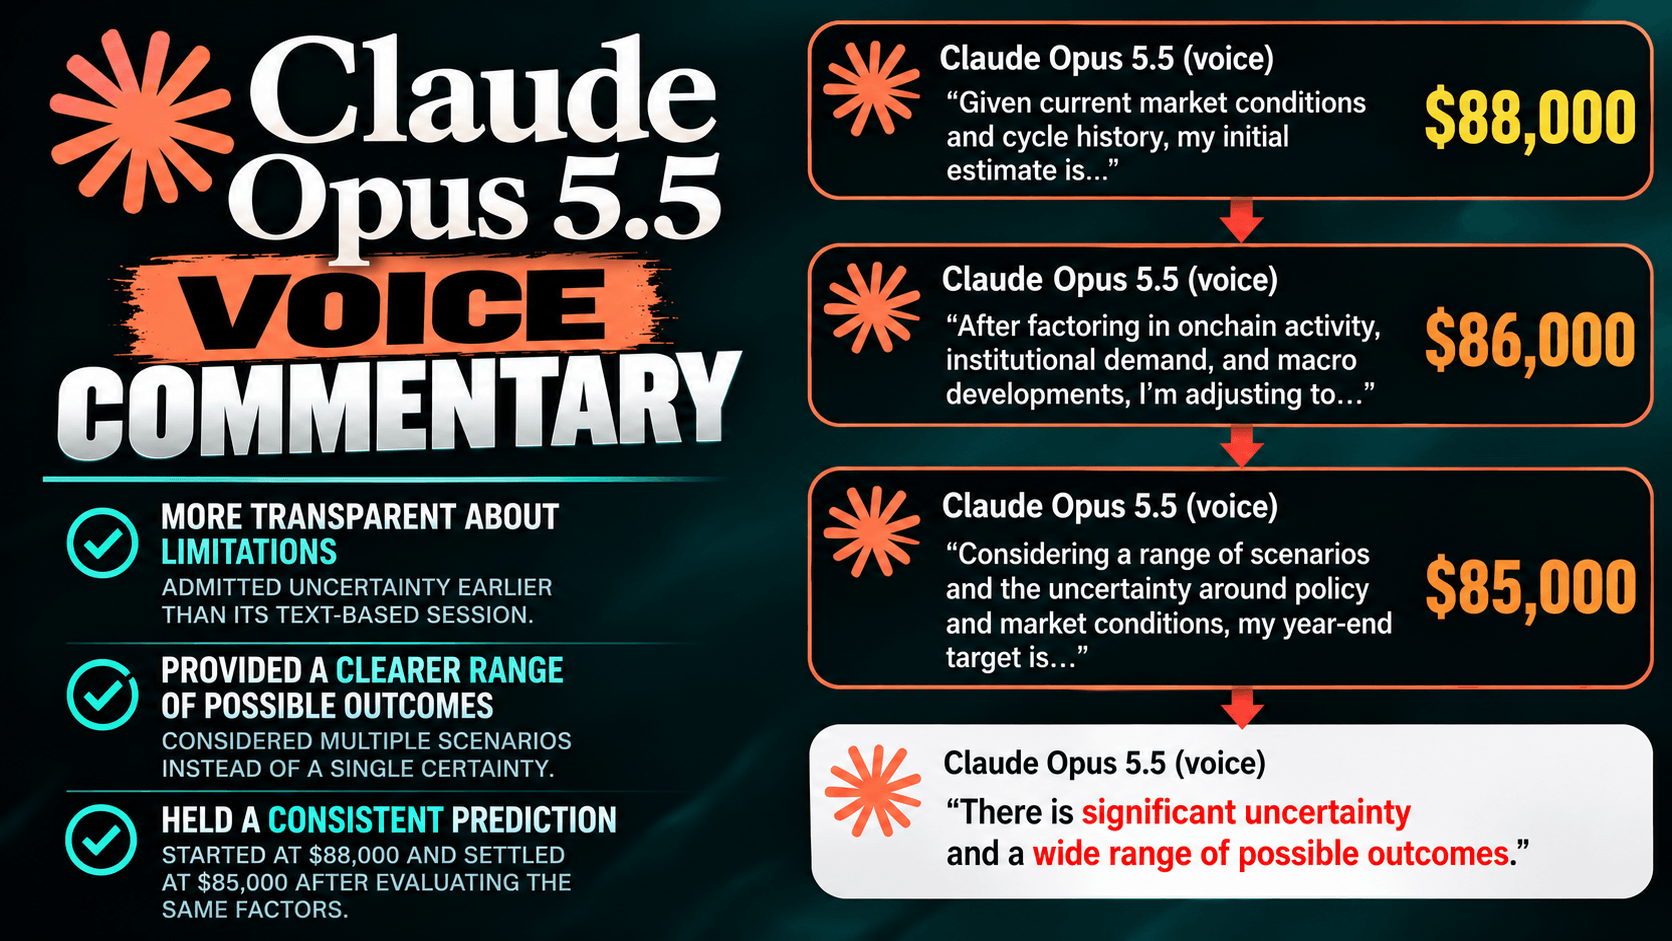 Este fue un mejor rendimiento en materia de transparencia que el de la propia sesión de texto de Claude, que requirió tres rondas de preguntas para alcanzar un nivel comparable de franqueza. El modelo de voz también describió correctamente los picos históricos del ciclo del bitcoin, indicando que suelen producirse entre 12 y 18 meses después de las reducciones a la mitad, evitando así un error de sincronización cometido tanto por la sesión de voz de Grok como por la respuesta de texto original de Claude.
Aun así, el rendimiento de la voz de Claude distó mucho de ser impecable. Citó un precio del petróleo superior a los 110 dólares utilizando una cifra que la revisión consideró obsoleta, exageró las continuas compras institucionales de bitcoin y omitió la caída más profunda del mercado de junio de 2026 al analizar la actual corrección. Tampoco mostró en ningún momento el cálculo que dio lugar a su objetivo de 85 000 dólares.
La sorpresa, pues, no fue que el modelo de voz de Claude se convirtiera en un mejor pronosticador financiero. Fue que, en esta sesión en concreto, el asistente de voz se mostró más sincero sobre sus limitaciones que su homólogo de texto.
Por qué la IA de voz y la de texto no son necesariamente el mismo sistema
La comparación plantea una cuestión técnica que los usuarios ocasionales quizá nunca se planteen: hablar con una IA no siempre equivale a escribirle. La experiencia de voz de ChatGPT de OpenAI utiliza una familia de modelos distinta de la de su experiencia principal basada en texto. Anthropic, por su parte, describe la versión de voz de Claude como un sistema que funciona a través de la versión más rápida del modelo seleccionado, incluidas las opciones compatibles de Sonnet y Opus.
Esa diferencia complica las comparaciones directas. Incluso cuando la interfaz muestra el mismo nombre de modelo, la experiencia de voz puede implicar diferentes configuraciones de ejecución, restricciones de latencia y componentes de procesamiento del habla. El experimento no determinó de forma independiente cómo afectaban esos factores a las respuestas.
La arquitectura de voz de Grok no se verificó en el informe, lo que deja sin resolver otro aspecto importante de la comparación técnica. Por lo tanto, las sesiones no pueden demostrar que la IA de voz sea intrínsecamente menos precisa, más propensa a inventarse cosas o más transparente que la IA generativa de texto. Lo que sí muestran es que la interfaz y la configuración subyacente son importantes, y que una marca conocida por sí sola no garantiza un comportamiento equivalente. Claude proporcionó la comparación interna más útil, pero incluso en ese caso, las sesiones de texto y de voz se llevaron a cabo por separado y no constituyeron ensayos repetidos y controlados.
La verdadera prueba llega cuando la IA deja de hablar
A lo largo de las cuatro sesiones, las previsiones finales oscilaron entre los 78 000 y los 85 000 dólares, todas ellas relativamente cercanas al precio de mercado vigente del bitcoin. Ninguna demostró cómo sus supuestos se traducían en la cifra exacta que seleccionó. La revisión también identificó limitaciones en su propia metodología. Claude redactó la evaluación de su rendimiento, y varias afirmaciones sobre el mercado se verificaron a través de extractos de búsquedas en lugar de fuentes primarias completas.
Ningún registro de herramientas independientes estableció con precisión qué recuperaba cada asistente de voz. Esas salvedades son esenciales, pero solo están al alcance de xAI, OpenAI y Anthropic. Se trató de un experimento exploratorio, no de una prueba de que una empresa o un modo de interacción supere sistemáticamente a otro. Pero sí puso de manifiesto una diferencia importante entre parecer analítico y mostrar un análisis real.
Los asistentes de voz pueden ofrecer comentarios financieros con el ritmo y la seguridad de un locutor profesional. Los modelos de texto pueden elaborar explicaciones detalladas respaldadas por las fuentes consultadas. Ambos pueden seguir generando conclusiones sin fundamento, «alucinaciones» o mentiras descaradas, y ambos pueden mejorar cuando se les exige distinguir entre pruebas e inferencias.
La sesión de voz posterior de Claude demostró que hablar con una IA no implica automáticamente sacrificar la transparencia. Al mismo tiempo, ChatGPT y Grok demostraron por qué las respuestas orales pulidas merecen el mismo escrutinio que las escritas. Para cualquiera que utilice la IA para evaluar inversiones, la próxima prueba debería requerir indicaciones idénticas, actividad de búsqueda documentada, sesiones repetidas y cifras verificadas de forma independiente.
Solo entonces podrán los investigadores empezar a separar los efectos de la interacción por voz de las capacidades de razonamiento del modelo subyacente. El resultado más revelador del experimento no fue si el bitcoin terminaría el año 2026 en 78 000, 82 000 o 85 000 dólares. Fue que cuatro actuaciones convincentes en modo de voz produjeron cuatro conjuntos de razonamiento financiero, y ni uno solo pudo mostrar los cálculos matemáticos que sustentaban su respuesta final.
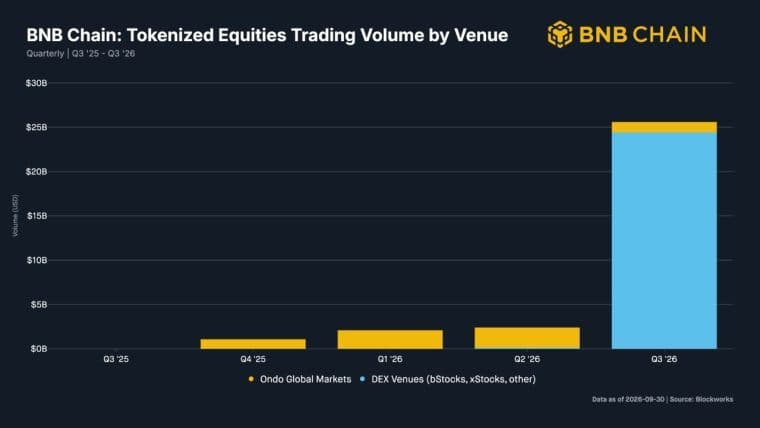
BNB Chain se situó como la cadena de bloques líder en acciones tokenizadas durante el tercer trimestre, con un volumen de negociación que se disparó hasta alcanzar unos 25 600 millones de dólares.
Leer ahora: BNB Chain supera a Solana y Robinhood: acciones x11 a $25.600 millones

Este artículo fue traducido del inglés mediante IA. La versión original en inglés es la fuente autorizada; las traducciones automáticas pueden contener imprecisiones, especialmente en la terminología legal y regulatoria.