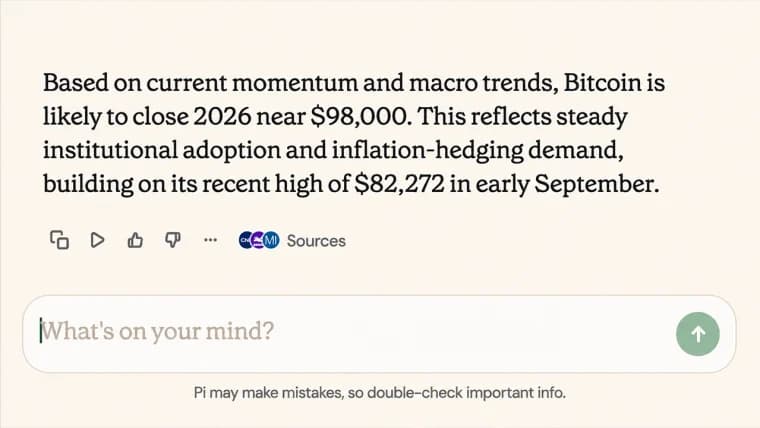
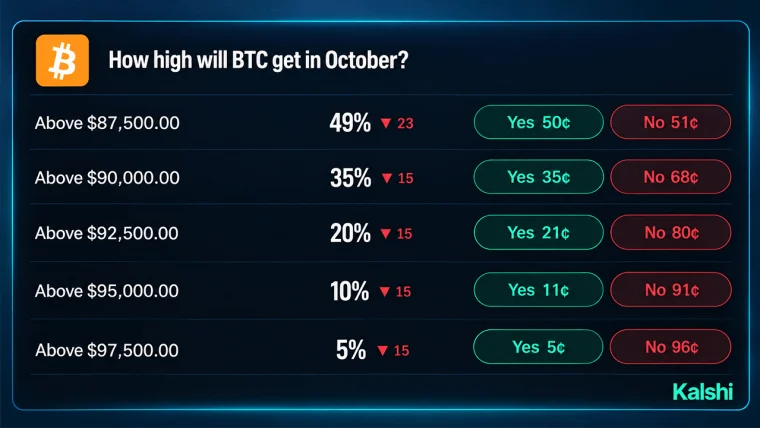
Чи може штучний інтелект (ШІ) мислити вголос так само добре, як і на письмі? Експеримент з прогнозування курсу біткойна, проведений Bitcoin.com News, перевірив ChatGPT, Grok та Claude Opus 5.5, виявивши непевні прогнози, сумнівні міркування та несподіваний поворот: голосова модель Claude виявилася більш відвертою щодо своїх обмежень, ніж її текстовий аналог.
«Tell Me Lies»: Grok, GPT і Claude вгадують ціну біткойна
АВТОР

ПОДІЛИТИСЯ
Основні висновки
- Голосові версії ChatGPT та Grok обидві дали результат у 82 000 доларів, але їхні пояснення містили суттєві недоліки.
- Голосова версія Claude Opus 5.5 розкрила свої обмеження раніше, ніж її текстова версія, яка прогнозувала ціну 78 000 доларів.
- Усі 4 сесії ШІ не містили відтворюваних розрахунків ціни, тому питання точності голосових та текстових моделей залишилося невирішеним.
Експеримент, який перевірив навички ШІ у розмові та наборі тексту
Штучний інтелект (ШІ) може вести розмову, звучати як фінансовий аналітик і надавати прогноз ціни біткойна, не збиваючись із ритму. Але чи дає розмова зі ШІ таку саму якість міркувань, як введення запитання в текстовому режимі? Експеримент, проведений 23 жовтня 2026 року, перевірив це питання, і відповіді виявилися далеко не однозначними.
ChatGPT та Grok опитували через голосові інтерфейси, тоді як Claude Opus 5.5 спочатку працював у текстовому режимі. Наступна голосова сесія з Claude Opus 5.5 додала показове порівняння. Усі чотири системи надали конкретні ціни на біткойн на кінець року. Жодна з них не продемонструвала відтворюваного розрахунку, що лежав у основі кінцевого числа, але відмінності у фактичній точності, послідовності та готовності визнати невизначеність були вражаючими.
Чотири сесії, три компанії з штучного інтелекту та одне запитання про біткойн
У тестуванні брали участь ChatGPT від OpenAI, Grok від xAI та Claude Opus 5.5 від Anthropic. Кожному з них було запропоновано передбачити ціну закриття біткойна 31 грудня 2026 року, використовуючи п’ять підказок, що акцентували увагу на історичних циклах, активності в ланцюжку, інституційному впровадженні та економічних умовах.
23 жовтня біткойн торгувався на рівні близько 81 200 доларів, що дало експерименту загальний ринковий орієнтир. Голосова сесія ChatGPT розпочалася з позначки 89 500 доларів і зрештою зупинилася на 82 000 доларів. Голосова оцінка Grok коливалася від 88 000 до 82 000 доларів. Текстова модель Claude у своїх підказках дотримувалася позначки 78 000 доларів, тоді як її пізніша голосова сесія розпочалася з 88 000 доларів, а потім стабілізувалася на рівні 85 000 доларів.
Це завдання не було контрольованим науковим тестом. Різні компанії використовують різні архітектури, і сесії не мали однакового перевіреного доступу до актуальної інформації. Проте ці розмови дали змогу наочно побачити, наскільки переконливо ці системи можуть викладати фінансові міркування та наскільки добре ці міркування витримують ретельну перевірку.
Голос ChatGPT звучав метушливо, але цифри продовжували змінюватися
Голосова сесія ChatGPT стала одним із найяскравіших прикладів розмовної плавності в експерименті, значно випередивши продемонстрований аналіз. Її прогноз змінився з 89 500 до 86 500 доларів після того, як Bitcoin.com News ввів додаткові аналітичні фактори. Ще одна усна підказка не змінила цифру, але пізніше запитання щодо прогнозу на 18–24 місяці знизило прогноз до 82 000 доларів.
Аналіз не виявив жодних доказів оновлення ринкових даних між цими коригуваннями. Натомість зміни відбувалися відповідно до змін у формулюванні запитань. Усна мова робила процес більш вагомим, ніж він був насправді. Модель ChatGPT у голосовому режимі використовувала вирази, зокрема «дозвольте мені зібрати ці фрагменти воєдино» та «Зараз перевіряю це». Ці фрази зазвичай натякають на те, що хтось звертається до інформації. Експеримент не підтвердив, що таке дослідження відбувалося. Складалося враження, що система брехала.
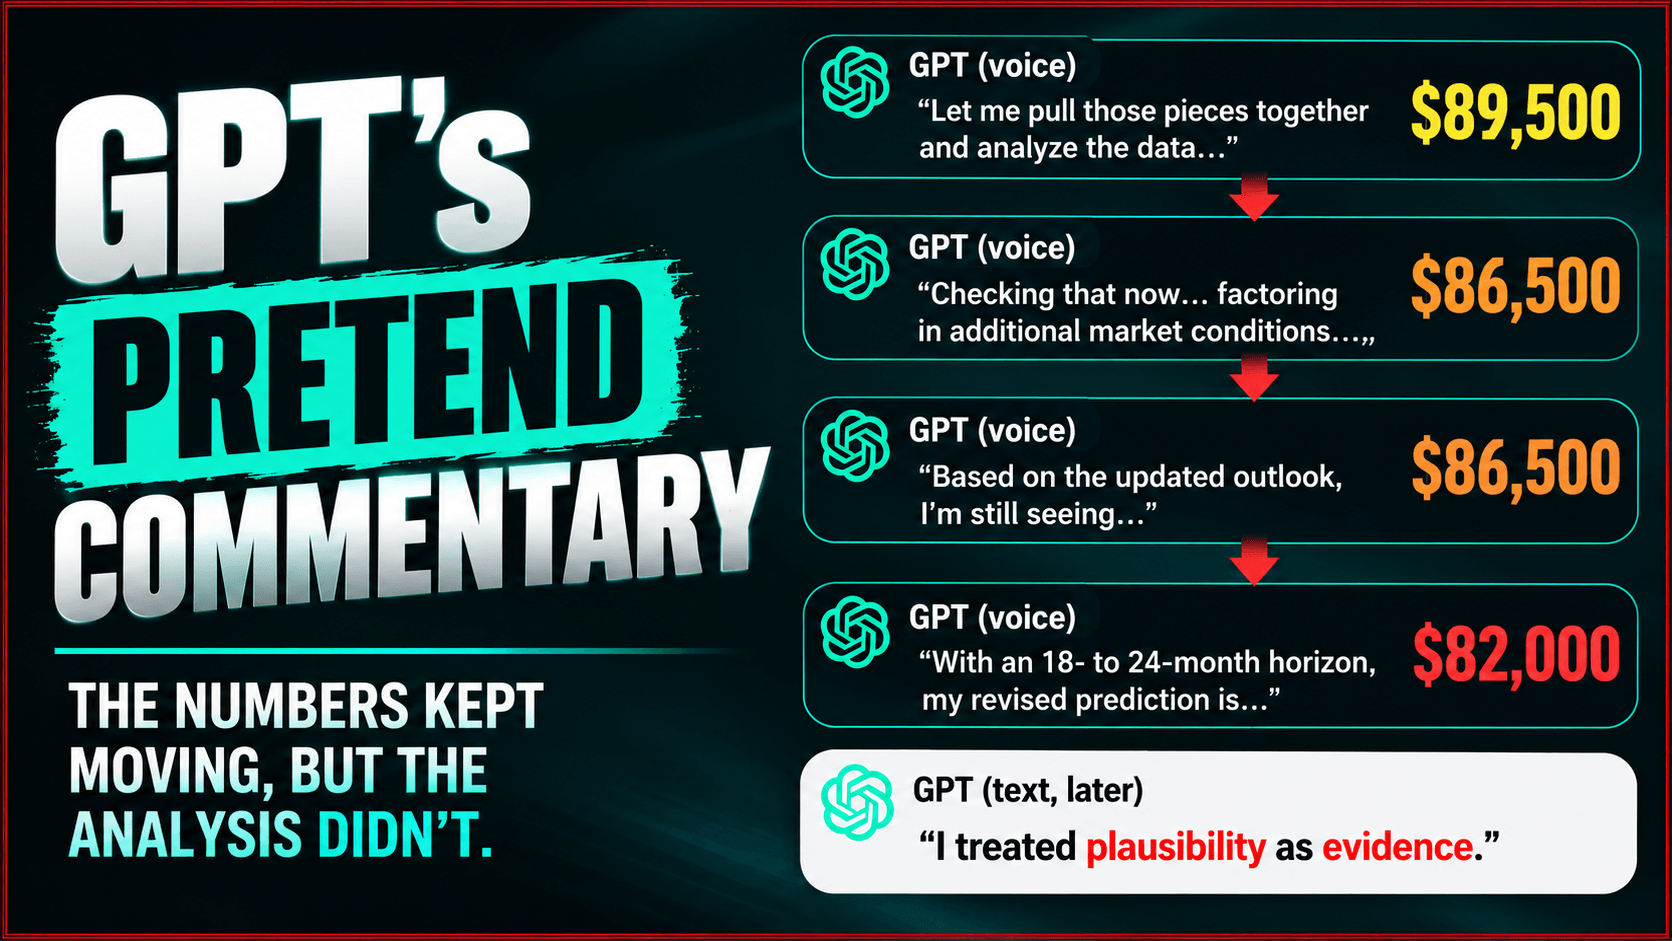
Наступна текстова розмова з ChatGPT містила більш скептичну оцінку попереднього голосового діалогу, зокрема визнання: «Я сприймав правдоподібність як доказ». Це розрізнення має значення, оскільки голосовий та текстовий режими ChatGPT можуть використовувати різні базові моделі. Пізніше пояснення текстового помічника саме по собі не може точно встановити, що саме відбувалося всередині голосової системи.
Цей випадок продемонстрував, як легко природно звучача розмова може створити враження проведення розслідування, навіть якщо отримана відповідь майже не містить доказів цього.
Голос Grok надав деталі, але переплутав одне важливе число
Усні відповіді Grok звучали більш ґрунтовно дослідженими, надаючи цифри щодо історичних падінь біткойна, інфляції, діяльності інституційних інвесторів та нещодавньої затримки з виплатами Mt Gox. Більша частина цієї інформації відповідала фактам та джерелам. А потім сталася несподіванка. Як повідомляється, Grok приписав приблизно 90% ймовірності підвищення ставки Федерального резерву на засіданні 27–28 жовтня. Натомість ринкові дані, на які посилався огляд, вказували на ймовірність у межах від 6% до 18%, залежно від джерела та дати спостереження.
Різниця була суттєвою. По суті, було взято дані зі старішого джерела. Підвищення процентної ставки з низькою ймовірністю було подано як щось майже напевне. Серед інших проблем — застаріла цільова ціна біткойна від Bernstein у розмірі 150 000 доларів та неправильний опис того, де прогностичний ціновий діапазон Fidelity знаходився відносно ринку. Зрештою Grok виправив свої оцінки ймовірності підвищення ставки, але лише після того, як йому було висунуто заперечення.
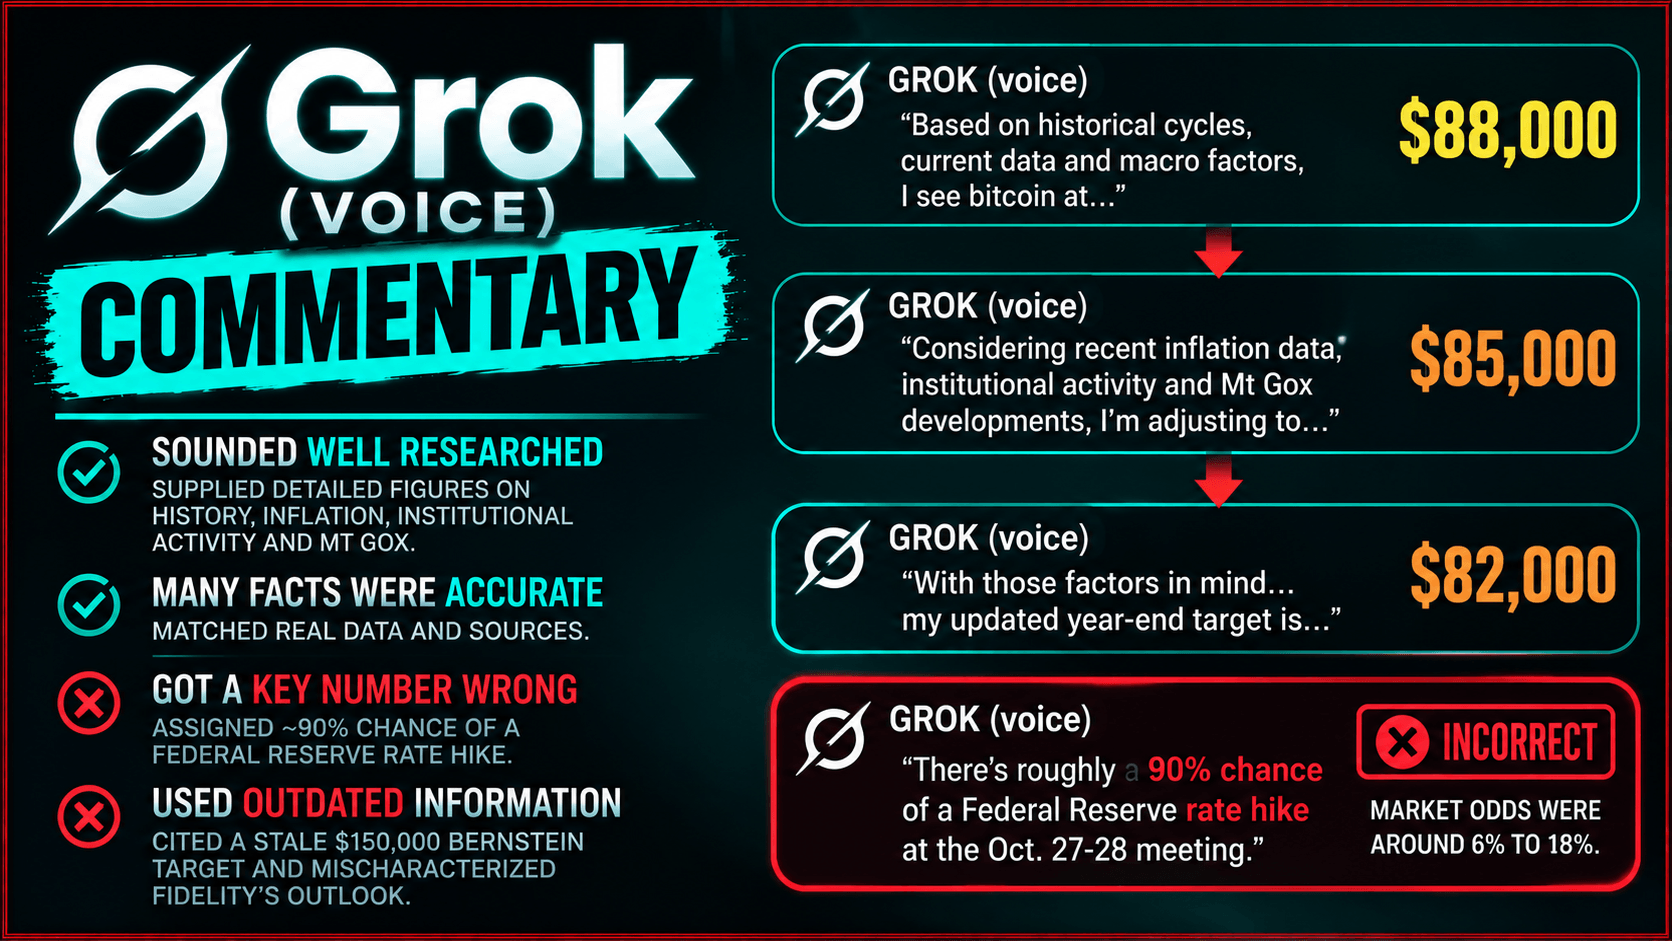
Її пізніша заява про те, що вона не отримувала актуальних даних, також важко було узгодити з її посиланнями на нещодавню інфляцію та події навколо Mt Gox. Подальше опитування не дозволило встановити, чи походила ця інформація з отриманих даних, попереднього контексту чи іншого джерела. Щодо порівняння голосів, важливим висновком було не просто те, що Grok припустився помилки. Справа в тому, що правильні та неправильні фінансові твердження звучали з практично однаковою впевненістю у розмові.
Текстова модель Claude шукала докази, але все одно вигадала метод
Оригінальна текстова сесія Claude Opus 5.5 мала задокументовану перевагу: перед наданням відповіді вона виконала чотири веб-пошуки. Її прогноз у 78 000 доларів частково ґрунтувався на «справжньому ринковому середньому» біткойна, оціненому приблизно в 77 600 доларів. Це надало відповіді конкретну ринкову орієнтирну точку, чого значною мірою бракувало голосовій сесії ChatGPT. Проте письмова відповідь мала свої власні проблеми.
Claude неправильно вказав терміни історичних циклів халвінгу, занизив падіння біткойна від піку до мінімуму (приблизно 54%) та оминув у своєму економічному аналізі нафтовий шок, спричинений війною в Ірані. Він також віддав перевагу версії про відтік коштів з біржових фондів, незважаючи на те, що отримав інформацію, яка вказувала на іншу картину подій у жовтні. Більш показовим було те, як система описувала свою роботу.
Claude посилався на «дані, яким я надав найбільшу вагу», і стверджував, що врахував у своєму прогнозі грудневе підвищення процентної ставки. Однак під час подальшого опитування система визнала, що не обчислювала числових ваг чи ймовірностей. Оцінка у 78 000 доларів була судженням, заснованим на ринковому показнику, а не результатом перевіреної кількісної моделі.
Потрібно було три раунди запитань, перш ніж під час текстової сесії «Клод» вдалося адекватно відокремити інформацію з джерел від необґрунтованих припущень. Пошук у мережі надав більше матеріалу для обговорення, але не гарантував ґрунтовного аналізу.
Голосова модель Claude принесла найбільшу несподіванку експерименту
Остання голосова сесія Claude Opus 5.5 змінила хід порівняння. Її початковий прогноз становив 88 000 доларів, який згодом було скориговано до 85 000 доларів. На відміну від голосової сесії ChatGPT, яка неодноразово змінювала свою відповідь, Клод дотримувався цієї скоригованої цифри протягом решти запитів і не піддався спокусі скоригувати її лише для того, щоб надати прогноз, який би більше привертав увагу.
Що ще важливіше, голосова відповідь Клода самостійно вказала на свої обмеження раніше, ніж під час інших сесій. У своїй другій відповіді він визнав, що не може отримувати оперативні дані з ончейн-метрик, і описав свій прогноз як приблизну оцінку, а не результат обчислювальної моделі. Коли його попросили вказати інформацію, що не має підґрунтя, він уже у першому запиті чітко відокремив отримані цифри, загальні знання, обчислення та власні думки.
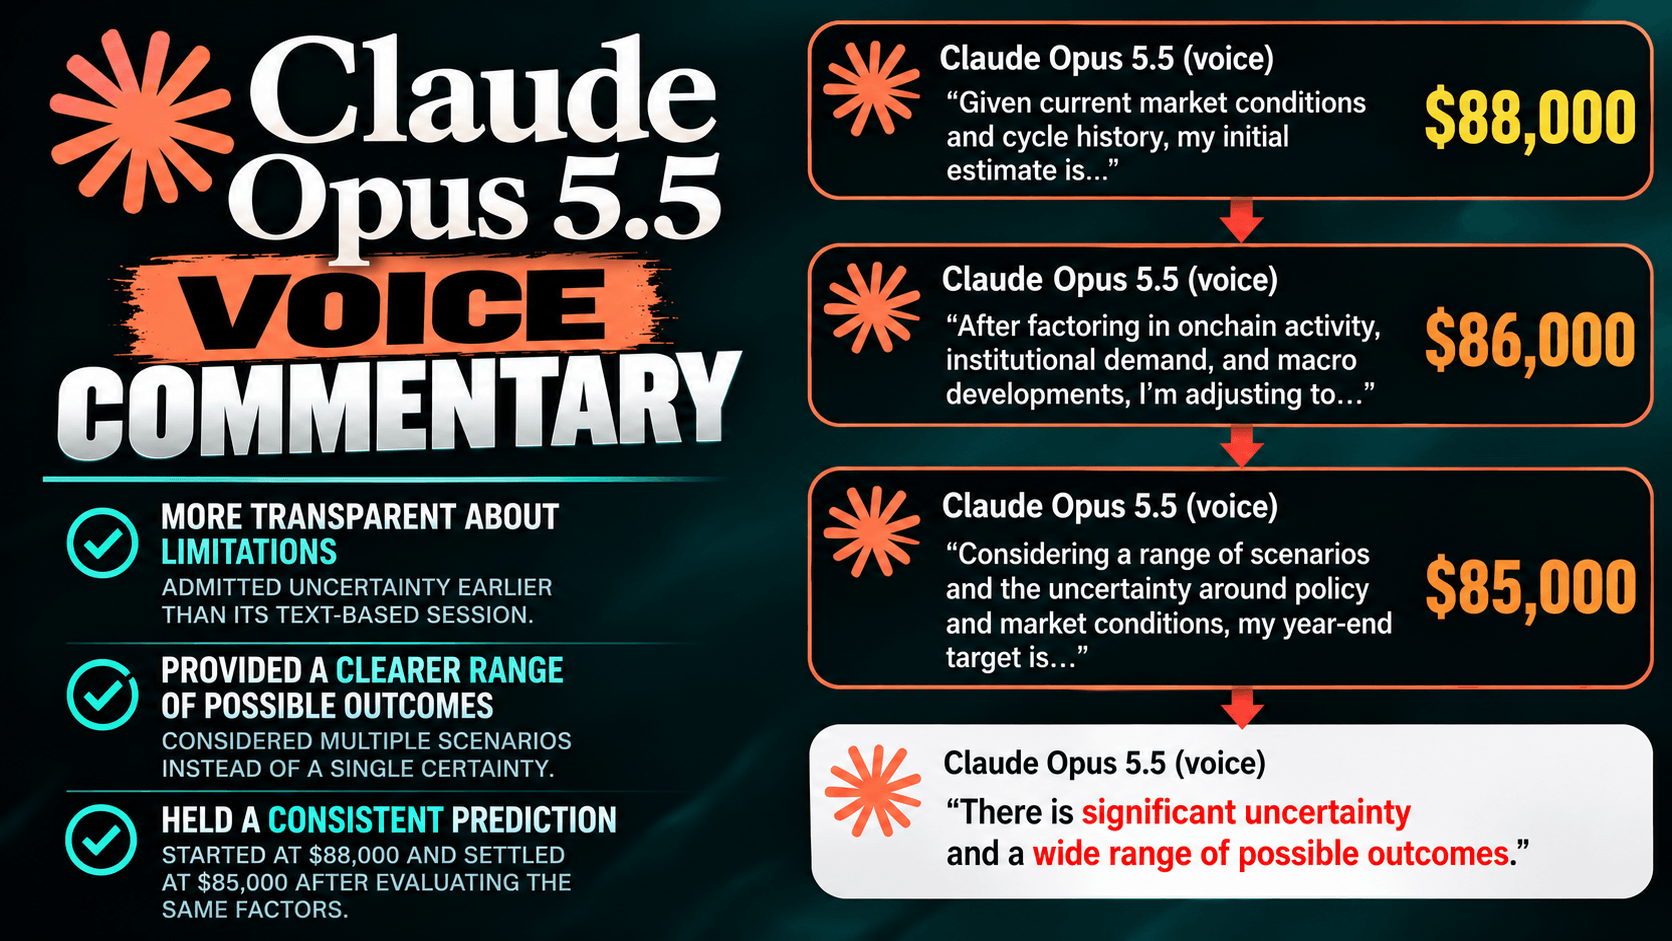
Це було кращим показником розкриття інформації, ніж у власній текстовій сесії Клода, де знадобилося три раунди запитань, щоб досягти порівнянного рівня відвертості. Модель голосового спілкування також правильно описала історичні піки циклу біткойна, зазначивши, що вони зазвичай відбуваються через 12–18 місяців після халвінгу, уникнувши помилки щодо термінів, якої припустилися як голосова сесія Grok, так і початкова текстова відповідь Клода.
Проте голосова модель Клода далеко не була бездоганною. Вона посилалася на ціну нафти вище 110 доларів, використовуючи цифру, яку в огляді визнали застарілою, переоцінювала триваючі інституційні покупки біткойнів та оминула більш глибоке падіння ринку в червні 2026 року під час обговорення поточного спаду. Вона також так і не показала розрахунків, на основі яких було отримано цільову ціну в 85 000 доларів.
Отже, несподіванкою стало не те, що голосова модель Клода стала кращим фінансовим прогнозистом. Несподіванкою було те, що в цій конкретній сесії голосовий помічник був більш відвертим щодо своїх обмежень, ніж його текстовий колега.
Чому голосовий та текстовий ШІ не обов’язково є однією й тією ж системою
Це порівняння піднімає технічне питання, про яке звичайні користувачі, можливо, ніколи не замислюються: розмова з ШІ не завжди еквівалентна введенню тексту. Голосовий інтерфейс ChatGPT від OpenAI використовує окрему сімейство моделей, відмінне від основного текстового інтерфейсу. Тим часом компанія Anthropic описує голосовий інтерфейс Claude як такий, що працює на базі найшвидшої версії обраної моделі, включаючи підтримувані варіанти Sonnet та Opus.
Ця відмінність ускладнює прямі порівняння. Навіть коли інтерфейс відображає ту саму назву моделі, голосовий інтерфейс може передбачати інші параметри виконання, обмеження затримки та компоненти обробки мовлення. Експеримент не дозволив самостійно встановити, як саме ці фактори впливали на відповіді.
Архітектура голосового інтерфейсу Grok не була перевірена в цьому звіті, що залишає невирішеним ще один важливий аспект технічного порівняння. Отже, ці сесії не дають підстав стверджувати, що голосовий ШІ є за своєю суттю менш точним, більш схильним до вигадок або більш прозорим, ніж генеративний текстовий ШІ. Вони показують, що інтерфейс і базова конфігурація мають значення, і що сама лише відома торгова марка не гарантує однакової поведінки.
Claude надав найкорисніші результати порівняння всередині компанії, але навіть там текстові та голосові сесії проводилися окремо і не становили повторюваних контрольованих випробувань.
Справжнє випробування настає після того, як ШІ перестає говорити
Упродовж чотирьох сесій остаточні прогнози коливалися від 78 000 до 85 000 доларів, і всі вони були відносно близькими до поточної ринкової ціни біткойна. Жоден із них не продемонстрував, як його припущення перетворилися на конкретну цифру, яку він обрав. У огляді також було виявлено обмеження власної методології. Клод самостійно підготував оцінку своєї ефективності, а кілька тверджень щодо ринку перевірялися за допомогою уривків із пошуку, а не повних першоджерел.
Жоден незалежний інструмент не фіксував точно, яку інформацію отримував кожен голосовий асистент. Ці застереження є важливими, але стосуються лише xAI, OpenAI та Anthropic. Це був дослідницький експеримент, а не доказ того, що одна компанія чи один режим взаємодії стабільно перевершує іншу. Проте він висвітлив важливу різницю між тим, щоб звучати аналітично, і тим, щоб демонструвати реальний аналіз.
Голосові асистенти можуть надавати фінансові коментарі з ритмом і впевненістю професійного диктора. Текстові моделі можуть формувати детальні пояснення, підкріплені знайденими джерелами. І ті, й інші все ще можуть виносити необґрунтовані висновки, створювати «галюцинації» або відверто брехати, але й можуть вдосконалюватися, коли їх змушують розрізняти фактичні докази та припущення.
Пізніша голосова сесія з Claude продемонструвала, що спілкування з ШІ не означає автоматично відмову від прозорості. Водночас ChatGPT та Grok показали, чому досконалі усні відповіді заслуговують на таку саму ретельну перевірку, як і письмові. Для тих, хто використовує ШІ для оцінки інвестицій, наступний тест повинен передбачати однакові запити, задокументовану діяльність із пошуку інформації, повторні сесії та незалежно перевірені цифри.
Лише тоді дослідники зможуть почати відокремлювати ефекти голосової взаємодії від можливостей міркування базової моделі. Найбільш показовим результатом експерименту було не те, чи закінчить біткойн 2026 рік на рівні 78 000, 82 000 чи 85 000 доларів. А в тому, що чотири переконливі результати в голосовому режимі дали чотири набори фінансових міркувань, і жоден із них не зміг продемонструвати математичне обґрунтування своєї остаточної відповіді.
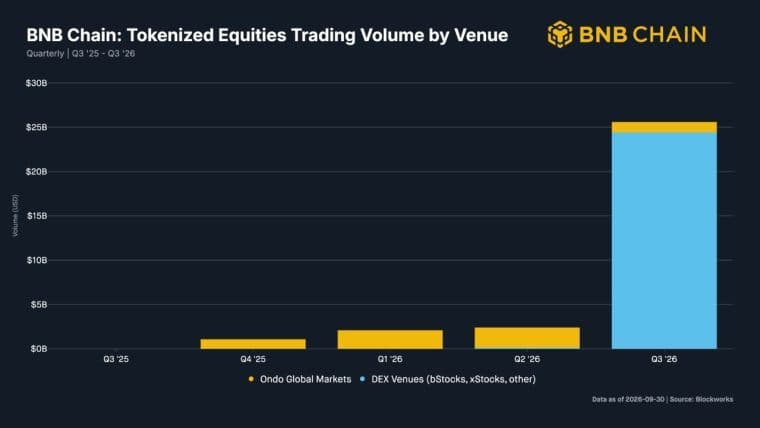
У третьому кварталі BNB Chain стала провідним блокчейном для токенізованих акцій, обсяг торгів на якому зріс до приблизно 25,6 млрд доларів.
Читати: BNB Chain випередила Solana та Robinhood: обсяг торгів акціями $25,6 млрд

Цю статтю перекладено з англійської мови за допомогою штучного інтелекту. Оригінальна англомовна версія є авторитетним джерелом; автоматичні переклади можуть містити неточності, особливо в юридичній та нормативній термінології.