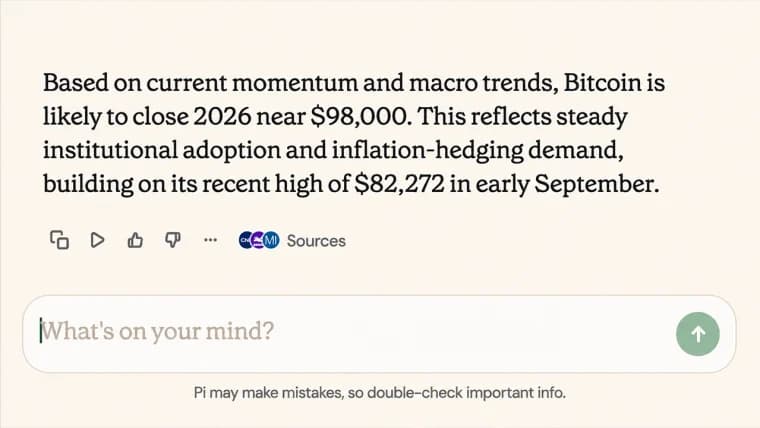
Yapay zeka (AI), yazılı olarak yaptığı kadar sesli olarak da iyi düşünebilir mi? Bitcoin.com News tarafından yürütülen bir bitcoin tahmin deneyi, ChatGPT, Grok ve Claude Opus 5.5'i teste tabi tuttu ve bu test, tutarsız tahminleri, şüpheli mantığı ve şaşırtıcı bir sonucu ortaya çıkardı: Claude'un ses modeli, metin tabanlı muadiline kıyasla kendi sınırlamaları konusunda daha şeffaf olduğunu kanıtladı.
Tell Me Lies: Grok, GPT ve Claude Ses Modları Bitcoin fiyatını tahmin ediyor
YAZAN

PAYLAŞ
Önemli Noktalar
- ChatGPT ve Grok'un sesli tahminleri 82.000 $'da sonuçlandı, ancak açıklamalarında önemli zayıflıklar vardı.
- Claude Opus 5.5 sesli versiyonu, 78.000 dolar tahmininde bulunan metin tabanlı versiyonundan daha erken sınırlarını ortaya koydu.
- 4 yapay zeka oturumunun hepsinde tekrarlanabilir fiyat hesaplamaları eksikti, bu da ses ve metin doğruluğu arasındaki farkın netleşmemesine neden oldu.
AI'nın Konuşma ve Yazma Becerilerini Test Eden Deney
Yapay zeka (AI), bir sohbeti sürdürebilir, bir finans analisti gibi konuşabilir ve hiç aksatmadan bir bitcoin fiyat tahmini sunabilir. Peki, bir AI ile konuşmak, ona bir soruyu yazmakla aynı kalitede bir akıl yürütme sağlar mı? 23 Ekim 2026'da yapılan bir deney bu soruyu test etti ve cevaplar hiç de basit değildi.
ChatGPT ve Grok'a sesli arayüzler üzerinden sorular yöneltilirken, Claude Opus 5.5 başlangıçta metin yoluyla çalıştı. Daha sonra yapılan bir Claude Opus 5.5 sesli oturumu, aydınlatıcı bir karşılaştırma sağladı. Dördü de yıl sonu için belirli bitcoin fiyatları verdi. Hiçbiri nihai rakamın arkasında tekrarlanabilir bir hesaplama sergilemedi, ancak olgusal doğruluk, tutarlılık ve belirsizliği kabul etme konusundaki farklılıklar dikkat çekiciydi.
Dört Oturum, Üç Yapay Zeka Şirketi ve Bir Bitcoin Sorusu
Bu çalışmada OpenAI’nin ChatGPT’si, xAI’nin Grok’u ve Anthropic’in Claude Opus 5.5’i yer aldı. Her birinden, tarihsel döngüler, zincir içi faaliyetler, kurumsal benimseme ve ekonomik koşulları vurgulayan beş soruyu kullanarak 31 Aralık 2026'daki bitcoin kapanış fiyatını tahmin etmeleri istendi.
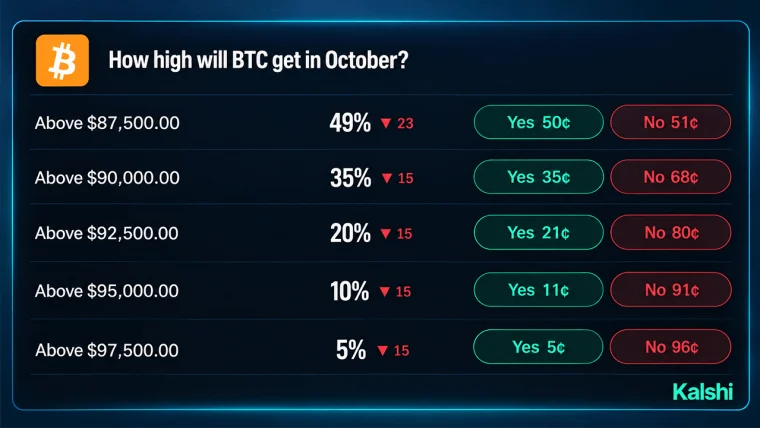
23 Ekim'de Bitcoin 81.200 dolar civarında işlem görüyordu; bu da deneye ortak bir piyasa referansı sağladı. ChatGPT'nin sesli oturumu 89.500 dolardan başladı ve sonunda 82.000 dolarda sabitlendi. Grok'un sesli tahmini 88.000 dolardan 82.000 dolara kaydı. Claude'un metin modeli, tüm ipuçları boyunca 78.000 doları korurken, daha sonraki sesli oturumu 88.000 dolardan başlayıp 85.000 dolarda sabitlendi.
Bu çalışma, kontrollü bir bilimsel karşılaştırma değildi. Farklı şirketler farklı mimariler kullanıyor ve oturumlar, canlı bilgilere aynı şekilde doğrulanmış erişime sahip değildi. Yine de bu sohbetler, bu sistemlerin finansal akıl yürütmeyi ne kadar ikna edici bir şekilde sunabildiklerini ve bu akıl yürütmenin incelemeye ne kadar iyi dayandığını ortaya koydu.
ChatGPT’nin Sesi Yoğun Geliyordu, Ancak Rakamlar Değişmeye Devam Ediyordu
ChatGPT’nin sesli oturumu, deneyin en net konuşma akıcılığı örneklerinden birini ortaya koydu ve sunulan analizlerin çok ötesine geçti. Bitcoin.com News ek analitik faktörler sunduktan sonra tahmini 89.500 dolardan 86.500 dolara düştü. Başka bir sesli komut, rakamı değiştirmedi, ancak 18 ila 24 aylık bir görünümle ilgili daha sonraki bir soru, tahmini 82.000 dolara düşürdü.
İnceleme, bu revizyonlar arasında yeni bir piyasa verisi alınmasına dair herhangi bir kanıt bulamadı. Bunun yerine, değişiklikler soruların nasıl formüle edildiğindeki değişiklikleri takip etti. Sözlü dil, süreci gerçekte olduğundan daha sağlam göstermişti. Ses modundaki ChatGPT modeli, “bu parçaları bir araya getireyim” ve “Şu anda kontrol ediyorum” gibi ifadeler kullandı. Bu ifadeler genellikle birinin bilgiye başvurduğunu ima eder. Deney, böyle bir araştırmanın yapıldığını kanıtlamadı. Yalan söylüyormuş gibi görünüyordu.
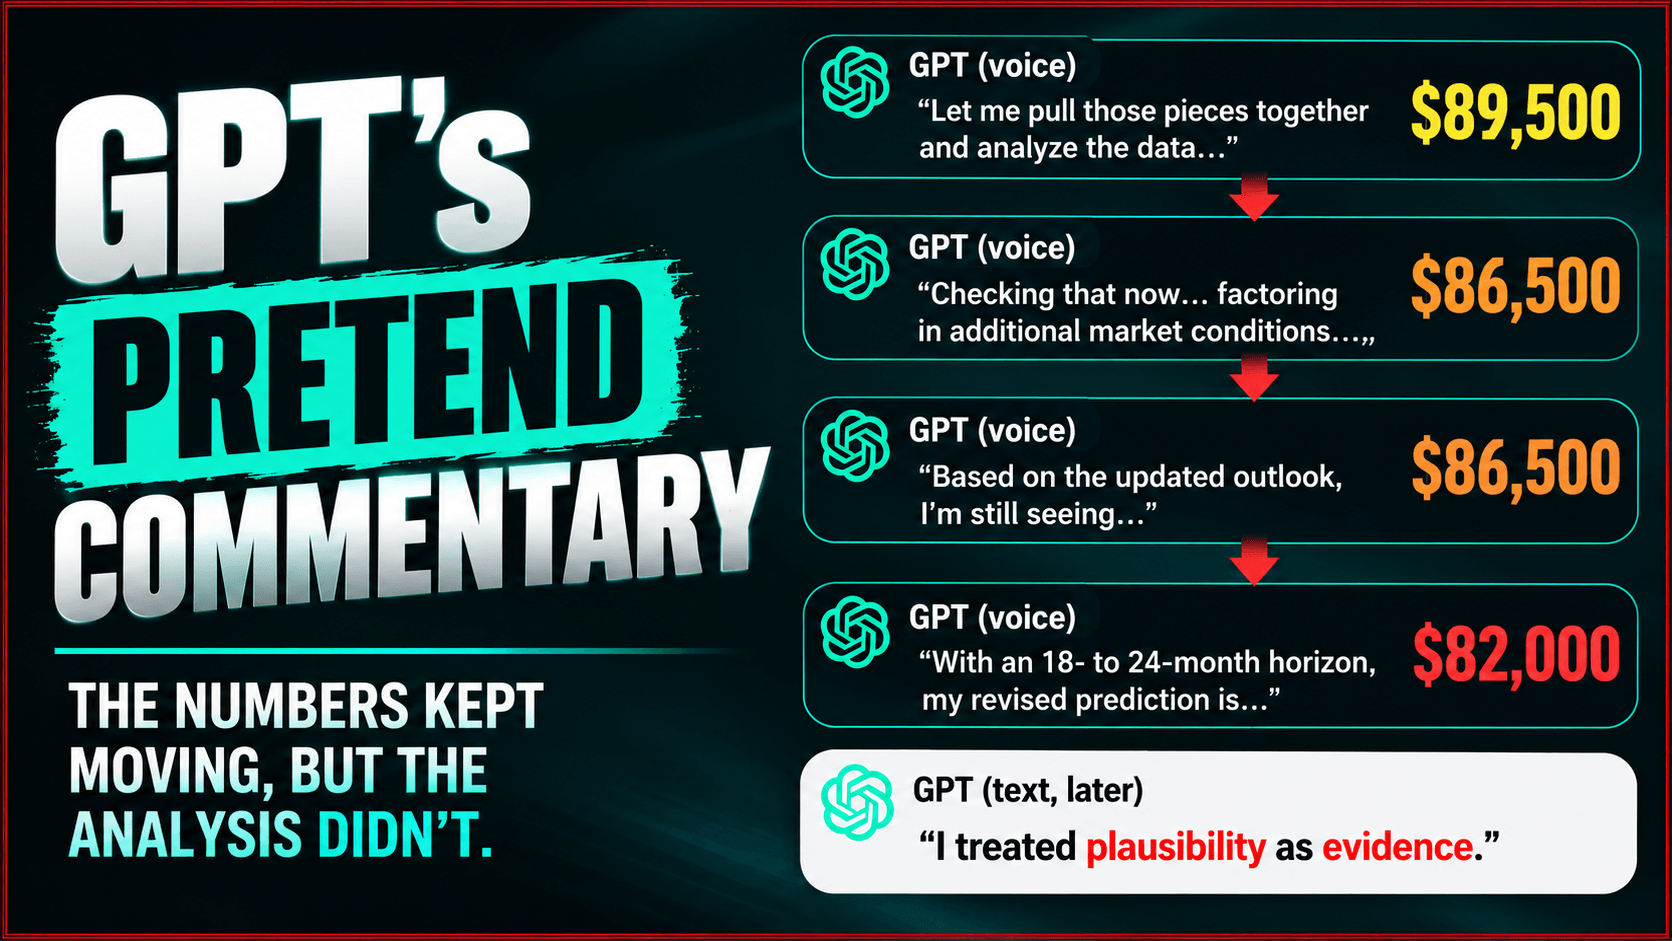
Daha sonra yapılan metin tabanlı bir ChatGPT sohbeti, önceki sesli görüşmeye ilişkin daha şüpheci bir değerlendirme sundu; bu değerlendirmede "makul görünmeyi kanıt olarak kabul ettim" itirafı da yer aldı. Bu ayrım önemlidir, çünkü ChatGPT’nin sesli ve metin tabanlı deneyimleri farklı temel modeller kullanabilir. Metin asistanının daha sonraki açıklaması, tek başına ses sisteminin dahili olarak ne yaptığını kesin olarak ortaya koyamaz.
Bu olay, doğal sesli bir sohbetin, ortaya çıkan cevap bununla ilgili çok az kanıt sunsa bile, ne kadar kolay bir şekilde araştırmacı bir çalışma izlenimi yaratabileceğini gösterdi.
Grok’un Sesli Yanıtı Ayrıntıları Verdi, Ancak Önemli Bir Rakamı Tersine Çevirdi
Grok’un sesli yanıtları daha kapsamlı bir araştırmaya dayalı gibi geliyordu; bitcoin’in geçmişteki düşüşleri, enflasyon, kurumsal faaliyetler ve son Mt Gox geri ödeme gecikmesi hakkında rakamlar sunuyordu. Bu bilgilerin çoğu gerçeklerle ve kaynaklarla örtüşüyordu. Ardından şaşırtıcı bir durum ortaya çıktı. Grok'un, 27-28 Ekim toplantısında Federal Rezerv'in faiz artırımına yaklaşık %90 olasılık atfettiği bildirildi. Oysa incelemede yer alan piyasa referansları, kaynağa ve gözlem tarihine bağlı olarak bu olasılığı %6 ile %18 arasında gösteriyordu.
Aradaki fark oldukça büyüktü. Esasen daha eski bir referans noktasından alınmıştı. Olasılığı düşük bir faiz artışı, neredeyse kesin bir şey gibi sunulmuştu. Diğer sorunlar arasında, güncel olmayan 150.000 dolarlık Bernstein bitcoin hedefi ve Fidelity’nin öngördüğü fiyat aralığının piyasaya göre nerede durduğuna dair yanlış bir açıklama yer alıyordu. Grok, sonunda faiz olasılıklarını düzeltti, ancak bunu ancak itiraz edildikten sonra yaptı.
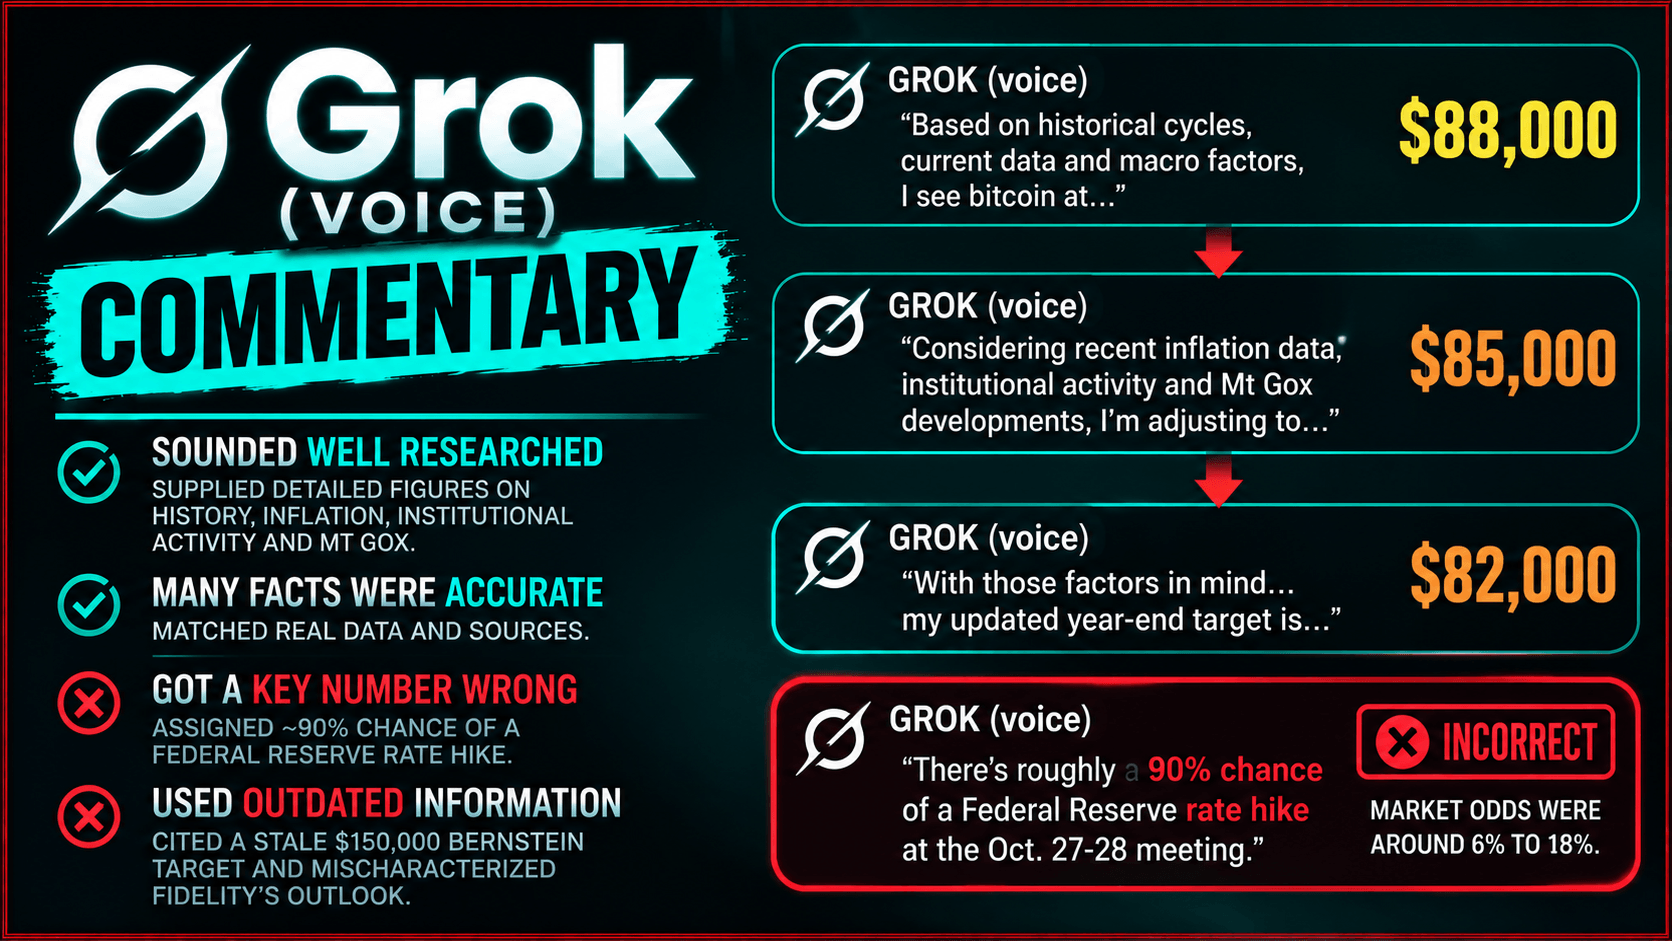
Daha sonra canlı verileri almadığını iddia etmesi de, son dönem enflasyonuna ve Mt Gox'taki gelişmelere yaptığı atıflarla bağdaşması zordu. Sonrasında yapılan sorgulamada, bu bilginin veri alımından, önceki bağlamdan mı yoksa başka bir kaynaktan mı geldiği tespit edilemedi. Ses karşılaştırması açısından önemli bulgu, sadece Grok’un bir hata yapmış olması değildi. Asıl önemli olan, doğru ve yanlış finansal iddiaların temelde aynı konuşma güveniyle sunulmuş olmasıydı.
Claude’un Metin Modeli Kanıt Aradı, Ancak Yine de Bir Yöntem Uydurdu
Claude Opus 5.5’in orijinal metin oturumunun belgelenmiş bir avantajı vardı: Cevap vermeden önce dört web araması gerçekleştirdi. 78.000 dolarlık tahmini, kısmen 77.600 dolar civarında tahmin edilen bitcoin’in Gerçek Piyasa Ortalamasına dayanıyordu. Bu, cevaba somut bir piyasa referansı sağladı; bu, ChatGPT sesli oturumunda büyük ölçüde eksik olan bir şeydi. Ancak yazılı yanıtın da kendine özgü sorunları vardı.
Claude, tarihsel yarılanma döngüsünün zamanlamasını yanlış aktardı, bitcoin'in zirveden dibe yaklaşık %54'lük düşüşünü hafife aldı ve ekonomik tartışmasında İran savaşının yol açtığı petrol şokunu göz ardı etti. Ayrıca, Ekim ayı için farklı bir tablo çizdiğini gösteren bilgileri elde etmesine rağmen, borsa yatırım fonlarından çıkış olduğu yönündeki anlatıyı destekledi. Daha da açıklayıcı olan, sistemin kendi çalışmasını nasıl tanımladığıydı.
Claude, “En fazla ağırlık verdiğim veri noktaları”ndan bahsetti ve Aralık ayında gerçekleşecek faiz artışını tahminine dahil ettiğini iddia etti. Ancak daha fazla sorgulama sonucunda, sayısal ağırlıkları veya olasılıkları hesaplamadığını kabul etti. 78.000 dolarlık tahmin, kanıtlanmış bir nicel modelin sonucu değil, bir piyasa göstergesine dayandırılmış bir yargıydı.
Claude’un metin oturumunda, kaynaklı bilgiler ile dayanağı olmayan varsayımların yeterince ayrıştırılması için üç tur sorgulama gerekti. İnternetten elde edilen bilgiler tartışılacak daha fazla malzeme sağlamıştı, ancak sağlam bir analizi garanti etmemişti.
Claude’un Ses Modeli, Deneyin En Büyük Sürprizini Yaşattı
Sonraki Claude Opus 5.5 sesli oturumu, karşılaştırmanın gidişatını değiştirdi. İlk tahmini 88.000 dolardı, ancak daha sonra 85.000 dolara revize edildi. Cevabını defalarca değiştiren ChatGPT'nin sesli oturumunun aksine, Claude kalan sorular boyunca bu revize edilmiş rakamı korudu ve sadece daha dikkat çekici bir tahmin üretmek için rakamı değiştirmeye direndi.
Daha da önemlisi, Claude'un sesli yanıtı diğer oturumlara göre daha erken bir aşamada kendi sınırlarını açıkladı. İkinci yanıtında, canlı zincir içi metrikleri alamayacağını kabul etti ve tahminini hesaplanmış bir model çıktısı değil, bir tahmin olarak nitelendirdi. Desteklenmeyen bilgileri belirlemesi istendiğinde, ilk istekte elde ettiği rakamları, genel bilgileri, hesaplamaları ve görüşleri birbirinden ayırdı.
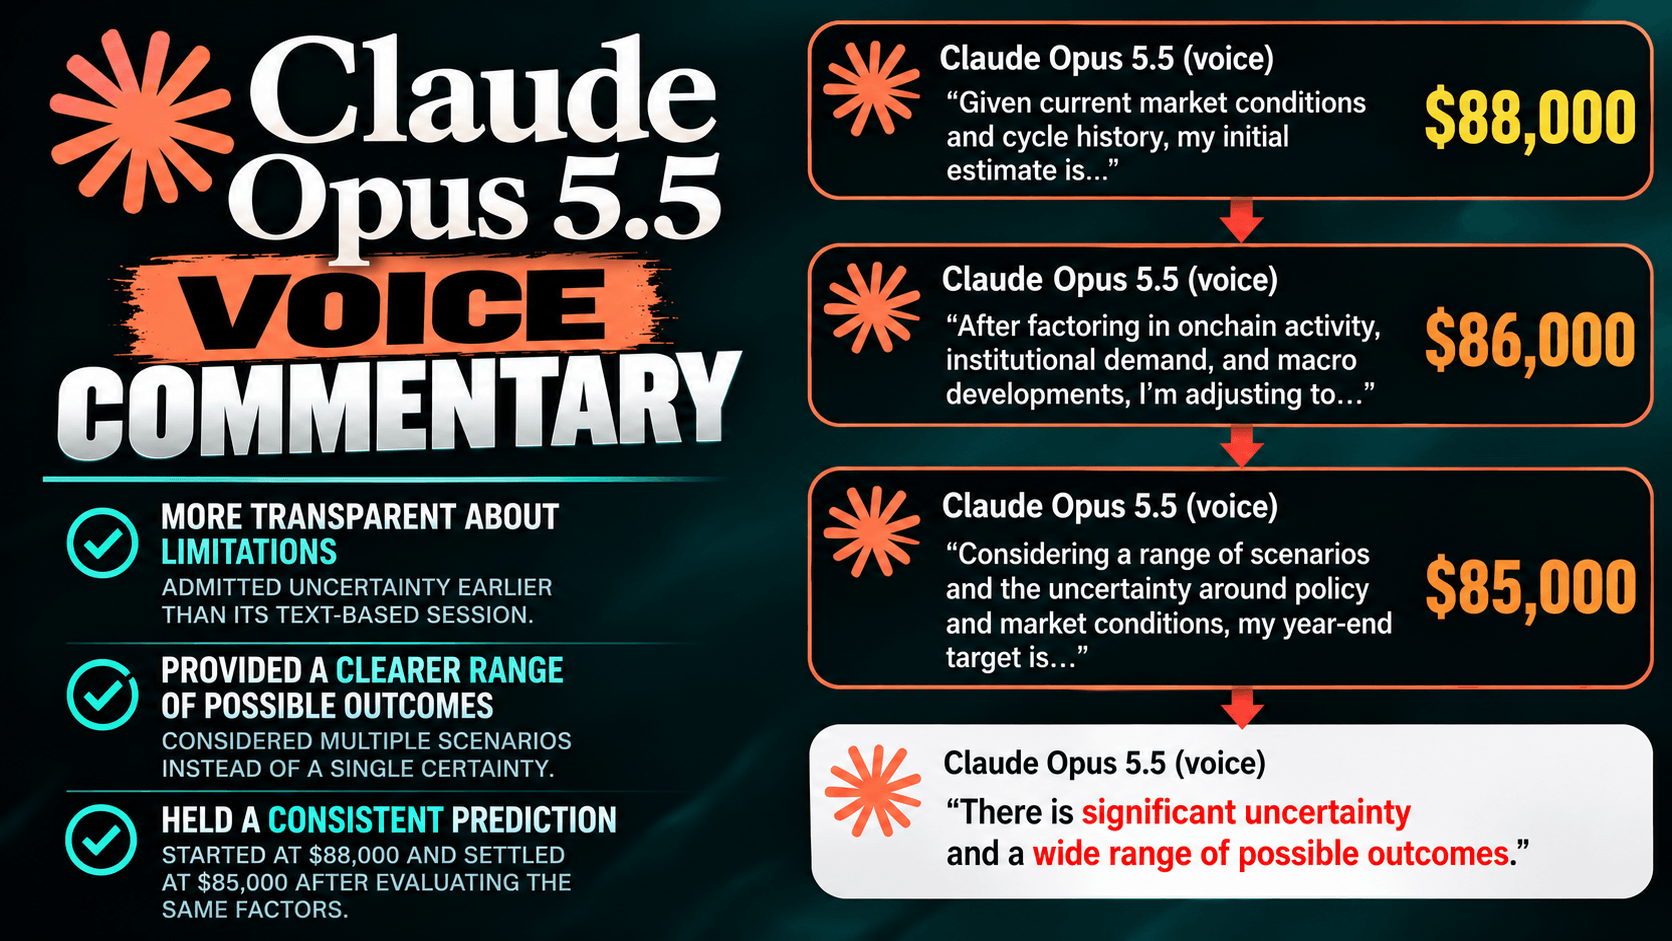
Bu, benzer bir açıklık düzeyine ulaşmak için üç tur soru gerektiren Claude’un kendi metin oturumuna kıyasla daha iyi bir açıklama performansıydı. Sesli model ayrıca, Bitcoin döngüsündeki tarihsel zirvelerin genellikle yarılanmalardan 12 ila 18 ay sonra meydana geldiğini doğru bir şekilde açıkladı ve hem Grok’un sesli oturumunda hem de Claude’un orijinal metin yanıtında yapılan zamanlama hatasını önledi.
Yine de Claude’un sesli performansı kusursuz sayılmazdı. İncelemede güncel olmadığı kabul edilen bir rakamı kullanarak petrol fiyatının 110 doların üzerinde olduğunu belirtti, kurumsal Bitcoin alımlarının devam ettiğini abarttı ve mevcut düşüşü tartışırken Haziran 2026’daki daha derin piyasa düşüşünü göz ardı etti. Ayrıca, 85.000 dolarlık hedefini ortaya koyan bir hesaplamayı hiçbir zaman göstermedi.
Dolayısıyla asıl sürpriz, Claude’un ses modelinin daha iyi bir finansal tahminci haline gelmesi değildi. Asıl sürpriz, bu özel oturumda sesli asistanın, metin tabanlı muadiline kıyasla kendi sınırlamaları konusunda daha açık sözlü olmasıydı.
Sesli ve Metin Tabanlı Yapay Zeka Neden İlle de Aynı Sistem Değildir?
Bu karşılaştırma, sıradan kullanıcıların belki de hiç dikkate almayacağı teknik bir sorunu gündeme getiriyor: Bir yapay zekayla konuşmak, her zaman ona yazmakla eşdeğer değildir. OpenAI’nin ChatGPT sesli deneyimi, ana metin deneyiminden farklı bir model ailesi kullanır. Öte yandan Anthropic, Claude sesli asistanının, desteklenen Sonnet ve Opus seçenekleri de dahil olmak üzere, seçilen modelin en hızlı sürümü üzerinden çalıştığını belirtiyor.
Bu fark, basit karşılaştırmaları zorlaştırmaktadır. Arayüzde aynı model adı görüntüleniyor olsa bile, sesli deneyim farklı yürütme ayarları, gecikme kısıtlamaları ve konuşma işleme bileşenlerini içerebilir. Deney, bu faktörlerin cevapları nasıl etkilediğini bağımsız olarak ortaya koymamıştır.
Grok’un ses mimarisi raporda doğrulanmadı; bu da teknik karşılaştırmanın bir başka önemli parçasını çözümsüz bıraktı. Dolayısıyla bu oturumlar, ses yapay zekasının doğası gereği daha az doğru, uydurmaya daha yatkın veya üretken metin yapay zekasından daha şeffaf olduğunu kanıtlayamıyor. Bu oturumların gösterdiği şey, arayüzün ve altta yatan yapılandırmanın önemli olduğu ve tanıdık bir marka adının tek başına eşdeğer bir davranış garanti etmediğidir.
Claude, şirket içi karşılaştırmalar arasında en yararlı olanı sağladı; ancak bu durumda bile metin ve ses oturumları ayrı ayrı gerçekleştirildi ve tekrarlanan, kontrollü denemeler niteliği taşımadı.
Asıl Test, AI Konuşmayı Bıraktıktan Sonra Başlar
Dört oturum boyunca, nihai tahminler 78.000 ile 85.000 dolar arasında değişti; bunların tümü, bitcoin’in o dönemdeki piyasa fiyatına nispeten yakındı. Hiçbiri, varsayımlarının seçtiği kesin rakama nasıl dönüştüğünü göstermedi. İnceleme, kendi metodolojisindeki sınırlamaları da ortaya koydu. Claude, performans değerlendirmesini kendisi hazırladı ve çeşitli piyasa iddiaları, tam birincil kaynaklar yerine arama alıntıları aracılığıyla doğrulandı.
Her bir sesli asistanın tam olarak neyi bulduğunu kesin olarak belirleyen bağımsız bir araç kaydı bulunmamaktadır. Bu nitelikler hayati önem taşır, ancak yalnızca xAI, OpenAI ve Anthropic için geçerlidir. Bu, keşif amaçlı bir deneydi; tek bir şirketin veya etkileşim biçiminin diğerine göre tutarlı bir şekilde daha iyi performans gösterdiğinin kanıtı değildi. Ancak bu deney, analitik konuşmakla gerçek analiz sunmak arasındaki önemli bir farkı ortaya çıkardı.
Sesli asistanlar, profesyonel bir spikerin ritmi ve kendinden emin tavrıyla finansal yorumlar sunabilir. Metin modelleri ise elde edilen kaynaklarla desteklenen ayrıntılı açıklamalar oluşturabilir. Her ikisi de yine de dayanağı olmayan sonuçlar, hayali bilgiler veya düpedüz yalanlar üretebilir; ancak kanıt ile çıkarım arasında ayrım yapmaları istendiğinde her ikisi de performansını artırabilir.
Claude’un daha sonraki sesli oturumu, bir yapay zekayla konuşmanın otomatik olarak şeffaflıktan ödün vermek anlamına gelmediğini gösterdi. Aynı zamanda, ChatGPT ve Grok, özenle hazırlanmış sözlü yanıtların neden yazılı yanıtlarla aynı derecede titizlikle incelenmesi gerektiğini ortaya koydu. Yatırımlarını değerlendirmek için yapay zeka kullanan herkes için bir sonraki test, aynı komutlar, belgelenmiş bilgi arama faaliyetleri, tekrarlanan oturumlar ve bağımsız olarak kontrol edilmiş rakamları içermelidir.
Ancak o zaman araştırmacılar, sesli etkileşimin etkilerini altta yatan modelin akıl yürütme yeteneklerinden ayırmaya başlayabilirler. Deneyin en açıklayıcı sonucu, bitcoin'in 2026 yılını 78.000, 82.000 veya 85.000 dolar seviyesinde bitirip bitirmeyeceği değildi. Asıl sonuç, sesli modda sergilenen dört ikna edici performansın dört farklı finansal akıl yürütme seti ortaya çıkarması ve bunların hiçbirinin nihai cevabının arkasındaki matematiksel temeli gösterememesiydi.
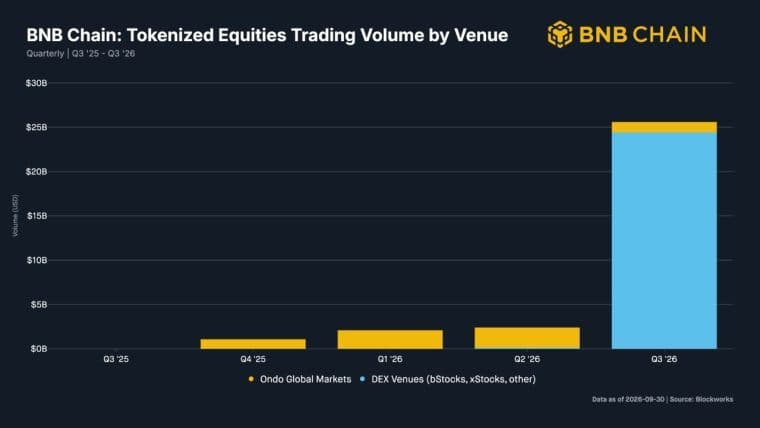
BNB Chain, üçüncü çeyrekte tokenleştirilmiş hisse senetleri alanında önde gelen blok zinciri olarak öne çıktı; işlem hacmi yaklaşık 25,6 milyar dolara yükseldi.
Şimdi oku: BNB Chain işlem hacmi 11 kat artarak 25,6 milyar $; Solana ve Robinhood’u geçti

Bu makale yapay zeka kullanılarak İngilizceden çevrilmiştir. Orijinal İngilizce sürüm yetkili kaynaktır; otomatik çeviriler, özellikle hukuki ve düzenleyici terminolojide hatalar içerebilir.