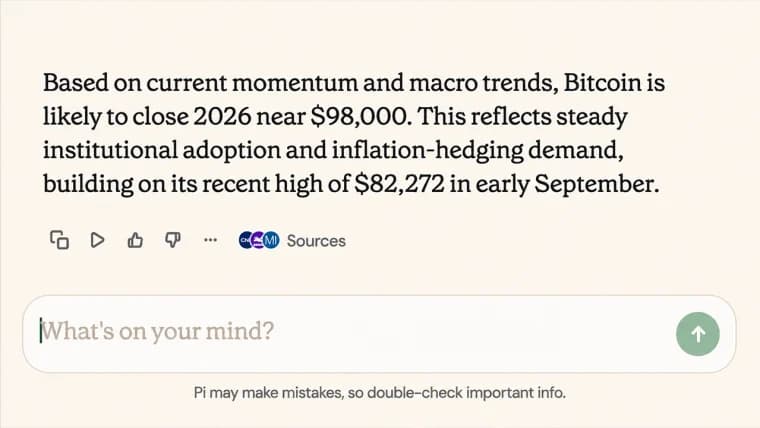
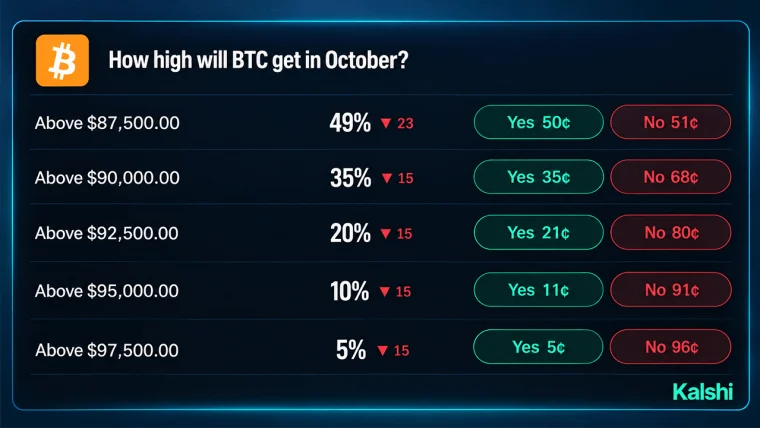
L'intelligence artificielle (IA) est-elle aussi capable de réfléchir à voix haute qu'à l'écrit ? Une expérience de prévision sur le bitcoin menée par Bitcoin.com News a mis à l'épreuve ChatGPT, Grok et Claude Opus 5.5, révélant des prévisions hasardeuses, un raisonnement discutable et un rebondissement surprenant : le modèle vocal de Claude s'est avéré plus transparent quant à ses limites que son homologue textuel.
« Tell Me Lies » : Grok, GPT et Claude estiment le cours du Bitcoin
ÉCRIT PAR

PARTAGER
Points clés
- Les versions vocales de ChatGPT et de Grok ont toutes deux abouti à un résultat de 82 000 $, mais leurs explications présentaient d’importantes faiblesses.
- La version vocale de Claude Opus 5.5 a révélé ses limites plus tôt que sa session textuelle, qui prévoyait un cours de 78 000 $.
- Les quatre sessions d’IA présentaient toutes un manque de calculs de prix reproductibles, laissant en suspens la question de la précision entre la version vocale et la version textuelle.
L’expérience qui a mis à l’épreuve les compétences de l’IA en matière de conversation et de saisie
L’intelligence artificielle (IA) est capable de mener une conversation, de parler comme un analyste financier et de fournir une prévision du cours du bitcoin sans le moindre temps de latence. Mais le fait de parler à une IA produit-il la même qualité de raisonnement que le fait de lui taper une question ? Une expérience menée le 23 octobre 2026 a mis cette question à l’épreuve, et les réponses étaient tout sauf simples. ChatGPT et Grok ont été interrogés via des interfaces vocales, tandis que Claude Opus 5.5 a d’abord fonctionné par texte. Une session vocale ultérieure avec Claude Opus 5.5 a permis une comparaison révélatrice. Les quatre ont fourni des cours précis du bitcoin en fin d’année. Aucun n’a démontré de calcul reproductible derrière son chiffre final, mais les différences en matière d’exactitude factuelle, de cohérence et de volonté d’admettre l’incertitude étaient frappantes.
Quatre sessions, trois entreprises d’IA et une question sur le bitcoin
L’exercice a impliqué ChatGPT d’OpenAI, Grok de xAI et Claude Opus 5.5 d’Anthropic. Chacun a été invité à prédire le cours de clôture du bitcoin au 31 décembre 2026, à partir de cinq consignes mettant l’accent sur les cycles historiques, l’activité sur la blockchain, l’adoption institutionnelle et les conditions économiques.
Le bitcoin se négociait à près de 81 200 dollars le 23 octobre, ce qui a fourni à l’expérience une référence commune du marché. La session vocale de ChatGPT a débuté à 89 500 dollars pour finalement s’établir à 82 000 dollars. L’estimation vocale de Grok est passée de 88 000 $ à 82 000 $. Le modèle textuel de Claude a maintenu une estimation à 78 000 $ tout au long de ses invites, tandis que sa session vocale ultérieure a débuté à 88 000 $ avant de se stabiliser à 85 000 $.
Cet exercice ne constituait pas un test de performance scientifique contrôlé. Les différentes entreprises utilisent des architectures différentes, et les sessions ne disposaient pas toutes d’un accès identique et vérifié à des informations en temps réel. Néanmoins, ces conversations ont offert un aperçu révélateur de la capacité de ces systèmes à présenter un raisonnement financier de manière convaincante, ainsi que de la résistance de ce raisonnement à un examen minutieux.
La voix de ChatGPT semblait occupée, mais les chiffres continuaient d’évoluer
La session vocale de ChatGPT a fourni l’un des exemples les plus évidents de fluidité conversationnelle de l’expérience, devançant largement l’analyse présentée. Sa prévision est passée de 89 500 $ à 86 500 $ après que Bitcoin.com News a introduit des facteurs analytiques supplémentaires. Une autre instruction vocale a laissé le chiffre inchangé, mais une question ultérieure concernant les perspectives sur 18 à 24 mois a ramené la prévision à 82 000 dollars. L’analyse n’a révélé aucune preuve d’une nouvelle consultation du marché entre ces révisions. Au contraire, les changements suivaient des modifications dans la formulation des questions. Le langage oral donnait l’impression que le processus était plus approfondi qu’il ne l’était en réalité. Le modèle de ChatGPT en mode vocal utilisait des expressions telles que « laissez-moi rassembler ces éléments » et « Je vérifie cela tout de suite ». Ces phrases suggèrent généralement que quelqu’un consulte des informations. L’expérience n’a pas permis d’établir qu’une telle recherche ait eu lieu. Il semblait mentir.
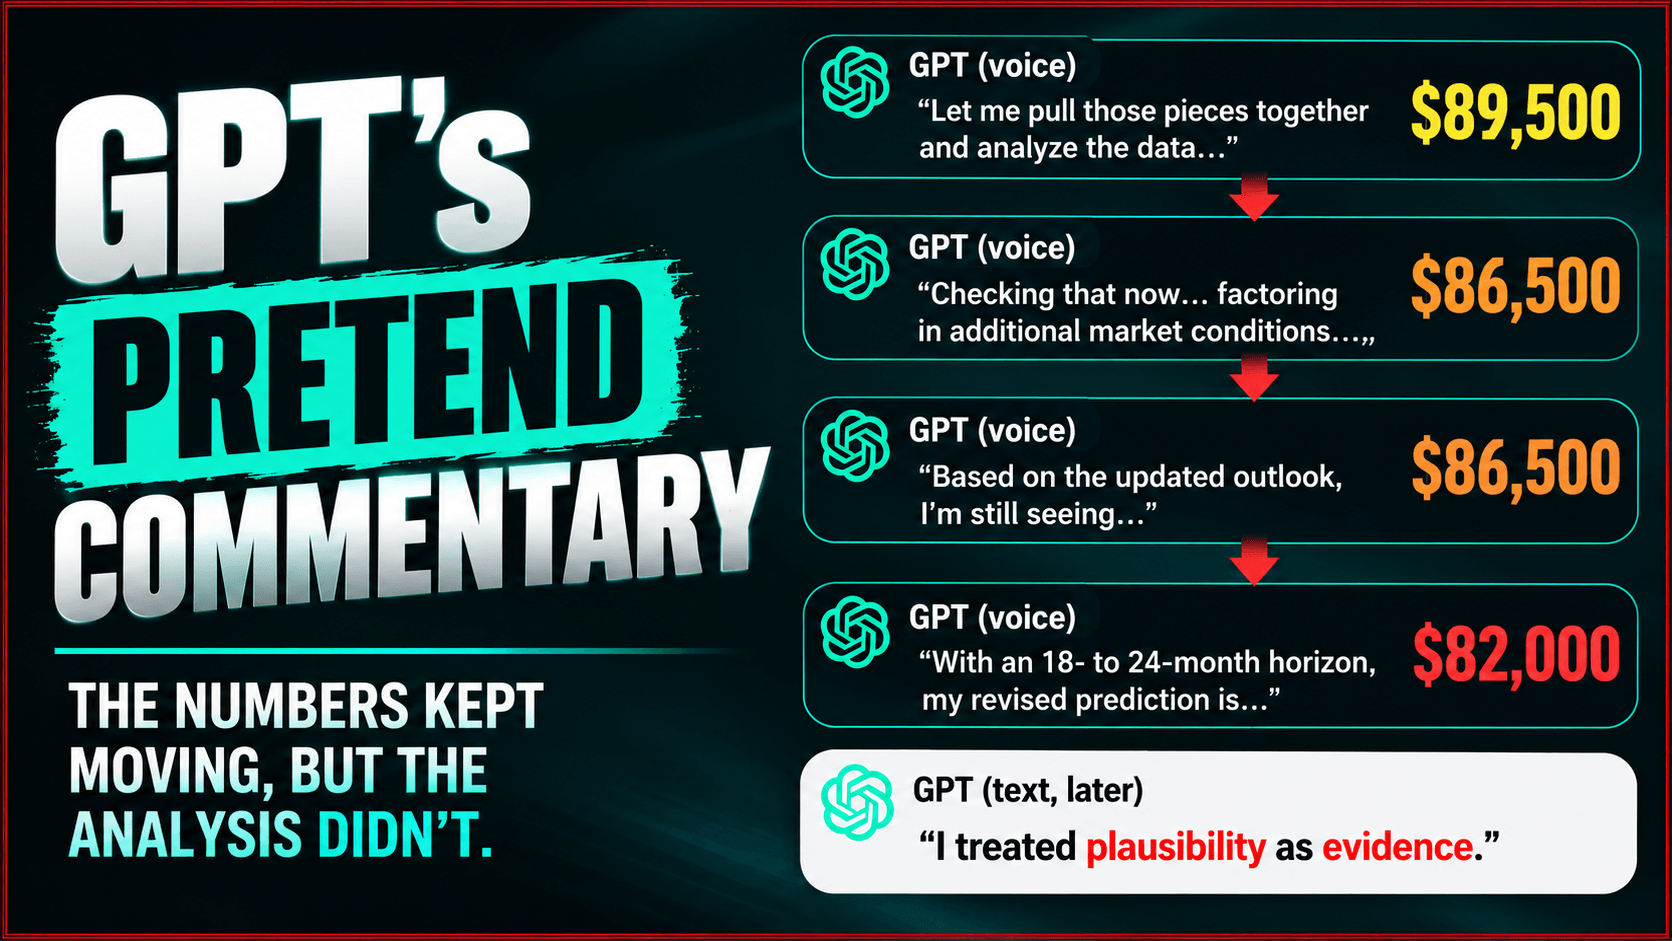 Une conversation textuelle ultérieure avec ChatGPT a donné lieu à une évaluation plus sceptique de l’échange vocal précédent, avec notamment l’aveu suivant : « J’ai considéré la plausibilité comme une preuve. » Cette distinction est importante car les expériences vocales et textuelles de ChatGPT peuvent s’appuyer sur des modèles sous-jacents différents. L’explication donnée ultérieurement par l’assistant textuel ne permet pas, à elle seule, de déterminer précisément ce que le système vocal a fait en interne. Cet épisode a montré à quel point une conversation au ton naturel peut facilement donner l’impression d’un travail d’investigation, même lorsque la réponse obtenue n’en apporte guère de preuves.
La voix de Grok a fourni des détails, mais a inversé un chiffre crucial
Les réponses orales de Grok semblaient avoir fait l’objet de recherches plus approfondies, fournissant des chiffres sur les baisses historiques du bitcoin, l’inflation, l’activité des investisseurs institutionnels et le récent retard de remboursement de Mt Gox. La plupart de ces informations correspondaient aux faits et aux sources. Puis vint une véritable perle. Grok aurait attribué une probabilité d’environ 90 % à une hausse des taux de la Réserve fédérale lors de la réunion des 27 et 28 octobre. Les références de marché de l’analyse situaient en revanche cette probabilité entre 6 % et 18 %, selon la source et la date d’observation. La différence était considérable. L’estimation s’appuyait essentiellement sur une référence obsolète. Une hausse des taux d’intérêt peu probable avait été présentée comme quasi certaine. Parmi les autres problèmes figuraient un objectif de cours du bitcoin de 150 000 dollars établi par Bernstein et désormais obsolète, ainsi qu’une description erronée de la position de la fourchette de prix prévue par Fidelity par rapport au marché. Grok a finalement corrigé ses probabilités de hausse des taux, mais seulement après avoir été contesté.
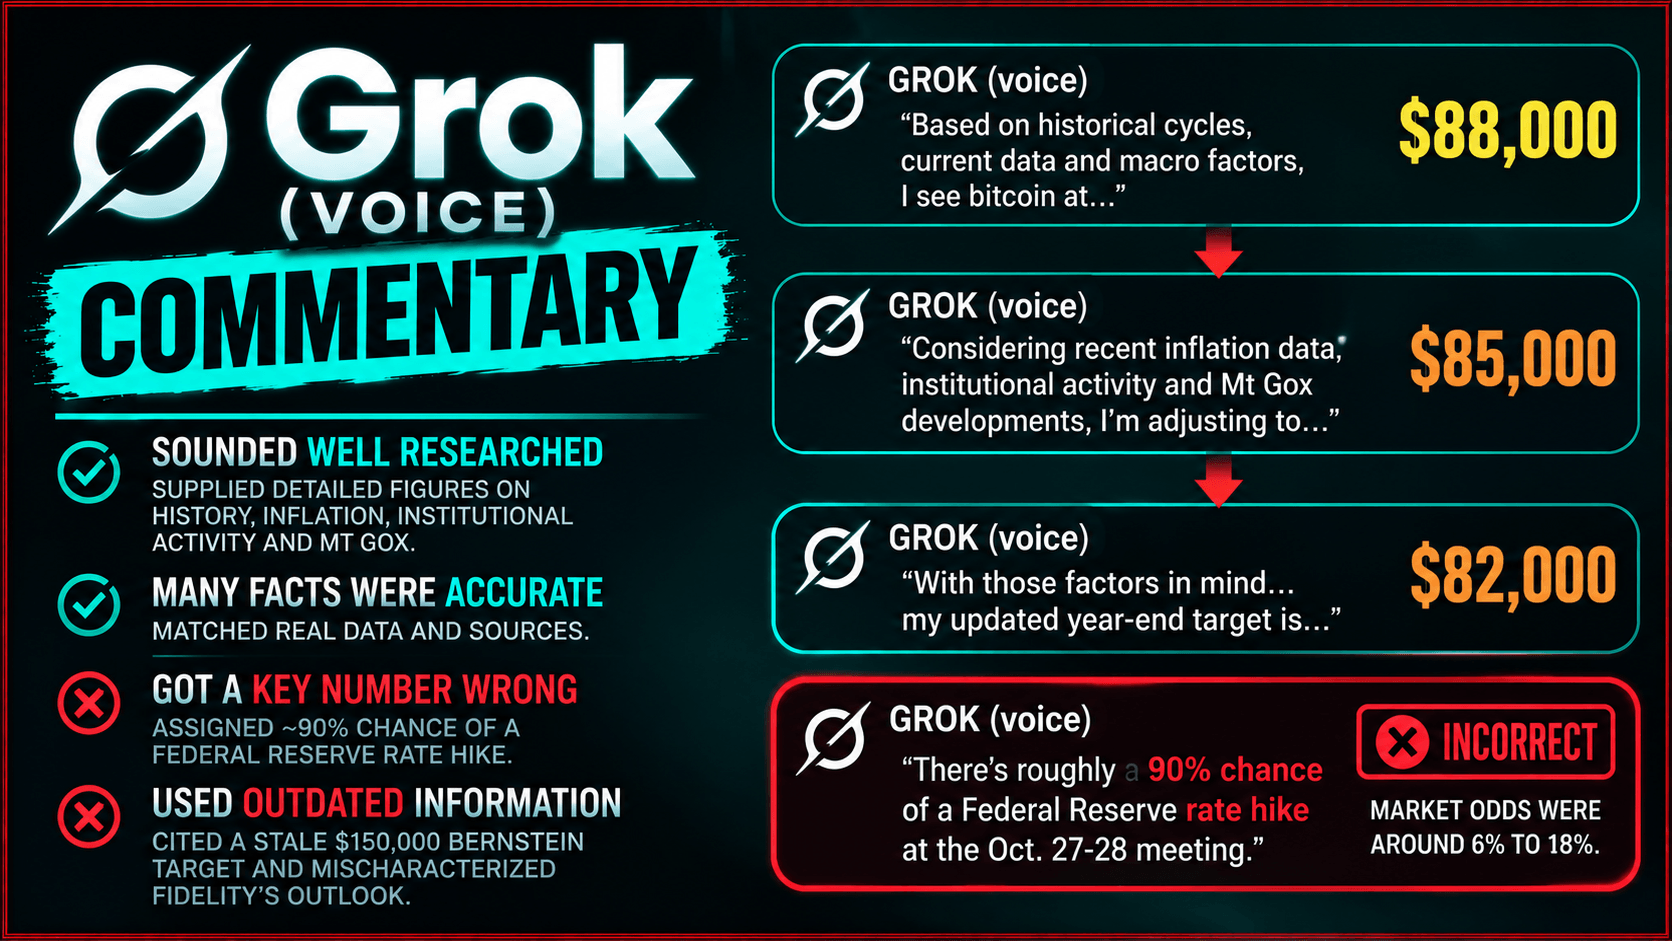 Son affirmation ultérieure selon laquelle il n’avait pas récupéré de données en temps réel était également difficile à concilier avec ses références à l’inflation récente et aux développements concernant Mt Gox. Les questions qui ont suivi n’ont pas permis d’établir si ces informations provenaient d’une récupération de données, du contexte antérieur ou d’une autre source. En ce qui concerne la comparaison vocale, le constat important n’était pas simplement que Grok avait commis une erreur. Il s’agissait du fait que les affirmations financières correctes et incorrectes étaient formulées avec pratiquement la même assurance conversationnelle.
Le modèle textuel de Claude a cherché des preuves, mais a tout de même inventé une méthode
La session textuelle originale de Claude Opus 5.5 présentait un avantage avéré : elle avait effectué quatre recherches sur Internet avant de répondre. Sa prévision de 78 000 dollars s’appuyait en partie sur la « True Market Mean » du bitcoin, estimée à près de 77 600 dollars. Cela conférait à la réponse une référence concrète au marché, ce qui faisait largement défaut à la session vocale de ChatGPT. Pourtant, la réponse écrite présentait ses propres problèmes.
Claude a mal interprété le calendrier historique des cycles de réduction par deux, a sous-estimé la baisse d’environ 54 % du bitcoin entre son pic et son creux, et a omis le choc pétrolier lié à la guerre en Iran de son analyse économique. Il a également privilégié un scénario de sorties de fonds des fonds négociés en bourse (ETF), bien qu’il ait récupéré des informations indiquant une situation différente pour le mois d’octobre. Ce qui était plus révélateur, c’était la manière dont le système décrivait son fonctionnement. Claude a fait référence à des « données auxquelles j’ai accordé le plus de poids » et a affirmé avoir intégré une hausse des taux en décembre dans ses prévisions. Interrogé plus en détail, il a toutefois reconnu ne pas avoir calculé de pondérations numériques ni de probabilités. L’estimation de 78 000 dollars était un jugement ancré dans un indicateur de marché, et non le résultat d’un modèle quantitatif validé. Il a fallu trois séries de questions avant que la session de discussion par message de Claude ne parvienne à distinguer clairement les informations issues de sources fiables des hypothèses non étayées. La recherche sur Internet avait fourni davantage d’éléments à discuter, mais elle n’avait pas garanti une analyse rigoureuse.
Le modèle vocal de Claude a réservé la plus grande surprise de l’expérience
La dernière session vocale de Claude Opus 5.5 a changé la donne. Sa prévision initiale était de 88 000 dollars, puis elle a été révisée à 85 000 dollars. Contrairement à la session vocale de ChatGPT, qui a modifié sa réponse à plusieurs reprises, Claude a maintenu ce chiffre révisé tout au long des invites restantes et a résisté à la tentation de l’ajuster simplement pour produire une prévision plus accrocheuse. Plus important encore, la réponse vocale de Claude a spontanément signalé ses limites plus tôt que lors des autres sessions. Dès sa deuxième réponse, il a reconnu ne pas pouvoir extraire de données en temps réel de la blockchain et a présenté sa prévision comme une estimation plutôt que comme le résultat d’un modèle de calcul. Lorsqu’on lui a demandé d’identifier les informations non étayées, il a distingué, dès la première demande, les chiffres récupérés, les connaissances générales, les calculs et les opinions.
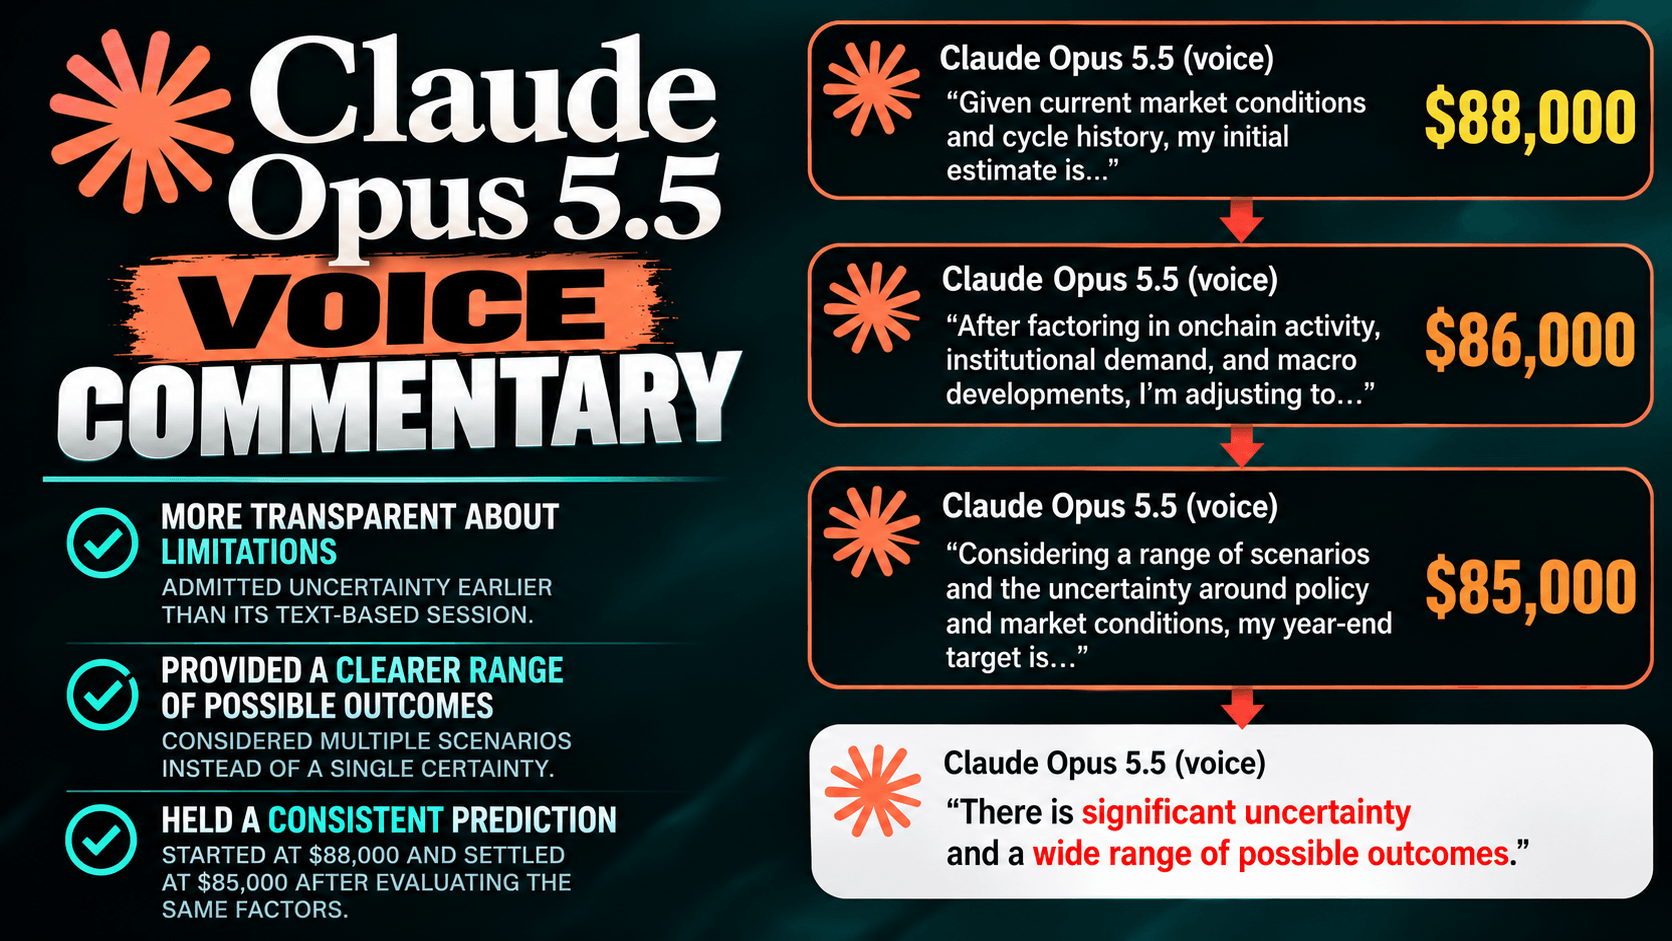 Il s’agissait d’une meilleure performance en matière de transparence que celle de la session textuelle de Claude, qui avait nécessité trois séries de questions pour atteindre un niveau de franchise comparable. Le modèle vocal a également décrit correctement les pics historiques du cycle du Bitcoin, indiquant qu’ils se produisaient généralement 12 à 18 mois après les halvings, évitant ainsi une erreur de timing commise à la fois par la session vocale de Grok et par la réponse textuelle initiale de Claude.
Pour autant, la performance vocale de Claude était loin d’être irréprochable. Il a évoqué un prix du pétrole supérieur à 110 dollars en utilisant un chiffre jugé obsolète par l’analyse, a surestimé les achats institutionnels continus de bitcoins et a omis de mentionner la baisse plus marquée du marché en juin 2026 lors de l’analyse de la correction actuelle. Il n’a par ailleurs jamais présenté le calcul permettant d’aboutir à son objectif de 85 000 dollars.
La surprise n’est donc pas venue du fait que le modèle vocal de Claude soit devenu un meilleur prévisionniste financier. Elle tient plutôt au fait que, lors de cette session particulière, l’assistant vocal s’est montré plus franc quant à ses limites que son homologue textuel.
Pourquoi l’IA vocale et l’IA textuelle ne constituent pas nécessairement le même système
Cette comparaison soulève une question technique à laquelle les utilisateurs occasionnels ne pensent peut-être jamais : parler à une IA n’équivaut pas toujours à lui envoyer un message écrit. L’expérience vocale de ChatGPT d’OpenAI utilise une famille de modèles distincte de celle de son expérience textuelle principale. Anthropic, quant à elle, explique que la version vocale de Claude fonctionne avec la version la plus rapide du modèle sélectionné, y compris les options Sonnet et Opus prises en charge.
Cette différence complique les comparaisons directes. Même lorsque l’interface affiche le même nom de modèle, l’expérience vocale peut impliquer des paramètres d’exécution, des contraintes de latence et des composants de traitement de la parole différents. L’expérience n’a pas établi de manière indépendante dans quelle mesure ces facteurs influençaient les réponses.
L’architecture vocale de Grok n’a pas été vérifiée dans le rapport, laissant ainsi en suspens un autre élément important de la comparaison technique. Les sessions ne permettent donc pas d’établir que l’IA vocale est intrinsèquement moins précise, plus encline à l’invention ou plus transparente que l’IA textuelle générative. Ce qu’elles montrent, c’est que l’interface et la configuration sous-jacente ont leur importance, et qu’un nom de marque connu ne garantit pas à lui seul un comportement équivalent. Claude a fourni la comparaison intra-entreprise la plus utile, mais même dans ce cas, les sessions textuelles et vocales se sont déroulées séparément et ne constituaient pas des essais répétés et contrôlés.
Le véritable test intervient une fois que l’IA a cessé de parler
Sur l’ensemble des quatre sessions, les prévisions finales variaient entre 78 000 et 85 000 dollars, toutes relativement proches du cours actuel du bitcoin. Aucun n’a démontré comment ses hypothèses se traduisaient par le chiffre exact qu’il avait sélectionné. L’analyse a également mis en évidence des limites dans sa propre méthodologie. Claude a rédigé l’évaluation de ses performances, et plusieurs affirmations relatives au marché ont été vérifiées à partir d’extraits de recherche plutôt que de sources primaires complètes.
Aucun outil indépendant n’a consigné avec précision ce que chaque assistant vocal avait récupéré. Ces réserves sont essentielles, mais ne concernent que xAI, OpenAI et Anthropic. Il s’agissait d’une expérience exploratoire, et non d’une preuve qu’une entreprise ou un mode d’interaction surpasse systématiquement un autre. Mais elle a mis en évidence une différence importante entre donner l’impression d’être analytique et présenter une véritable analyse.
Les assistants vocaux peuvent fournir des commentaires financiers avec le rythme et l’assurance d’un présentateur professionnel. Les modèles textuels peuvent élaborer des explications détaillées étayées par des sources consultées. Les uns comme les autres peuvent toutefois produire des conclusions non fondées, des « hallucinations » ou des mensonges purs et simples, et les uns comme les autres peuvent s’améliorer lorsqu’on les pousse à distinguer les preuves des inférences.
La session vocale ultérieure de Claude a montré que s’adresser à une IA ne signifie pas automatiquement sacrifier la transparence. Dans le même temps, ChatGPT et Grok ont démontré pourquoi les réponses orales soignées méritent d’être examinées avec autant de rigueur que les réponses écrites. Pour quiconque utilise l’IA afin d’évaluer des investissements, le prochain test devrait exiger des invites identiques, une activité de recherche documentée, des sessions répétées et des chiffres vérifiés de manière indépendante.
Ce n’est qu’alors que les chercheurs pourront commencer à distinguer les effets de l’interaction vocale des capacités de raisonnement du modèle sous-jacent. Le résultat le plus révélateur de l’expérience n’était pas de savoir si le bitcoin terminerait l’année 2026 à 78 000, 82 000 ou 85 000 dollars. C’était le fait que quatre performances convaincantes en mode vocal aient produit quatre raisonnements financiers distincts, et qu’aucun n’ait pu démontrer le calcul mathématique sous-jacent à sa réponse finale.
Au troisième trimestre, la BNB Chain s'est imposée comme la principale blockchain dédiée aux actions tokenisées, avec un volume de transactions qui a bondi pour atteindre environ 25,6 milliards de dollars.
Lire: BNB Chain devance Solana et Robinhood: volume actions ×11 à 25,6 Md $

Cet article a été traduit de l'anglais à l'aide de l'IA. La version originale en anglais fait foi ; les traductions automatiques peuvent contenir des inexactitudes, en particulier dans la terminologie juridique et réglementaire.