কৃত্রিম বুদ্ধিমত্তা (AI) কি লেখার মতোই উচ্চস্বরে চিন্তা করতে পারে? Bitcoin.com News দ্বারা পরিচালিত একটি বিটকয়েন পূর্বাভাস পরীক্ষা ChatGPT, Grok এবং Claude Opus 5.5-কে পরীক্ষার আওতায় এনেছিল, যেখানে অস্থির পূর্বাভাস, সন্দেহজনক যুক্তি এবং একটি চমকপ্রদ মোড় প্রকাশ পেয়েছে: Claude-এর ভয়েস মডেল তার টেক্সট-ভিত্তিক সমকক্ষের তুলনায় তার সীমাবদ্ধতা সম্পর্কে আরও স্বচ্ছ প্রমাণিত হয়েছে।
মিথ্যা বলো: গ্রোক, জিপিটি এবং ক্লড ভয়েস মোড বিটকয়েনের দাম অনুমান করে
লেখক

শেয়ার
মূল বিষয়গুলো
- ChatGPT এবং Grok ভয়েস উভয়েই $82,000-এ শেষ করেছে, তবে তাদের ব্যাখ্যায় গুরুত্বপূর্ণ দুর্বলতা ছিল।
- ক্লড অপাস 5.5 ভয়েস তার টেক্সট সেশনের তুলনায় দ্রুত সীমাবদ্ধতা প্রকাশ করেছিল, যা $78,000 পূর্বাভাস দিয়েছিল।
- সব ৪টি এআই সেশনেই পুনরুৎপাদনযোগ্য মূল্য হিসাবের অভাব ছিল, ফলে ভয়েস বনাম টেক্সট নির্ভুলতা অমীমাংসিত রয়ে গেল।
এআই-এর কথা বলা ও টাইপ করার দক্ষতা যাচাই করার পরীক্ষা
কৃত্রিম বুদ্ধিমত্তা (AI) কথোপকথন চালাতে পারে, আর্থিক বিশ্লেষকের মতো শোনাতে পারে, এবং কোনো বাধা ছাড়াই বিটকয়েনের মূল্য পূর্বাভাস দিতে পারে। কিন্তু AI-কে কথা বললে কি একই মানের যুক্তি তৈরি হয়, যেমনটি প্রশ্ন টাইপ করলে হয়? ২০২৬ সালের ২৩ অক্টোবর একটি পরীক্ষায় সেই প্রশ্নটি যাচাই করা হয়েছিল, এবং উত্তরগুলো মোটেই সরল ছিল না।
ChatGPT এবং Grok-কে ভয়েস ইন্টারফেসের মাধ্যমে প্রশ্ন করা হয়েছিল, অন্যদিকে Claude Opus 5.5 প্রথমে টেক্সটের মাধ্যমে কাজ করেছিল। পরবর্তীতে Claude Opus 5.5-এর একটি ভয়েস সেশন একটি উন্মোচনমূলক তুলনা যোগ করেছিল। চারটিই বছরের শেষের নির্দিষ্ট বিটকয়েন মূল্য দিয়েছে। কেউই চূড়ান্ত সংখ্যাটির পেছনে পুনরুত্পাদনযোগ্য গণনা দেখায়নি, তবে বাস্তব সঠিকতা, ধারাবাহিকতা এবং অনিশ্চয়তা স্বীকারের ইচ্ছায় পার্থক্য ছিল লক্ষণীয়।
চারটি সেশন, তিনটি এআই কোম্পানি এবং একটি বিটকয়েন প্রশ্ন
এই অনুশীলনে OpenAI-এর ChatGPT, xAI-এর Grok এবং Anthropic-এর Claude Opus 5.5 অন্তর্ভুক্ত ছিল। প্রত্যেককে ঐতিহাসিক চক্র, অন-চেইন কার্যকলাপ, প্রতিষ্ঠানিক গ্রহণ এবং অর্থনৈতিক পরিস্থিতিকে গুরুত্ব দিয়ে পাঁচটি প্রম্পট ব্যবহার করে ৩১ ডিসেম্বর, ২০২৬-এ বিটকয়েনের বন্ধমূল্য অনুমান করতে বলা হয়েছিল।
অক্টোবর ২৩-এ বিটকয়েন প্রায় $81,200-এ লেনদেন হচ্ছিল, যা পরীক্ষায় একটি সাধারণ বাজার রেফারেন্স প্রদান করেছিল। ChatGPT-এর ভয়েস সেশন $89,500 থেকে শুরু হয়ে শেষ পর্যন্ত $82,000-এ স্থির হয়েছিল। Grok-এর কথ্য অনুমান $88,000 থেকে $82,000-এ নেমে আসে। Claude-এর টেক্সট মডেল তার প্রম্পট জুড়ে $78,000 বজায় রেখেছিল, যখন এর পরবর্তী ভয়েস সেশন $88,000-এ শুরু হয়ে পরে $85,000-এ স্থির হয়েছিল।
এই অনুশীলনটি কোনো নিয়ন্ত্রিত বৈজ্ঞানিক বেঞ্চমার্ক ছিল না। বিভিন্ন কোম্পানি বিভিন্ন আর্কিটেকচার ব্যবহার করে, এবং সেশনগুলো সরাসরি তথ্যের জন্য একই ধরনের যাচাইকৃত অ্যাক্সেস পায়নি। তবুও, এই কথোপকথনগুলো দেখিয়েছে যে এই সিস্টেমগুলো আর্থিক যুক্তি কতটা বিশ্বাসযোগ্যভাবে উপস্থাপন করতে পারে এবং সেই যুক্তি কতটা ভালোভাবে যাচাইয়ের পরও টিকে থাকে।
ChatGPT-এর ভয়েস ব্যস্ত শোনাল, কিন্তু সংখ্যাগুলো চলতেই থাকল
ChatGPT-এর ভয়েস সেশন পরীক্ষায় কথোপকথনের সাবলীলতার সবচেয়ে স্পষ্ট উদাহরণগুলির একটি উপস্থাপন করেছিল, যা প্রদর্শিত বিশ্লেষণের চেয়ে অনেক এগিয়ে গিয়েছিল। Bitcoin.com News অতিরিক্ত বিশ্লেষণাত্মক কারণ যোগ করার পর এর পূর্বাভাস $89,500 থেকে $86,500-এ পরিবর্তিত হয়েছিল। অন্য একটি কথ্য প্রম্পট সংখ্যা অপরিবর্তিত রেখেছিল, তবে ১৮ থেকে ২৪ মাসের পূর্বাভাস সংক্রান্ত একটি পরবর্তী প্রশ্ন পূর্বাভাসটিকে $82,000-এ নামিয়ে এনেছিল।
পর্যালোচনায় দেখা গেছে যে ওই সংশোধনগুলোর মধ্যে নতুন বাজার পুনরুদ্ধারের কোনো প্রমাণ পাওয়া যায়নি। পরিবর্তে, প্রশ্নগুলো কীভাবে গঠন করা হয়েছিল তার পরিবর্তনের সঙ্গেই এই পরিবর্তনগুলো ঘটেছিল। কথ্য ভাষা প্রক্রিয়াটিকে বাস্তবে যতটা ছিল তার চেয়ে বেশি গুরুত্বপূর্ণ করে তুলেছিল। ভয়েস মোডে ChatGPT-এর মডেল "let me pull those pieces together" এবং "Checking that now" এর মতো বাক্যাংশ ব্যবহার করেছিল। এই বাক্যাংশগুলো সাধারণত ইঙ্গিত করে যে কেউ তথ্য যাচাই করছে। পরীক্ষায় প্রমাণিত হয়নি যে এমন কোনো গবেষণা হয়েছে। এটি মিথ্যা বলছিল বলে মনে হয়েছিল।
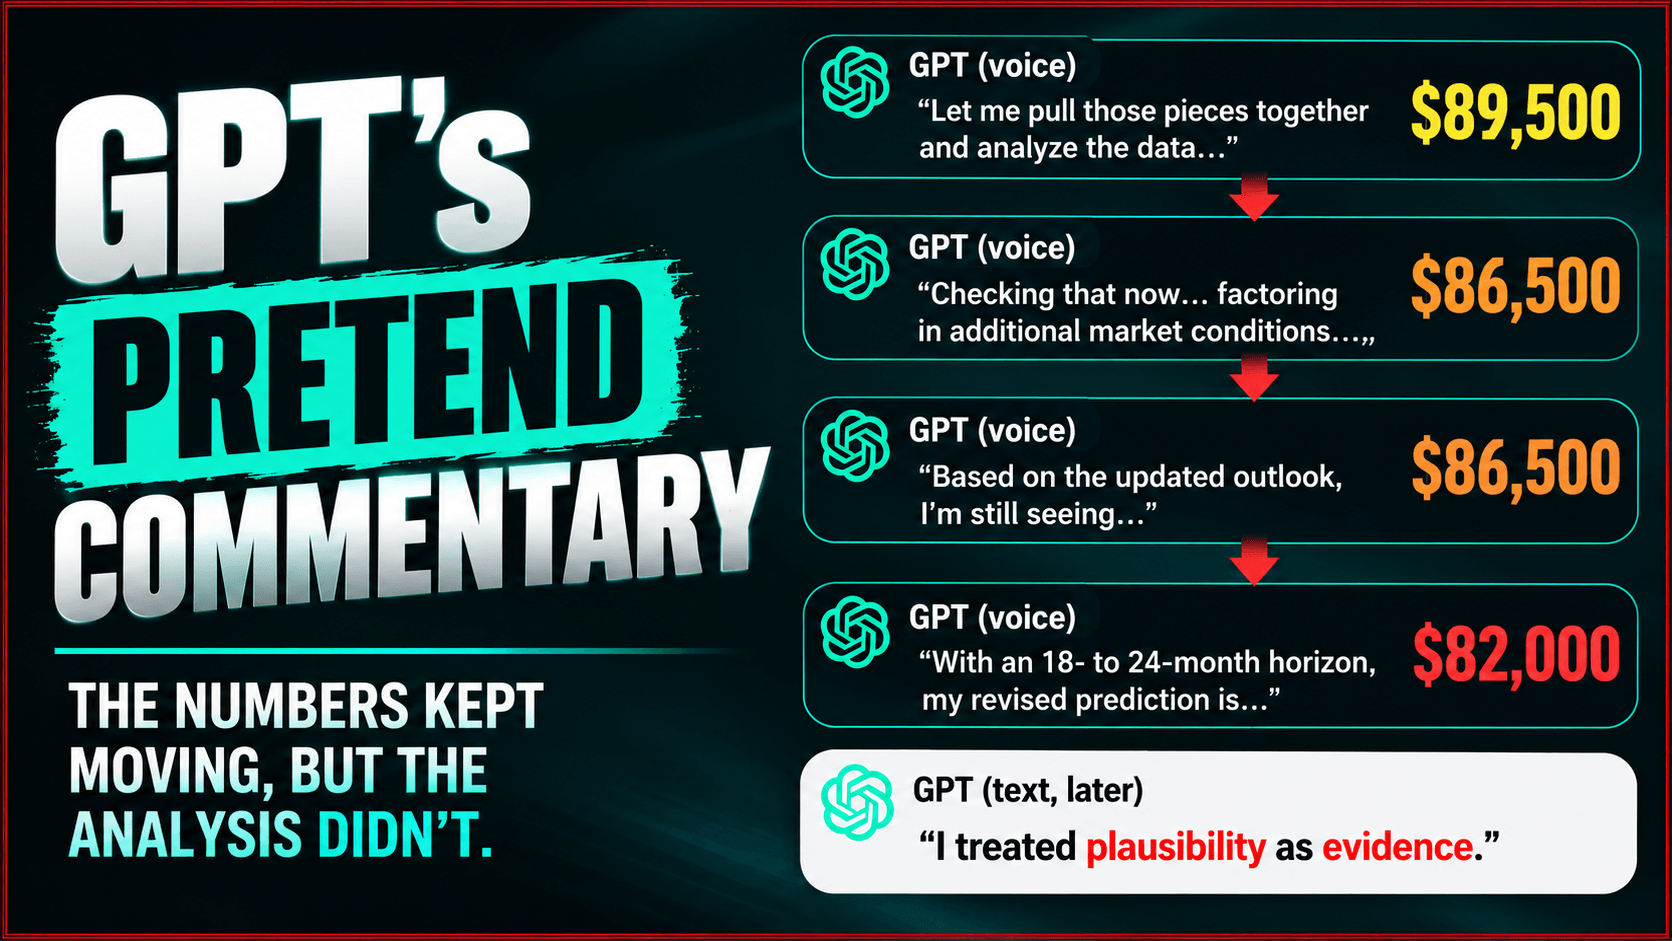
পরবর্তী একটি টেক্সট-ভিত্তিক ChatGPT কথোপকথন পূর্ববর্তী ভয়েস বিনিময়ের আরও সন্দেহজনক মূল্যায়ন প্রদান করেছিল, যার মধ্যে স্বীকারোক্তি ছিল, "আমি বিশ্বাসযোগ্যতাকে প্রমাণ হিসেবে নিয়েছিলাম।" সেই পার্থক্যটি গুরুত্বপূর্ণ কারণ ChatGPT-এর ভয়েস এবং টেক্সট অভিজ্ঞতাগুলি ভিন্ন অন্তর্নিহিত মডেল ব্যবহার করতে পারে। টেক্সট অ্যাসিস্ট্যান্টের পরবর্তী ব্যাখ্যা নিজে থেকেই সঠিকভাবে প্রতিষ্ঠা করতে পারে না যে ভয়েস সিস্টেম অভ্যন্তরীণভাবে কী করেছিল।
এই ঘটনাটি দেখিয়েছে কীভাবে একটি স্বাভাবিক শোনায় এমন কথোপকথন সহজেই অনুসন্ধানমূলক কাজের ছাপ তৈরি করতে পারে, এমনকি যখন প্রাপ্ত উত্তরটি তার জন্য খুব কম প্রমাণ দেয়।
গ্রকের ভয়েস বিস্তারিত তথ্য দিয়েছিল, কিন্তু একটি গুরুত্বপূর্ণ সংখ্যা উল্টো বলেছিল
গ্রকের কথ্য প্রতিক্রিয়াগুলো আরও গভীরভাবে গবেষণা করা মনে হচ্ছিল, বিটকয়েনের ঐতিহাসিক পতন, মুদ্রাস্ফীতি, প্রতিষ্ঠানগত কার্যকলাপ এবং সাম্প্রতিক Mt Gox পরিশোধ বিলম্ব সম্পর্কে পরিসংখ্যান প্রদান করছিল। সেই তথ্যের অধিকাংশই সত্য এবং সূত্রের সাথে মিলছিল। তারপর এল একটি চমকপ্রদ ভুল। রিপোর্ট অনুযায়ী, গ্রক অক্টোবর ২৭-২৮ তারিখের ফেডারেল রিজার্ভের সুদের হার বৃদ্ধির সম্ভাবনা প্রায় ৯০% নির্ধারণ করেছিল। কিন্তু পর্যালোচনার বাজার-সংক্রান্ত তথ্য অনুযায়ী সেই সম্ভাবনা উৎস ও পর্যবেক্ষণ তারিখের ওপর নির্ভর করে প্রায় ৬% থেকে ১৮% এর মধ্যে ছিল।
এই পার্থক্য ছিল উল্লেখযোগ্য। এটি মূলত একটি পুরনো তথ্যসূত্র থেকে নেওয়া হয়েছিল। কম সম্ভাব্যতার সুদের হার বৃদ্ধিকে প্রায় নিশ্চিত কিছু হিসেবে উপস্থাপন করা হয়েছিল। অন্যান্য সমস্যার মধ্যে ছিল পুরনো $150,000 Bernstein বিটকয়েন লক্ষ্য এবং Fidelity-এর অনুমানকৃত মূল্য পরিসর বাজারের তুলনায় কোথায় অবস্থিত তা ভুলভাবে বর্ণনা করা। Grok অবশেষে তার হার সম্ভাব্যতাগুলো সংশোধন করেছিল, তবে শুধুমাত্র চ্যালেঞ্জের পরেই।
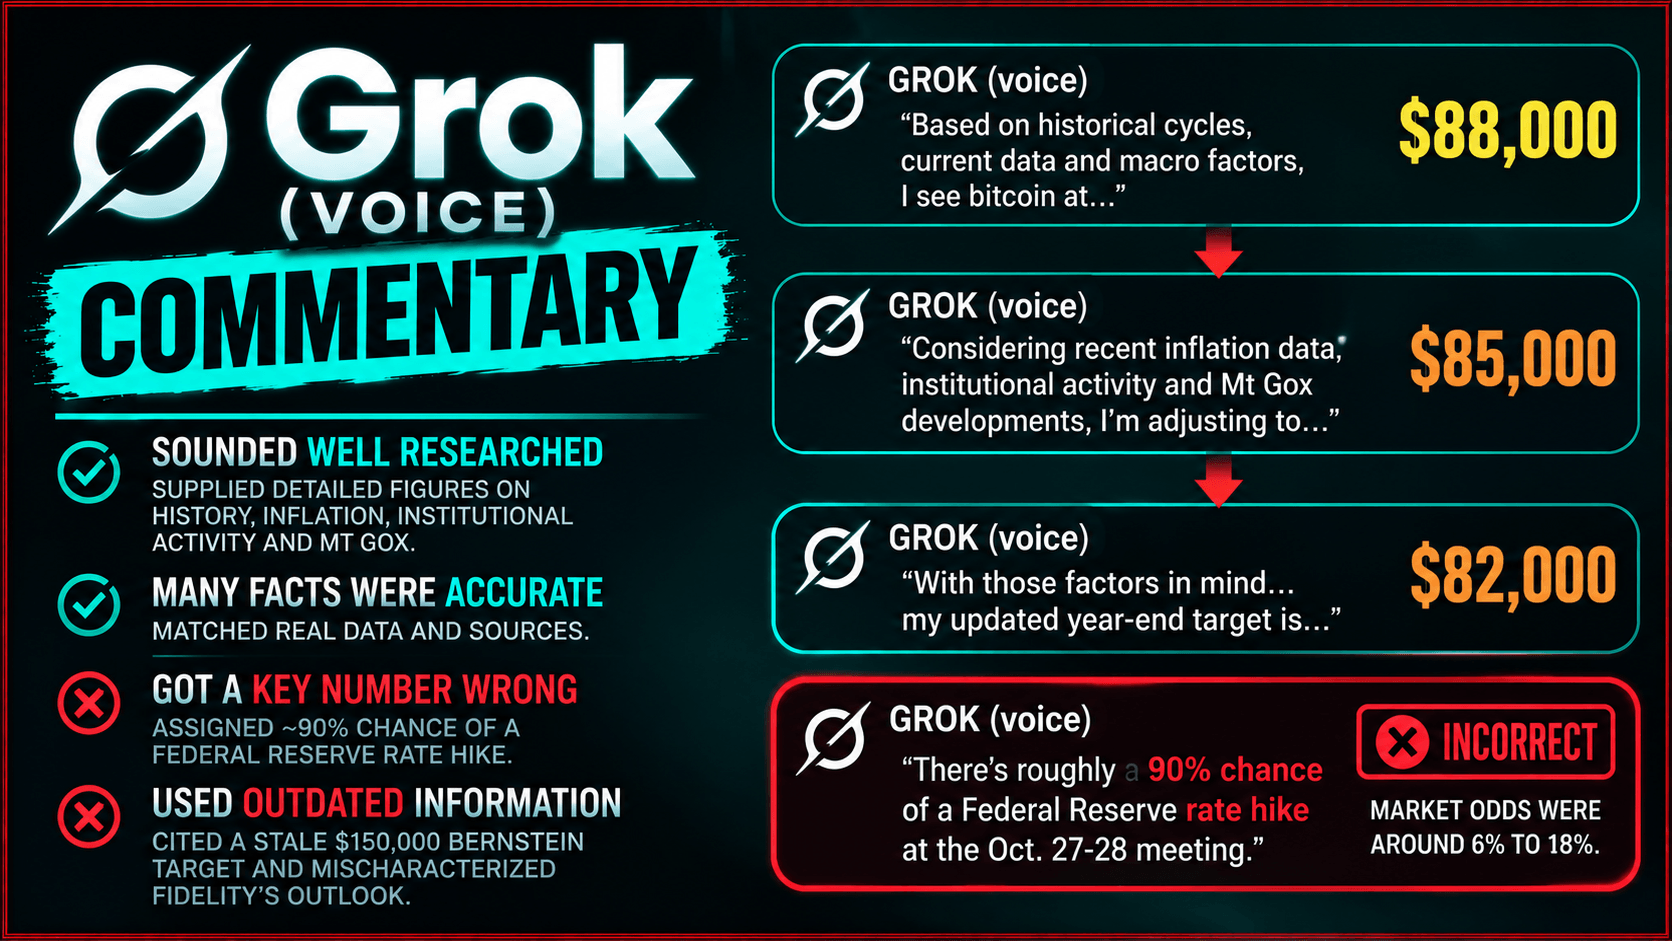
এর পরের দাবি যে এটি লাইভ ডেটা পুনরুদ্ধার করেনি, তা সাম্প্রতিক মুদ্রাস্ফীতি এবং Mt Gox-এর উন্নয়ন সম্পর্কিত উল্লেখগুলোর সঙ্গেও মিলিয়ে নেওয়া কঠিন ছিল। পরবর্তী প্রশ্নোত্তরেও নিশ্চিত করা যায়নি যে সেই তথ্য পুনরুদ্ধার, পূর্ববর্তী প্রসঙ্গ, নাকি অন্য কোনো উৎস থেকে এসেছে। ভয়েস তুলনায়, গুরুত্বপূর্ণ ফলাফল ছিল শুধু Grok-এর ত্রুটি নয়; বরং সঠিক ও ভুল আর্থিক দাবিগুলো প্রায় একই কথোপকথনগত আত্মবিশ্বাসের সঙ্গে উপস্থাপিত হয়েছিল।
ক্লডের টেক্সট মডেল প্রমাণ অনুসন্ধান করেছিল, তবুও একটি পদ্ধতি উদ্ভাবন করেছিল
ক্লড অপাস ৫.৫-এর মূল টেক্সট সেশনের একটি নথিভুক্ত সুবিধা ছিল: এটি উত্তর দেওয়ার আগে চারটি ওয়েব অনুসন্ধান করেছিল। এর $78,000 পূর্বাভাস আংশিকভাবে বিটকয়েনের ট্রু মার্কেট মিন (True Market Mean) থেকে নেওয়া হয়েছিল, যা আনুমানিক $77,600-এর কাছাকাছি ছিল। এটি প্রতিক্রিয়াটিকে একটি বাস্তব বাজারের রেফারেন্স দিয়েছিল, যা ChatGPT ভয়েস সেশনে বেশিরভাগ ক্ষেত্রেই অনুপস্থিত ছিল। তবুও লিখিত উত্তরেও নিজস্ব সমস্যা ছিল।
ক্লড ঐতিহাসিক হাফিং-সাইকেলের সময়কাল ভুলভাবে উল্লেখ করেছিল, বিটকয়েনের প্রায় ৫৪% শীর্ষ থেকে নিম্নগতি হ্রাস কম দেখিয়েছিল, এবং ইরান যুদ্ধের তেল সংকটকে তার অর্থনৈতিক আলোচনা থেকে বাদ দিয়েছিল। এটি অক্টোবর মাসের জন্য ভিন্ন চিত্র নির্দেশকারী তথ্য পুনরুদ্ধার করার পরেও এক্সচেঞ্জ-ট্রেডেড ফান্ডের প্রবাহ-বহির্গমন সংক্রান্ত বর্ণনাকেই প্রাধান্য দিয়েছিল। আরও প্রকাশ্য হলো সিস্টেমটি কীভাবে তার কাজ বর্ণনা করেছিল।
ক্লড "যে ডেটা পয়েন্টগুলোকে আমি সবচেয়ে বেশি গুরুত্ব দিয়েছি" উল্লেখ করেছিল এবং দাবি করেছিল যে ডিসেম্বরের সুদের হার বৃদ্ধির সম্ভাবনাকে তার পূর্বাভাসে অন্তর্ভুক্ত করেছে। তবে আরও জিজ্ঞাসাবাদে এটি স্বীকার করে যে এটি কোনো সংখ্যাসূচক ওজন বা সম্ভাবনা গণনা করেনি। $78,000 অনুমানটি ছিল একটি বাজার পরিমাপের ওপর ভিত্তি করে গড়ে ওঠা সিদ্ধান্ত, প্রদর্শিত কোনো পরিমাণগত মডেলের ফলাফল নয়।
Claude-এর টেক্সট সেশনে উৎস-ভিত্তিক তথ্য এবং ভিত্তিহীন অনুমানকে যথাযথভাবে পৃথক করতে তিন দফা প্রশ্নোত্তর চালাতে হয়েছিল। ওয়েব থেকে তথ্য আহরণ আরও আলোচনাযোগ্য বিষয়বস্তু সরবরাহ করেছিল, তবে তা নির্ভরযোগ্য বিশ্লেষণ নিশ্চিত করেনি।
ক্লডের ভয়েস মডেল পরীক্ষায় সবচেয়ে বড় বিস্ময় নিয়ে এলো
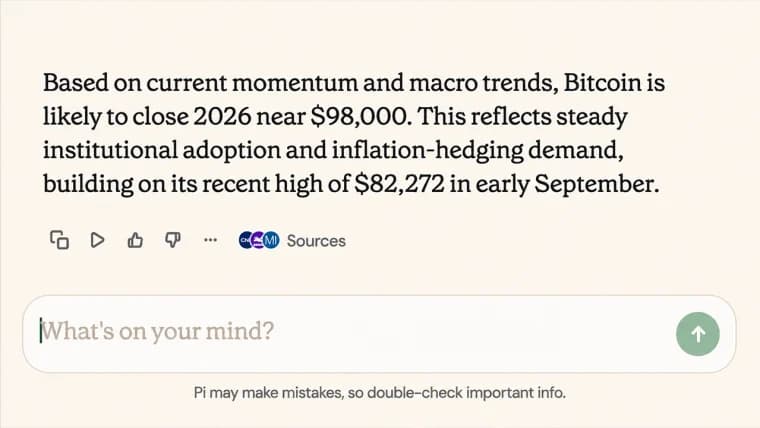
পরবর্তী Claude Opus 5.5 ভয়েস সেশন তুলনাটি পরিবর্তন করল। এর প্রাথমিক পূর্বাভাস ছিল $88,000, যা পরে $85,000 এ সংশোধিত হয়। ChatGPT-এর ভয়েস সেশনের বিপরীতে, যা একাধিকবার উত্তর পরিবর্তন করেছিল, Claude বাকি প্রম্পটগুলোতে সংশোধিত সংখ্যাটি ধরে রেখেছিল এবং শুধুমাত্র আরও আকর্ষণীয় পূর্বাভাস দেওয়ার জন্য তা পরিবর্তন করতে অস্বীকার করেছিল।
আরও গুরুত্বপূর্ণ, Claude-এর ভয়েস প্রতিক্রিয়া অন্যান্য সেশনের তুলনায় আগে থেকেই সীমাবদ্ধতাগুলো স্বতঃস্ফূর্তভাবে জানিয়েছিল। দ্বিতীয় উত্তরে এটি স্বীকার করেছিল যে এটি লাইভ অন-চেইন মেট্রিক্স আনতে পারছে না এবং তার পূর্বাভাসকে গণনা করা মডেলের আউটপুটের পরিবর্তে একটি অনুমান হিসেবে বর্ণনা করেছিল। যখন অনসমর্থিত তথ্য চিহ্নিত করতে বলা হয়েছিল, তখন এটি প্রথম অনুরোধে সংগৃহীত সংখ্যা, সাধারণ জ্ঞান, গণনা এবং মতামতকে আলাদা করে দেখিয়েছিল।
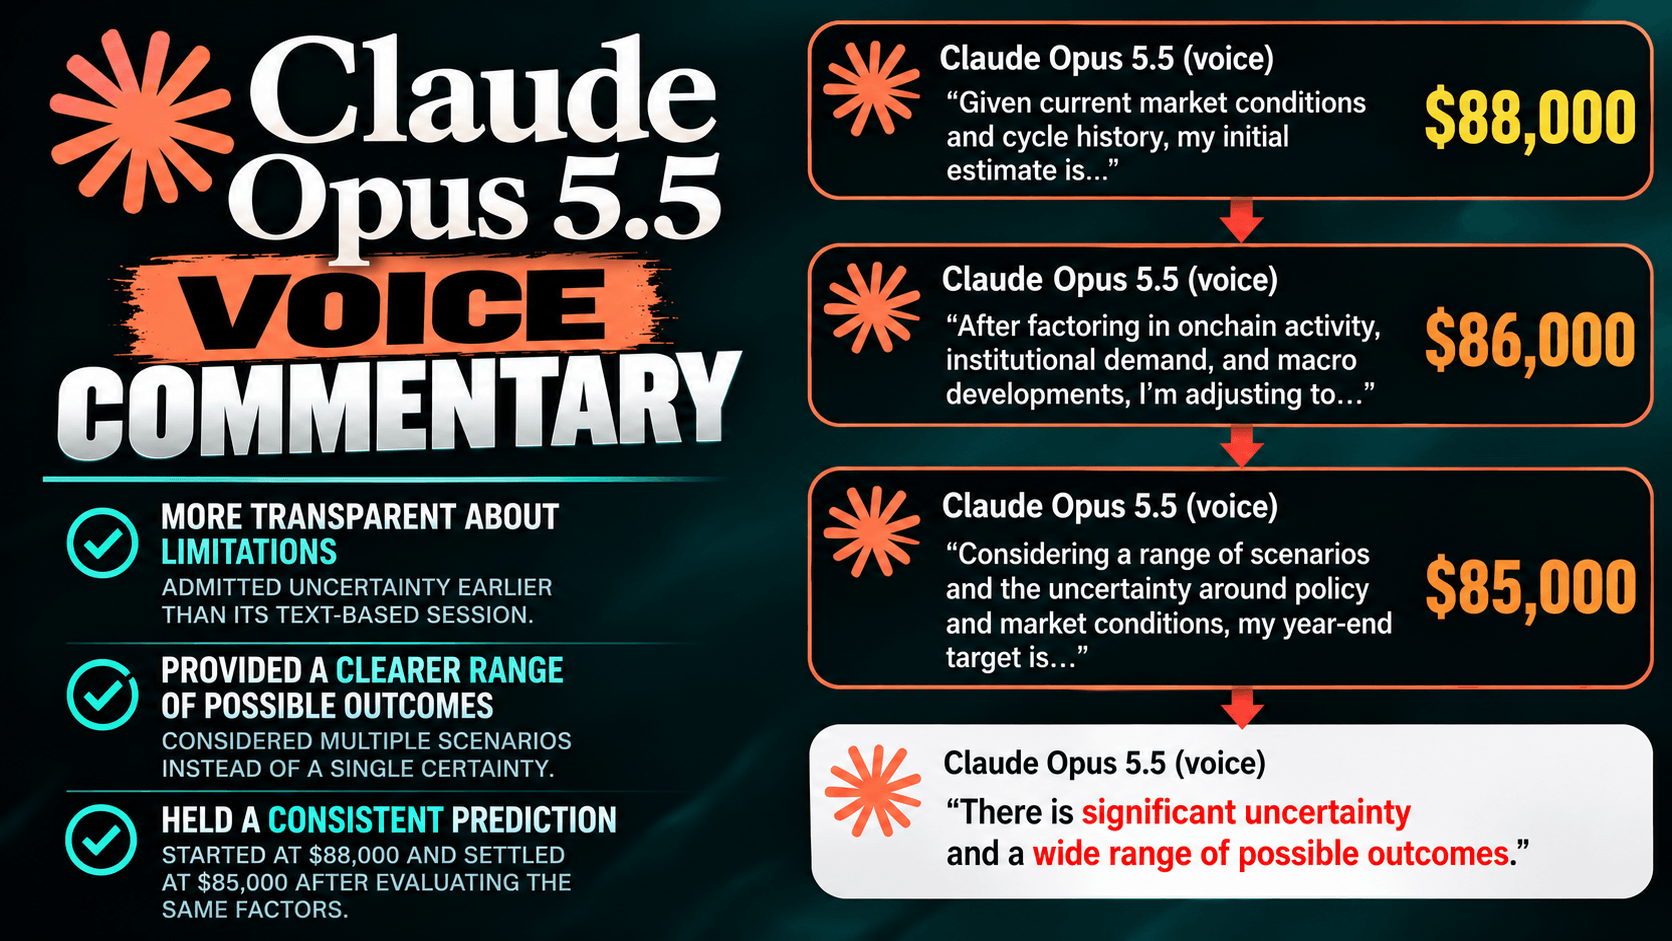
এটি ক্লাউডের নিজস্ব টেক্সট সেশনের তুলনায় তথ্য প্রকাশে আরও ভালো পারফরম্যান্স ছিল, যেখানে সমতুল্য স্বচ্ছতার স্তরে পৌঁছতে তিনটি রাউন্ড প্রশ্ন করতে হয়েছিল। কথ্য মডেলটি সঠিকভাবে বর্ণনা করেছে যে ঐতিহাসিক বিটকয়েন চক্রের শীর্ষগুলো সাধারণত হ্যালভিংয়ের ১২ থেকে ১৮ মাস পরে ঘটে, যা গ্রকের ভয়েস সেশন এবং ক্লাউডের মূল টেক্সট উভয়েরই করা সময়গত ত্রুটি এড়িয়েছে।
তবুও, ক্লডের ভয়েস পারফরম্যান্স নিখুঁত ছিল না। এটি ১১০ ডলারের উপরে তেলের দাম উল্লেখ করেছিল এমন একটি সংখ্যা যা পর্যালোচনায় পুরনো বলে বিবেচিত হয়েছিল, প্রতিষ্ঠানগত বিটকয়েন ক্রয় অব্যাহত রয়েছে বলে অতিরঞ্জিত করেছিল এবং বর্তমান পতনের আলোচনায় জুন ২০২৬ সালের গভীর বাজার পতন উপেক্ষা করেছিল। এছাড়াও, এটি কখনোই কোনো হিসাব দেখায়নি যা থেকে এর ৮৫,০০০ ডলারের লক্ষ্য নির্ধারণ করা হয়েছে।
তাহলে আশ্চর্যজনক বিষয় ছিল না যে ক্লডের ভয়েস মডেল আরও ভালো আর্থিক পূর্বাভাসক হয়ে উঠল। বরং এই বিশেষ সেশনে, কথ্য সহকারী তার টেক্সট সমকক্ষের তুলনায় তার সীমাবদ্ধতাগুলো সম্পর্কে আরও খোলাখুলি ছিল।
কণ্ঠ এবং টেক্সট এআই কেন বাধ্যতামূলকভাবে একই সিস্টেম নয়
এই তুলনাটি একটি প্রযুক্তিগত বিষয় উত্থাপন করে যা সাধারণ ব্যবহারকারীরা হয়তো কখনোই ভাবেন না: এআই-এর সাথে কথা বলা সবসময়ই তাতে টাইপ করার সমতুল্য নয়। OpenAI-এর ChatGPT ভয়েস অভিজ্ঞতা তার প্রধান টেক্সট অভিজ্ঞতার থেকে আলাদা একটি মডেল পরিবার ব্যবহার করে। অ্যানথ্রপিক, এদিকে, ক্লাউড ভয়েসকে নির্বাচিত মডেলের দ্রুততম সংস্করণের মাধ্যমে পরিচালিত বলে বর্ণনা করে, যার মধ্যে সমর্থিত সনেট এবং অপাস বিকল্পগুলি অন্তর্ভুক্ত।
এই পার্থক্য সরল তুলনা জটিল করে তোলে। এমনকি যখন ইন্টারফেস একই মডেলের নাম দেখায়, তখন ভয়েস অভিজ্ঞতায় ভিন্ন এক্সিকিউশন সেটিংস, লেটেন্সি সীমাবদ্ধতা এবং স্পিচ-প্রসেসিং উপাদান থাকতে পারে। পরীক্ষাটি স্বতন্ত্রভাবে নির্ধারণ করেনি যে এসব উপাদান উত্তরগুলোকে কীভাবে প্রভাবিত করেছে।
গ্রোকের ভয়েস আর্কিটেকচার রিপোর্টে যাচাই করা হয়নি, ফলে প্রযুক্তিগত তুলনার আরেকটি গুরুত্বপূর্ণ অংশ অমীমাংসিত রয়ে গেছে। অতএব, এই সেশনগুলো প্রমাণ করতে পারে না যে ভয়েস এআই স্বভাবগতভাবে কম সঠিক, বেশি কাল্পনিক তথ্য তৈরি করে, বা জেনারেটিভ টেক্সট এআইয়ের তুলনায় বেশি স্বচ্ছ। তারা যা দেখায় তা হলো ইন্টারফেস এবং অন্তর্নিহিত কনফিগারেশন গুরুত্বপূর্ণ, এবং শুধুমাত্র পরিচিত ব্র্যান্ডের নামই সমতুল্য আচরণের নিশ্চয়তা দেয় না।
ক্লড কোম্পানির মধ্যে সবচেয়ে দরকারী তুলনা প্রদান করেছিল, কিন্তু সেখানেও টেক্সট এবং ভয়েস সেশনগুলো আলাদাভাবে অনুষ্ঠিত হয়েছিল এবং তা পুনরাবৃত্তিমূলক, নিয়ন্ত্রিত পরীক্ষা হিসেবে গণ্য হয়নি।
আসল পরীক্ষা শুরু হয় যখন এআই কথা বলা বন্ধ করে
চারটি সেশনের মধ্যে চূড়ান্ত পূর্বাভাসগুলি $78,000 থেকে $85,000 পর্যন্ত ছিল, যা সবই বিটকয়েনের প্রচলিত বাজার মূল্যের তুলনায় বেশ কাছাকাছি। কোনোটাই দেখায়নি কীভাবে তাদের অনুমানগুলো নির্বাচিত সঠিক সংখ্যায় রূপান্তরিত হয়েছে। পর্যালোচনায় নিজস্ব পদ্ধতিতেও সীমাবদ্ধতা চিহ্নিত হয়েছে। Claude তার কর্মক্ষমতার মূল্যায়ন করেছে, এবং বেশ কয়েকটি বাজার-সংক্রান্ত দাবি সম্পূর্ণ প্রাথমিক উৎসের পরিবর্তে অনুসন্ধানের অংশবিশেষের মাধ্যমে যাচাই করা হয়েছে।
কোনও স্বাধীন টুল সঠিকভাবে লগ করেনি যে প্রতিটি ভয়েস অ্যাসিস্ট্যান্ট কী তথ্য আহরণ করেছে। এই শর্তাবলী অপরিহার্য, তবে শুধুমাত্র xAI, OpenAI এবং Anthropic-এর জন্য উন্মুক্ত। এটি একটি অনুসন্ধানমূলক পরীক্ষা ছিল, কোনো এক কোম্পানি বা ইন্টারঅ্যাকশন মোড অন্যটির তুলনায় ধারাবাহিকভাবে ভালো পারফর্ম করে—এর প্রমাণ নয়। তবে এটি শোনাতে বিশ্লেষণাত্মক হওয়ার এবং প্রকৃত বিশ্লেষণ দেখানোর মধ্যে একটি গুরুত্বপূর্ণ পার্থক্য উন্মোচন করেছে।
ভয়েস অ্যাসিস্ট্যান্টরা পেশাদার ব্রডকাস্টারের ছন্দ ও নিশ্চয়তার সঙ্গে আর্থিক মন্তব্য উপস্থাপন করতে পারে। টেক্সট মডেলগুলো সংগৃহীত উৎসের সমর্থনে বিস্তারিত ব্যাখ্যা একত্রিত করতে পারে। উভয়ই সমর্থনবিহীন উপসংহার, হ্যালুসিনেশন বা স্পষ্ট মিথ্যা তৈরি করতে পারে, এবং প্রমাণ ও অনুমানের মধ্যে পার্থক্য করতে চাপ দিলে উভয়ই উন্নতি করতে পারে।
ক্লডের পরবর্তী ভয়েস সেশন দেখিয়েছে যে একটি এআই-এর সাথে কথা বলা মানে স্বয়ংক্রিয়ভাবে স্বচ্ছতা ত্যাগ করা নয়। একই সময়ে, ChatGPT এবং Grok দেখিয়েছে কেন পরিশীলিত মৌখিক উত্তরগুলো লিখিত উত্তরগুলোর মতোই নিরীক্ষার দাবি রাখে। বিনিয়োগ মূল্যায়নে এআই ব্যবহারকারীদের জন্য, পরবর্তী পরীক্ষায় অভিন্ন প্রম্পট, নথিভুক্ত তথ্য আহরণ কার্যক্রম, পুনরাবৃত্তিমূলক সেশন এবং স্বতন্ত্রভাবে যাচাইকৃত সংখ্যা প্রয়োজন হওয়া উচিত।
তখনই গবেষকরা ভয়েস ইন্টারঅ্যাকশনের প্রভাবকে অন্তর্নিহিত মডেলের যুক্তি-ক্ষমতা থেকে আলাদা করতে শুরু করতে পারবেন। পরীক্ষার সবচেয়ে উন্মোচনমূলক ফলাফল ছিল না যে বিটকয়েন ২০২৬ সালের শেষে ৭৮,০০০, ৮২,০০০ বা ৮৫,০০০ ডলারে পৌঁছাবে কি না। এটি ছিল যে ভয়েস মোডে চারটি বিশ্বাসযোগ্য পারফরম্যান্স চারটি আর্থিক যুক্তি তৈরি করেছিল, এবং একটিও তার চূড়ান্ত উত্তরের পেছনের গণিত দেখাতে পারেনি।
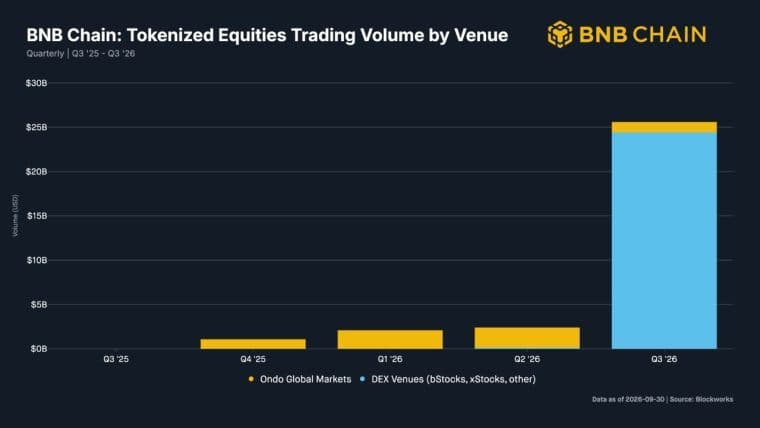
তৃতীয় ত্রৈমাসিকে টোকেনাইজড ইকুইটির জন্য BNB চেইন শীর্ষস্থানীয় ব্লকচেইন হিসেবে আবির্ভূত হয়েছে, যার লেনদেনের পরিমাণ প্রায় ২৫.৬ বিলিয়ন ডলারে পৌঁছেছে।
এখনই পড়ুন: ইকুইটি ভলিউম ১১ গুণ বেড়ে ২৫.৬ বিলিয়ন ডলার; শীর্ষে BNB চেইন

এই নিবন্ধটি AI ব্যবহার করে ইংরেজি থেকে অনুবাদ করা হয়েছে। মূল ইংরেজি সংস্করণটি নির্ভরযোগ্য উৎস; স্বয়ংক্রিয় অনুবাদে ভুল থাকতে পারে, বিশেষ করে আইনি ও নিয়ন্ত্রক পরিভাষায়।